I/O 다이어그램 1

텍스트

jina-clip-v1

벡터

I/O 다이어그램 2

이미지

jina-clip-v1

벡터

파레토 프론트
300M1B3.0B10B20406080100bge-visualized-m3BiModernVBERTDSE-Phi3dse-qwen2-2b-mrl-v1e5-vjina-clip-v2jina-embeddings-v3jina-embeddings-v4jina-embeddings-v4 (lat…llama-nemoretriever-col…MoCa-3Bnemotron-colembed-vl-8b…nllb-siglip-largeONE-PEACESauerkrautLM-ColLFM2-45…SauerkrautLM-ColMinistr…siglip-so400m-patch14-3…SigLIP2-L-512/16VLM2VecVultronRetrieverCore-Qw…VultronRetrieverFlash-Q…jina-clip-v1파라미터 수(로그)nDCG@5
이 모델
프론트에 있음
Jina AI
기타
ViDoRe v1
17.72
파라미터
223M
점수 순위
32 / 33
파레토 프론트
프론트에
값 분포
AUC 0.8440
코퍼스
번역 쌍
문서 검색
이미지 / 배너
0.6750.000.200.400.600.80
관련20.2%
하드 네거티브3.2%
무관1.2%
권장 컷오프
FPR 0.1 · 0.478
FPR 0.01 · 0.675
FPR 0.001 · 0.785
FPR 0.0001 · 0.823
균형 · 0.376
AUC
0.8440
노이즈 상한
0.779
재현율 절벽
0.123
측정 쌍 수
119 / 11k
벡터 성분
-0.18-0.010.15
σ 0.0361 · 183k 개 값
임베딩 기하 구조
0768
차원별 평균, 마우스를 올리면 범위 표시
노이즈 하한
0.283
유효 차원
55 / 768
비교할 모델을 선택하세요
논문 (1)

개요

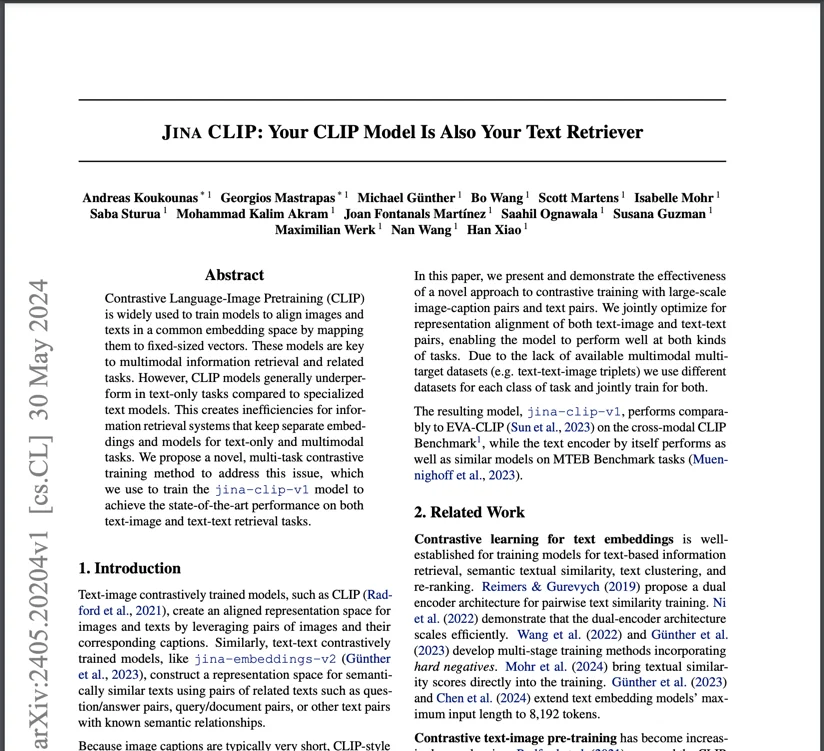
jina-clip-v1은 223M 파라미터의 멀티모달 임베딩 모델로, 텍스트-텍스트와 텍스트-이미지 검색 모두에서 SOTA 성능을 달성한 CLIP 계열 최초의 모델입니다. 크로스모달 정렬을 위해 텍스트 전용 검색을 희생하는 표준 CLIP 모델과 달리, jina-clip-v1은 멀티태스크 대비 학습으로 모든 검색 조합에서 강한 성능을 유지합니다. 12,288토큰의 텍스트 컨텍스트를 지원하며, 이는 원래 CLIP의 77토큰 한도의 약 160배입니다.

방법

아키텍처는 ALiBi로 12,288토큰을 지원하는 개조된 Jina BERT v2 텍스트 인코더와 Beijing Academy for AI의 EVA-02 이미지 인코더를 결합합니다. 핵심 혁신은 멀티태스크 대비 학습 방법입니다: 모델은 (1) 크로스모달 정렬을 위한 이미지-캡션 쌍, (2) 텍스트 전용 검색 품질을 유지하기 위한 텍스트-텍스트 쌍, (3) 다양한 텍스트 길이에 대한 강건성을 높이기 위한 이미지의 AI 생성 장문 설명을 함께 학습합니다. 마지막 단계에서는 하드 네거티브 텍스트 트리플릿을 사용해 의미 구분을 더 날카롭게 만듭니다. 이 멀티태스크 접근법은 표준 CLIP 학습을 괴롭히는 텍스트 전용 검색의 재난적 망각(catastrophic forgetting)을 막습니다. 이미지 인코더는 224×224 픽셀 타일을 처리하며, 타일 하나가 1,000토큰의 처리 용량을 차지합니다.

성능

텍스트 전용 검색에서 이 모델은 OpenAI CLIP 대비 165% 성능 향상을 달성했습니다(MTEB에서 0.429 대 0.162). 이미지 작업: 텍스트-대-이미지 검색 2% 향상(0.899), 이미지-대-텍스트 검색 6%(0.803), 이미지-대-이미지 검색 12%(0.916). 제로샷 시각 분류(CIFAR-100)에서는 표준 CLIP보다 우수합니다. Flickr8k/30k와 MSCOCO Captions의 크로스모달 성능은 전문 단일 모달리티 모델과 경쟁적입니다. 12,288토큰 텍스트 컨텍스트는 이미지와 함께 긴 형식의 텍스트 문서를 검색하는 데 주요한 이점입니다. 2026년, jina-clip-v2가 89개 언어 지원과 512×512 이미지 처리로 이 모델을 대체합니다.

모범 사례

모델은 224×224 픽셀 타일로 이미지를 처리하며, 타일 하나가 1,000토큰을 차지합니다. 750×500 픽셀 이미지에는 12개 타일(12,000토큰)이 필요합니다. 텍스트는 단어당 약 1.1토큰이 필요합니다. 혼합 모달리티 쿼리에서는 이에 맞게 토큰 예산을 계획하세요. 모델은 현재 영어만 지원합니다 — 다국어 애플리케이션에는 jina-clip-v2를 사용하세요. Jina Embeddings API와 Hugging Face의 Apache 2.0 라이선스 오픈소스 릴리스로 사용할 수 있습니다. 프로덕션 환경에서는 AWS Marketplace와 Azure 배포 옵션이 최적화된 인프라를 제공합니다. 크로스모달 비교에는 코사인 유사도를 사용하세요. 새로운 멀티모달 프로젝트에는 jina-clip-v2(89개 언어, 512×512 이미지, MRL 지원) 또는 jina-embeddings-v4(32K 컨텍스트, 멀티 벡터 모드, 코드 지원)를 우선 사용하세요.

이 모델을 언급하는 블로그
6월 25, 2025 • 12 분 소요
Jina Embeddings v4: 멀티모달 다국어 검색을 위한 유니버설 벡터 모델 (Embeddings)
Jina 向量 모델 (Embeddings) v4는 38억 개의 파라미터를 가진 다중 모드 및 다국어 검색을 위한 범용 向量 모델 (embedding model)로, 단일 벡터 및 다중 벡터 向量 모델 (embedding) 출력을 모두 지원합니다.
4월 08, 2025 • 21 분 소요
jina-reranker-m0: 다국어 멀티모달 문서 재정렬기
시각적 문서를 검색하기 위한 새로운 다국어 멀티모달 리랭커인 jina-reranker-m0를 소개합니다. 다국어 긴 문서와 코드 검색 작업에서 최고 수준(SOTA)의 성능을 제공합니다.
12월 12, 2024 • 12 분 소요
임베딩 모델의 테스트 시 컴퓨팅 스케일링
더 많은 컴퓨팅 자원을 투입할수록 더 나은 결과가 나옵니다—더 많은 학습과 더 많은 검색에서 말입니다. 좋은 사전 학습 모델은 많은 것을 가능하게 하지만, 테스트 시점의 컴퓨팅은 그 이상을 가능하게 합니다. 임베딩 모델에서조차 테스트 시점의 컴퓨팅을 확장하는 이러한 새로운 패러다임을 인식하는 것이 중요합니다.
12월 04, 2024 • 13 분 소요
긴 맥락 처리가 가능한 모델이 있는데도 청킹이 여전히 필요할까?
서로 다른 청킹 전략을 사용하여 긴 문맥 임베딩 모델의 성능을 비교하고 필요에 맞는 최적의 접근 방식을 찾는 방법을 알아봅니다.
11월 21, 2024 • 9 분 소요
Jina CLIP v2: 텍스트와 이미지를 위한 다국어 멀티모달 임베딩
Jina-CLIP v2는 89개 언어를 지원하는 다국어 기능, 512x512의 고해상도 이미지 처리, 그리고 Matryoshka 표현을 갖춘 0.9B 규모의 멀티모달 임베딩 모델입니다.