

 Embeddings
jina-code-embeddings-1.5b
 GGUF
 Jina API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 망분리
개요
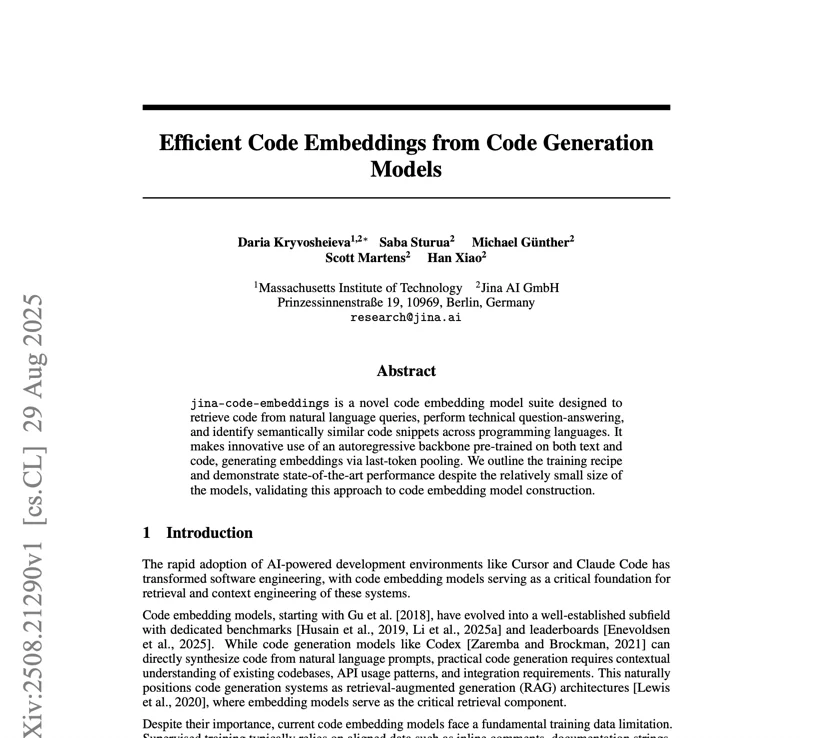
jina-code-embeddings-1.5b는 1.5B 파라미터 코드 임베딩 모델로, 프로그래밍 코드와 자연어 쿼리를 공유하는 1536차원 의미 공간으로 매핑합니다. 32K 토큰 컨텍스트 윈도우를 지원해 전체 파일 및 여러 파일 코드 컨텍스트에 대한 검색을 가능하게 합니다. state-of-the-art 코드 검색 성능을 달성하며, 0.5B 버전과 훨씬 더 큰 전용 코드 검색 모델을 압도적으로 능가합니다.
방법
모델은 자연어와 코드 코퍼스 모두에서 사전학습된 자기회귀형 트랜스퍼머 백본 위에 구축되며, 코드 생성 사전학습 목표를 활용해 풍부한 의미 표현을 생성합니다. 시퀀스의 마지막 위치에서 Last-Token-Pooling을 통해 임베딩을 추출합니다 — 자기회귀 모델의 인과적 어텐션이 자연히 전체 입력 컨텍스트를 주시하며, 코드 생성 목표는 문법 구조와 기능적 의미론을 모두 포착하는 표현을 생성합니다. 학습은 2단계 레시피를 사용합니다: (1) 대규모 코드-텍스트 쌍에서의 대비 사전학습, (2) 어려운 음의(negative) 마이닝을 포함한 큐레이션된 코드 검색 데이터셋에서의 지도 정밀조정. 32K 컨텍스트 길이는 조정된 기본 주파수를 갖는 회전 위치 임베딩을 통해 구현됩니다. Matryoshka 표현 학습을 통해 차원을 1536에서 128까지 절단할 수 있습니다.
성능
모델은 전체 평균 79.04%, MTEB Code 평균 78.94%를 달성해 해당 파라미터 클래스에서 새로운 벤치마크를 수립합니다. 주목할 점수: HumanEval 98.41%, MBPP 90.13%, WikiSQL 98.02%, CodeChefXLang 99.44%, CodeTransOceanContest(코드-대-코드) 92.54%, COIR-CodeSearchNet(NL2Code) 86.45%, Doc2Code 96.34%, StackOverflowQA 92.37%, SWE-Bench 86.33%(0.5B 변형은 83.00%). 더 큰 대안을 능가하며, 특히 복잡한 여러 파일 및 크로스 리포지토리 작업에서 0.5B 변형 대비 일관된 개선을 보입니다.
모범 사례
검색 요구사항에 따라 지시 접두사를 전략적으로 활용하세요: nl2code, code2code, code2nl, techqa, code2completion. 파이프라인 전반의 일관성을 유지하세요 — 주어진 검색 시나리오에서 쿼리와 문서에 동일한 접두사 유형을 사용하세요. 강화된 1.5B 용량은 여러 프로그래밍 패러다임과 방대한 코드베이스를 다루는 복잡한 시나리오에 이상적입니다. 품질과 리소스를 균형 있게 조절하는 최적의 Matryoshka 차원을 결정하기 위해 사용 사례를 프로파일링하세요; 인덱싱에는 256–512차원이 좋은 출발점이고, 리랭킹에는 1536차원을 사용하세요. 프로덕션에서 학습과 정렬을 위해 배치 크기 256을 사용하세요. 99.44%의 CodeChefXLang 성능을 감안할 때, 모델은 크로스 리포지토리 및 크로스 언어 검색에 뛰어납니다. RAG 시스템의 기본 검색 구성요소로 구현하고, 상위 50 후보의 정확도를 위해 jina-reranker-v3.5와 함께 사용하세요. 임베딩 비교에는 코사인 유사도를 사용하세요. 성능과 효율을 초 단위의 레이턴시로 모두 요구하는 엔터프라이즈 배포에 최적입니다.

