Embeddings
jina-embeddings-v3
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 망분리

개요
jina-embeddings-v3는 570M 파라미터의 다국어 텍스트 임베딩 모델로, 89개 언어와 8,192토큰 컨텍스트 윈도우를 지원합니다. 그 특징적인 혁신은 작업별 LoRA 어댑터 사용입니다: 동일한 570M 백본이 경량 어댑터 가중치 교체(각각 60M 파라미터 미만)로 검색, 분류, 클러스터링, 텍스트 매칭에 최적화된 임베딩을 생성합니다. 출시 시점 SOTA의 MTEB 성능을 달성하여 영어 작업에서 OpenAI와 Cohere의 프로프라이어터리 임베딩을 능가했습니다.
방법
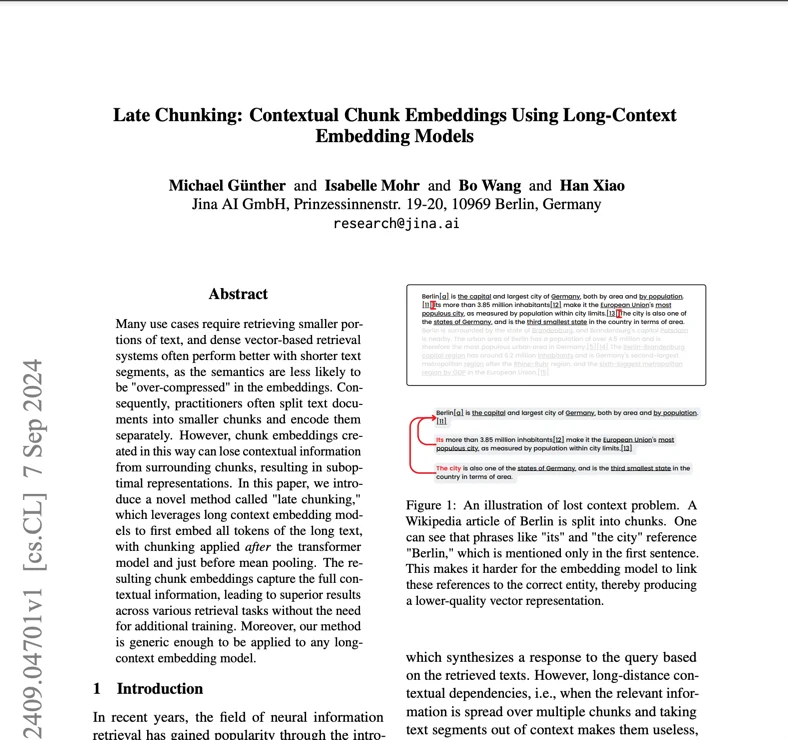
모델은 24개의 트랜스포머 레이어를 가진 jina-XLM-RoBERTa 백본 위에 구축되어 있으며, 튜닝된 기초 주파수를 가진 Rotary Position Embeddings(RoPE)를 사용해 최대 8,192토큰까지의 긴 컨텍스트 외삽을 사용합니다. 학습은 3단계 커리큘럼을 따랐습니다: (1) 89개 언어에 대한 다국어 사전학습, (2) 텍스트 페어 데이터셋에 대한 대비 미세조정으로 기본 임베딩 품질 확보, (3) 작업별 LoRA 어댑터 학습. 각 LoRA 어댑터는 총 파라미터 수에 3% 미만만 추가하면서 모델을 특정 작업에 특화시킵니다: 비대칭 검색용 retrieval.query와 retrieval.passage, 클러스터링용 separation, 분류용 classification, 의미적 유사도용 text-matching. Matryoshka Representation Learning(MRL)은 64차원에서 90% 이상의 검색 품질을 유지하면서 임베딩을 1024에서 32차원으로 절단할 수 있게 합니다. 컨텍스트 윈도우를 초과하는 문서에는 late chunking이 지원됩니다.
성능
MTEB에서 jina-embeddings-v3는 모든 작업에서 평균 65.52점을 달성했고, 분류(82.58)와 문장 유사도(85.80)에서 특히 강한 결과를 보였습니다. 모든 다국어 작업에서 multilingual-e5-large-instruct를 능가하고, 영어 작업에서 e5-mistral-7b-instruct(파라미터 수의 12배)에 승리했습니다. 다국어 MTEB에서 64.44점을 기록해 89개 언어에 걸쳐 일관된 성능을 입증했습니다. MRL 절단은 전체 1024 대비 64차원에서 검색 성능의 92%를 유지했습니다. 2026년에 jina-embeddings-v5-text-small이 대부분의 워크로드에서 이 모델을 대체하며, 32K 컨텍스트와 파라미터당 더 높은 정확도를 제공하는 증류 기반 학습을 제공합니다.
모범 사례
작업에 맞는 적절한 LoRA 어댑터를 선택하세요: 검색용 retrieval.query/retrieval.passage, 클러스터링용 separation, 분류용 classification, 의미적 유사도용 text-matching. 8,192토큰을 초과하는 문서에는 `late_chunking 파라미터를 사용하세요. 256 또는 512차원으로의 Matryoshka 절단은 저장소 제한 인덱싱에 적합하며, 재랭킹에는 전체 1024차원을 사용하세요. 모델은 프로덕션 처리량을 위해 CUDA 지원 GPU가 필요합니다. 새로운 다국어 프로젝트에는 jina-embeddings-v5-text-small`(32K 컨텍스트, 증류 학습, 더 높은 정확도)를 우선하세요. 모델은 텍스트 생성이나 복잡한 추론을 위해 설계되지 않았으며, 텍스트가 아닌 임베딩을 생성합니다.