Embeddings
 Qwen Research License
jina-embeddings-v4
Qwen Research License GGUF
 Jina API
 Hugging Face
 망분리
개요
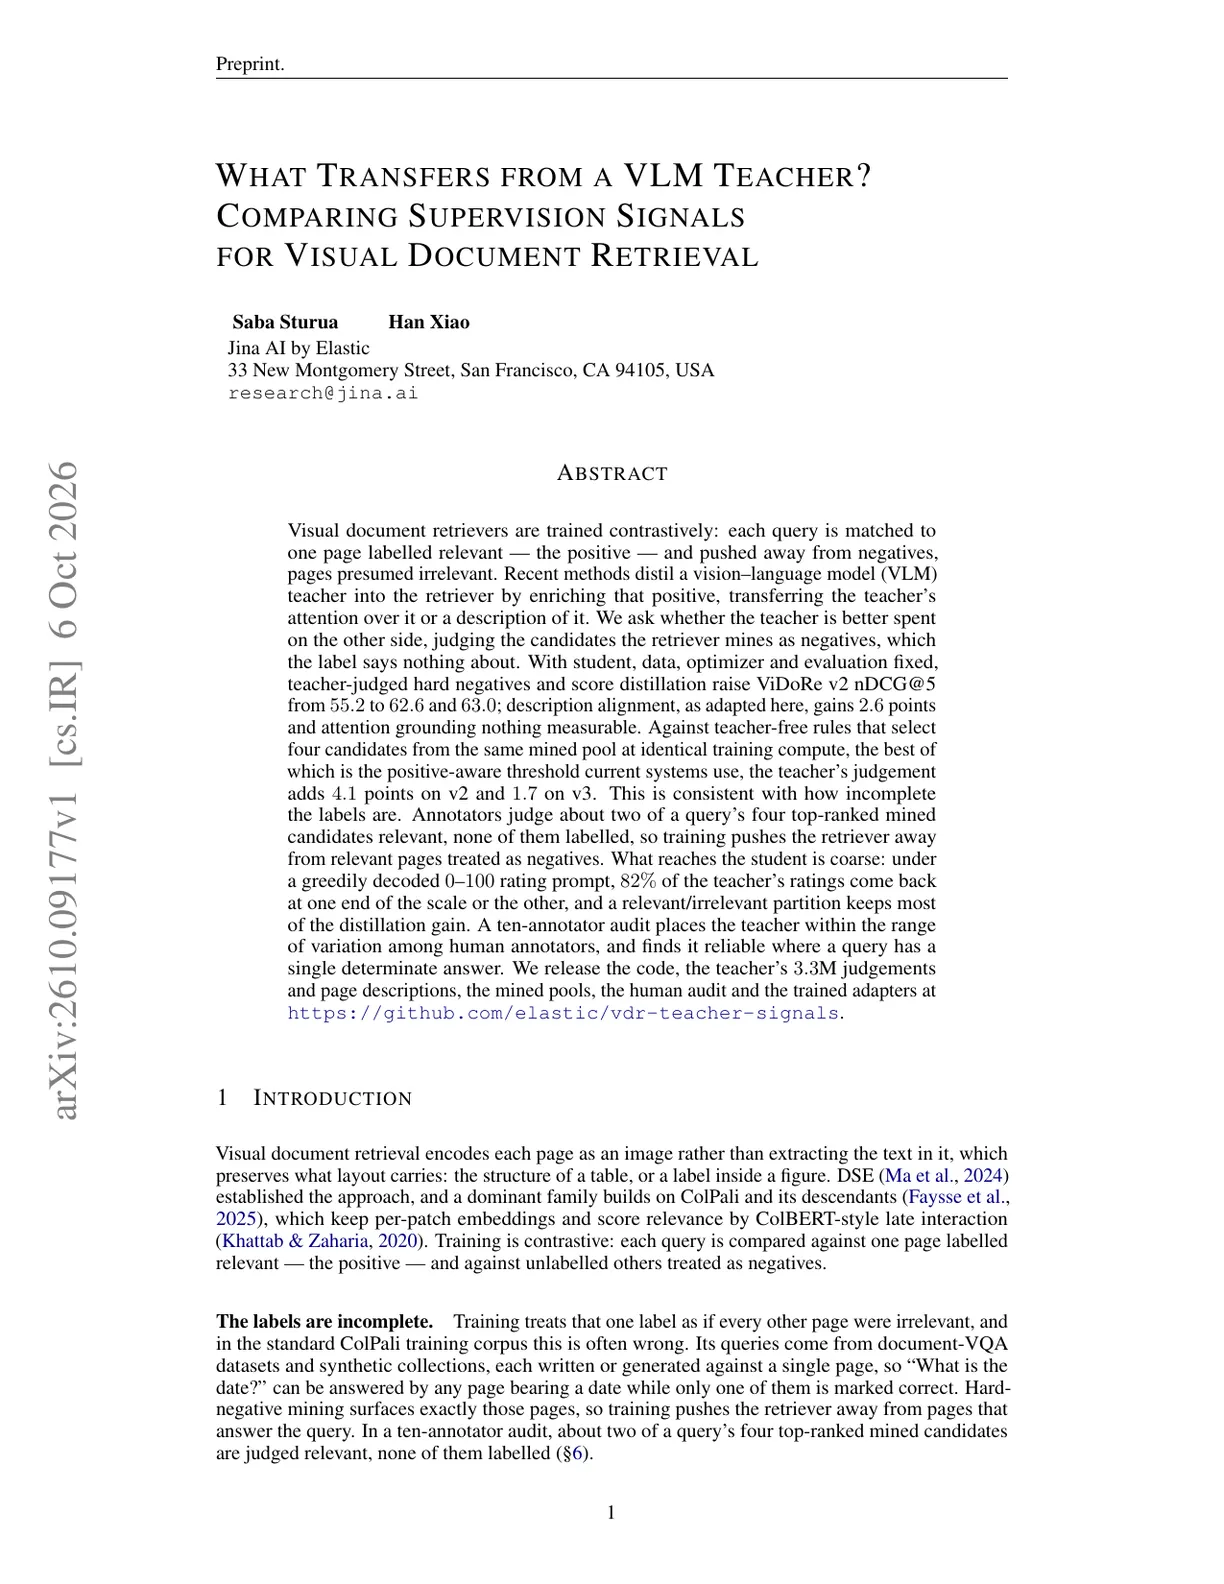
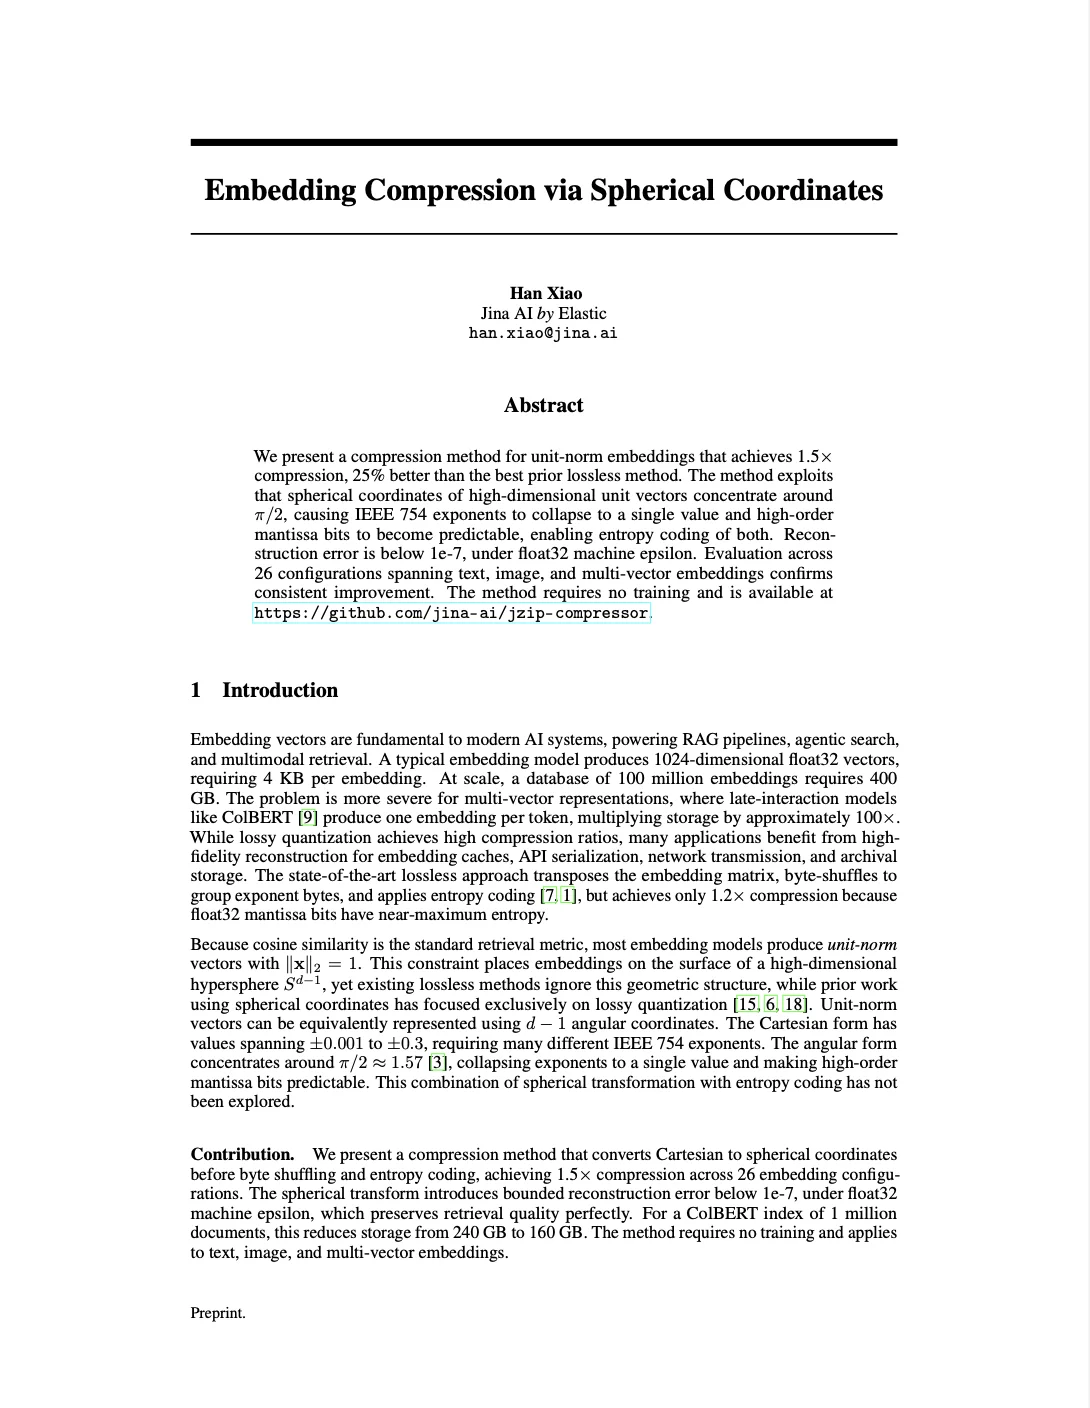
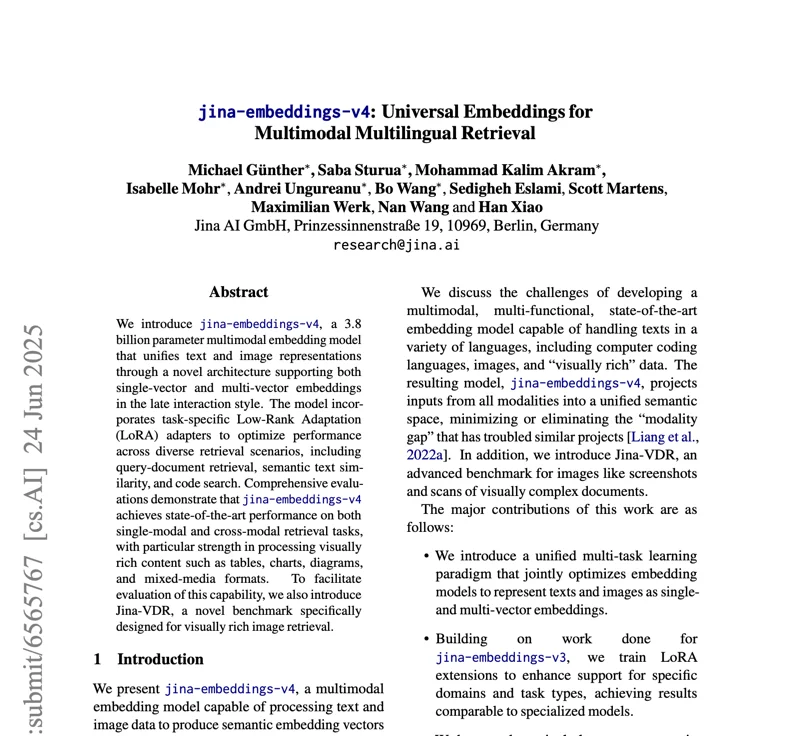
jina-embeddings-v4는 3.8B 파라미터의 멀티모달 임베딩 모델로, 텍스트와 이미지 표현을 단일 아키텍처에 통합합니다. 단일 벡터(dense)와 멀티 벡터(레이트 인터랙션/ColBERT 스타일) 두 가지 출력 모드를 모두 지원하므로, 모델을 교체하지 않고도 인덱싱 효율과 검색 정밀도 사이에서 트레이드오프할 수 있습니다. 시각적으로 풍부한 문서 검색에서 SOTA 성능을 달성하고, 표, 차트, 다이어그램, 혼합 미디어 포맷을 네이티브로 처리합니다.
방법
아키텍처는 대형 트랜스포머 인코더 백본과 Qwen2.5-VL 기반 비전 인코더를 결합해, 텍스트(최대 32K 토큰)와 이미지(768×28×28 패치)를 공유 어텐션 레이어로 처리합니다. 작업별 LoRA 어댑터 3개(각각 60M 파라미터)가 모델을 비대칭 쿼리-문서 검색, 의미 텍스트 유사도, 코드 검색에 특화합니다. 핵심 혁신은 이중 출력 설계입니다: 모델은 빠른 ANN 인덱싱을 위한 2048차원 단일 dense 벡터(Matryoshka 절단으로 128차원까지) 또는 레이트 인터랙션 스코어링을 위한 128차원 토큰 수준 벡터 집합을 생성할 수 있습니다. 학습은 2단계 커리큘럼을 따랐습니다: 텍스트-이미지 및 텍스트-텍스트 쌍에 대한 공동 대비 사전학습 후, 작업별 LoRA 어댑터를 학습했습니다. 32K 토큰 컨텍스트 윈도우를 초과하는 문서에는 late chunking을 지원합니다. Qwen Research License가 적용됩니다.
성능
JinaVDR(Visual Document Retrieval)에서 모델은 평균 72.19점을 기록해, ColPali-v1.2의 64.50을 능가합니다. ViDoRe에서는 평균 84.11점(멀티 벡터 모드에서는 90.17점)으로, ColPali의 83.90보다 우수합니다. 크로스모달 검색은 CLIP 벤치마크에서 84.11을 달성해 jina-clip-v2(81.12)와 nllb-clip-large-siglip(83.19)를 능가합니다. 텍스트 검색 점수: MTEB-en 55.97, MMTEB 66.49, LongEmbed 67.11(jina-embeddings-v3는 55.66). 의미론적 유사도는 English STS에서 85.89, 다국어 STS에서 72.70에 도달합니다. 코드 검색은 CoIR에서 71.59를 기록합니다. 크로스모달 정렬은 코사인 유사도 0.71(OpenAI CLIP은 0.15)에 도달합니다. 멀티 벡터 모드는 시각적으로 풍부한 작업에서 일관되게 싱글 벡터 모드를 능가하고, 싱글 벡터 모드는 표준 텍스트 검색에서 효율적인 성능을 제공합니다.
모범 사례
파이프라인에 따라 출력 모드를 선택하세요: 대규모 ANN 인덱싱에는 단일 벡터(Matryoshka 절단으로 128–512차원 사용 가능), 시각적으로 풍부한 문서의 top-k 후보 리랭킹에는 멀티 벡터. API 작업 파라미터로 LoRA 어댑터를 선택합니다: 쿼리-문서 검색은 ‘retrieval’, 의미론적 유사도는 ‘text-matching’, 코드 검색은 ‘code’. 32K 토큰을 초과하는 문서에는 `late_chunking을 사용하세요. LoRA 어댑터당 60M 파라미터 오버헤드는 무시할 수 있고(메모리 증가 <2%) 세 어댑터 모두 동시에 로드할 수 있습니다. 모델에는 Qwen Research License가 적용됩니다(비상업적 용도로만 사용 가능하며 상업용 라이선스는 제공되지 않음). 프로덕션 배포에는 CUDA 지원 GPU를 사용하세요; 모델은 Jina API, AWS, Azure, GCP 마켓플레이스에서 사용할 수 있습니다. 텍스트 전용 워크로드에는 jina-embeddings-v5-text-small`이 훨씬 낮은 계산 비용으로 파라미터당 더 나은 정확도를 제공합니다.