Embeddings
jina-embeddings-v5-omni-nano
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Hugging Face
 macOS
 망분리
개요
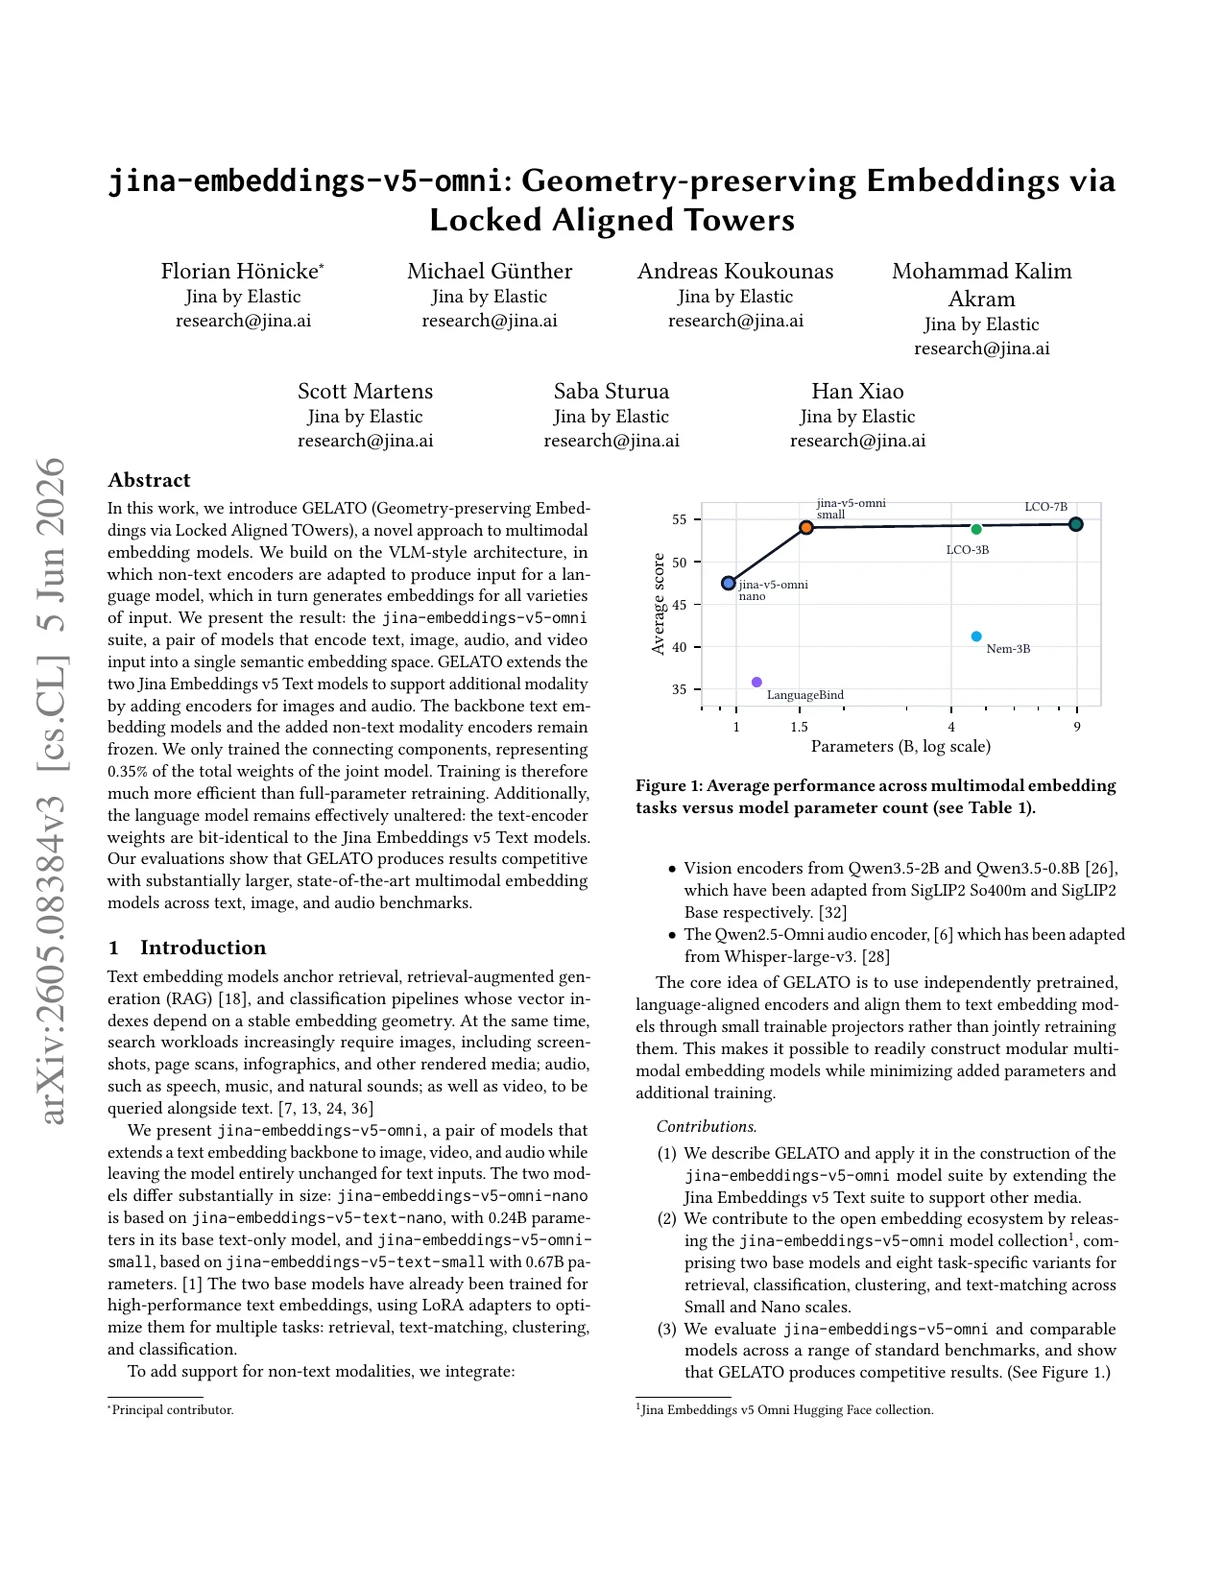
jina-embeddings-v5-omni-nano는 약 1.04B 파라미터의 멀티모달 임베딩 모델로, 텍스트, 이미지, 영상, 오디오, PDF를 받아들여 공유 벡터 공간에서 임베딩을 생성합니다. v5-omni 패밀리의 컴팩트 변형으로, GPU가 없는 엣지 및 보급형 하드웨어를 위해 설계되었습니다. 텍스트 전용 출력은 jina-embeddings-v5-text-nano와 비트 동일하여, 재인덱싱 없이 텍스트 전용에서 멀티모달로 드롭인 업그레이드할 수 있습니다.
방법
모델은 세 번째 학습 단계로 jina-embeddings-v5-text-nano에 멀티모달 기능을 더합니다. EuroBERT-210M 텍스트 백본과 네 개의 태스크별 LoRA 어댑터는 동결되고, 새로 학습되는 것은 크로스모달 프로젝터뿐입니다. SigLIP2 Base 비전 인코더가 이미지와 영상을 처리하고(영상당 32프레임 균일 샘플링), Whisper-large-v3 오디오 인코더가 오디오 입력을 처리합니다. PDF 페이지는 이미지로 렌더링되어 시각 경로로 처리됩니다. 학습에는 크로스모달 하드 네거티브를 쓰는 대비 손실로, 시각·오디오 표현을 기존 텍스트 임베딩 공간에 정렬합니다. 768차원 출력 공간은 32차원까지 Matryoshka 절단을 지원합니다. 8K 토큰 컨텍스트 윈도우는 텍스트 입력을 담당하며, 이미지·오디오 입력은 각각의 인코더로 처리됩니다.
성능
텍스트 전용 성능은 jina-embeddings-v5-text-nano(MMTEB 태스크 레벨 평균 65.5, 영어 MTEB 71.0)과 비트 동일합니다. 멀티모달 성능은 임베딩 공간이 768차원(1024 대비)으로 좁고 텍스트 백본이 작아 jina-embeddings-v5-omni-small보다 약간 낮지만, 텍스트-이미지, 텍스트-오디오, 텍스트-영상 검색 전반에 강한 크로스모달 정렬을 유지합니다. 모델은 더 큰 omni-small 모델이 효율적으로 실행되지 않는 CPU 및 엣지 하드웨어를 위해 최적화되었습니다. 크로스모달 검색 품질은 같은 크기 등급에서 경쟁력이 있습니다.
모범 사례
jina-embeddings-v5-omni-small과 동일한 사용 패턴입니다: 적절한 LoRA 어댑터(retrieval, text-matching, clustering, classification)를 선택하고 API를 통해 이미지 URL, 오디오 파일 URL, 영상 파일 URL, 또는 PDF URL을 직접 전달하세요 — 모델은 각 모달리티를 적절한 인코더로 라우팅합니다. 지원되는 오디오 형식: WAV, MP3, FLAC, OGG, M4A, Opus. 영상 입력은 32프레임 균일 샘플링으로 처리됩니다. 단일 배치 내에서 모달리티를 자유롭게 혼합할 수 있습니다; 임베딩 공간은 모든 모달리티 간에 공유됩니다. 비교에는 코사인 유사도를 사용하세요. 768에서 32차원으로의 Matryoshka 절단은 지원됩니다. 텍스트 전용 임베딩은 jina-embeddings-v5-text-nano와 드롭인 호환됩니다 — 업그레이드 시 재인덱싱이 필요 없습니다. 더 높은 정확도가 필요한 서버 배포에는 jina-embeddings-v5-omni-small(1024차원, 더 큰 백본)을 사용하세요.