Reranker
jina-reranker-v3.5
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 망분리
개요
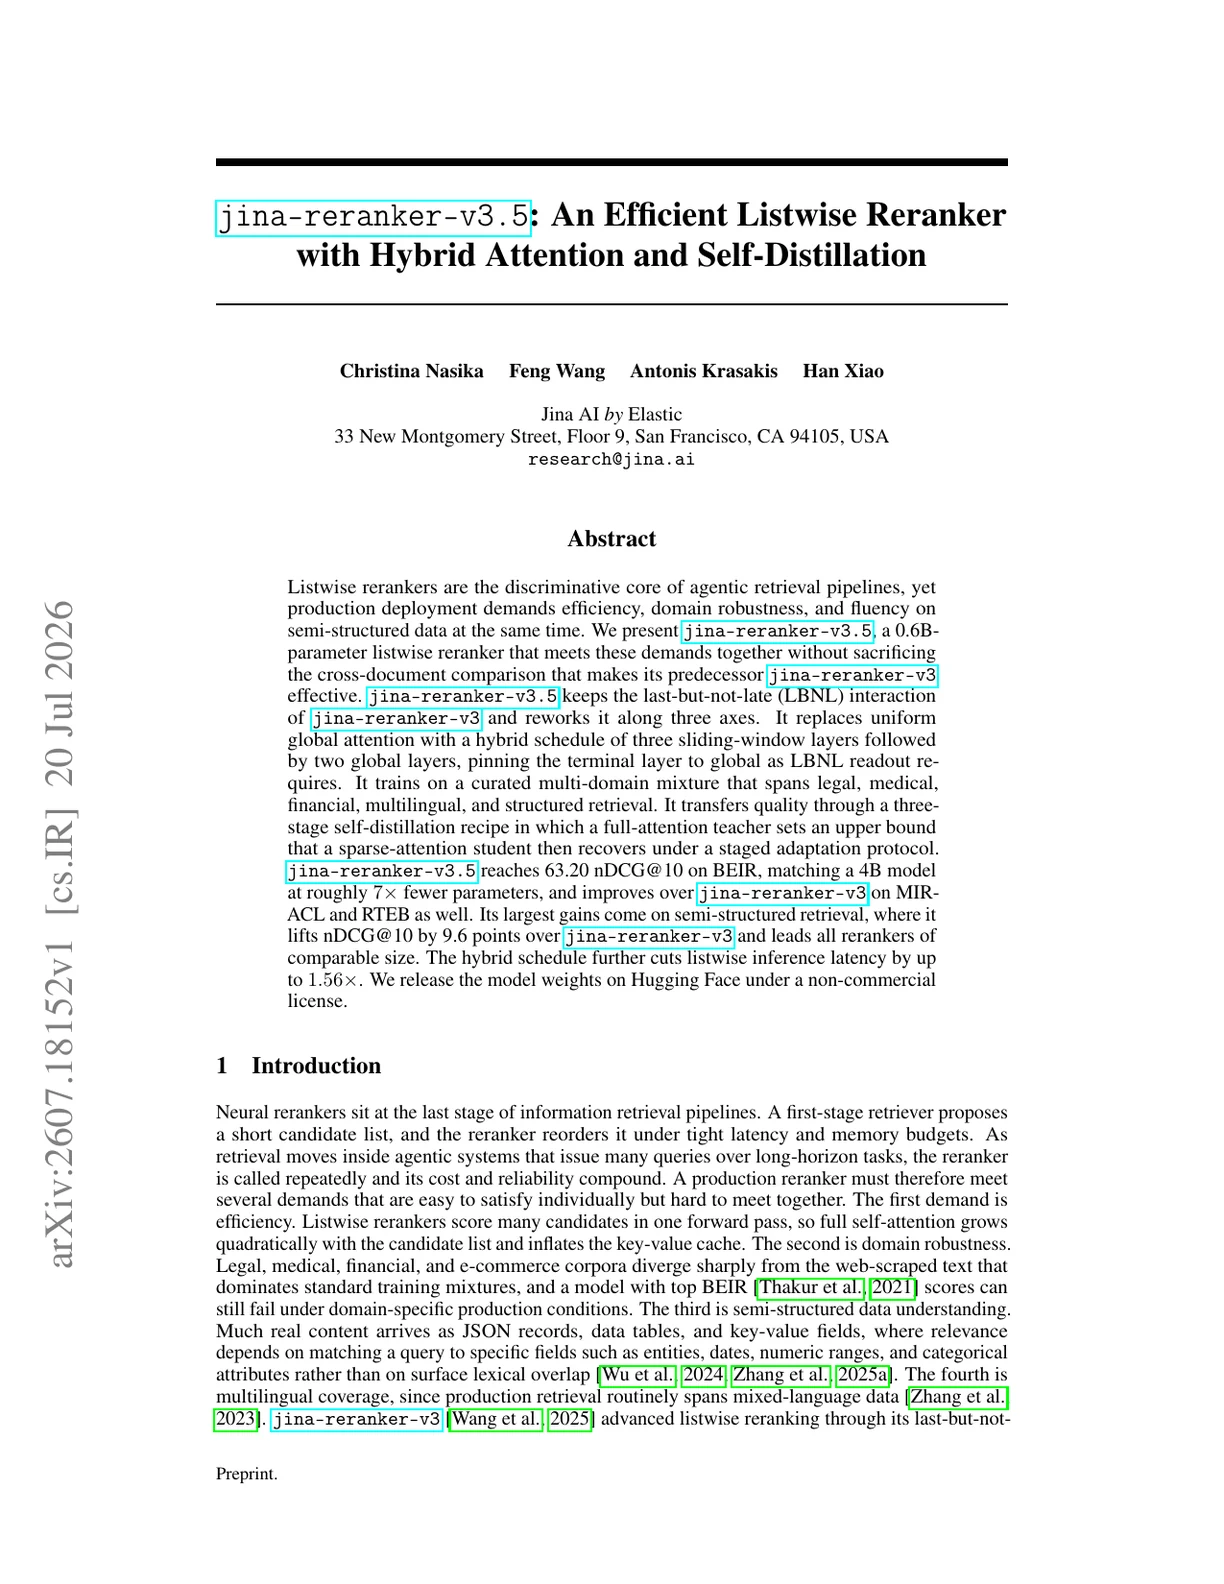
jina-reranker-v3.5는 0.6B 파라미터의 리스트와이즈 리랭커로, 4B 파라미터 모델의 7분의 1 수준의 파라미터로 버금합니다. 하이브리드 어텐션 스케줄(슬라이딩 윈도우 레이어 세 개 + 글로벌 레이어 두 개)과, 풀 어텐션 티처에서 스파스 어텐션 스튜던트로 품질을 이관하는 세 단계 자기 증류 레시피를 도입합니다. jina-reranker-v3의 드롭인 대체품으로, 동일한 API 스키마를 유지하면서 효율과 도메인 커버리지를 개선합니다.
방법
아키텍처는 jina-reranker-v3의 LBNL 리스트와이즈 설계를 유지합니다: 쿼리와 모든 후보 문서가 단일 컨텍스트 윈도우를 공유하고, 임베딩은 각 문서의 최종 토큰에서 읽힙니다. 핵심 혁신은 하이브리드 어텐션 스케줄입니다. 모든 레이어에서 균일한 글로벌 어텐션을 사용하는 대신, 모델은 각 위치의 주의를 로컬 윈도우로 제한하는 슬라이딩 윈도우 어텐션 레이어 세 개에 이어 글로벌 어텐션 레이어 두 개를 사용합니다. 마지막 레이어는 LBNL 읽기 메커니즘이 최종 토큰이 전체 컨텍스트에 주의할 것을 요구하기 때문에 글로벌 어텐션으로 고정됩니다. 학습은 세 단계로 진행됩니다: (1) 풀 어텐션 티처 모델을 법조·의료·금융·다국어·구조화 검색에 걸친 큐레이션된 멀티도메인 혼합으로 훈련; (2) 스파스 어텐션 스튜던트를 티처에서 초기화하고 단계적 적응으로 정밀조정하며, 하이브리드 스케줄을 사용하는 학습 단계의 비율을 점차 증가; (3) 스튜던트가 티처의 소프트 랭킹 분포를 일치하도록 배우는 최종 증류 패스에서, 더 저렴한 스파스 어텐션 추론 경로를 실행하면서 티처 랭킹 품질의 97% 이상을 회복합니다.
성능
jina-embeddings-v5-text-small을 1단계 검색기로 한 통합 top-100 프로토콜에서, 모델은 BEIR 63.20 NDCG{'@'}10, MIRACL 74.11, RTEB 70.95, Struct-IR 48.3을 기록하며 jina-reranker-v3(62.10 / 72.20 / 68.01 / 38.7)를 모든 축에서 능가합니다. 그 BEIR 점수는 파라미터를 약 7분의 1로 줄이면서 4B Qwen3-Reranker(62.28)를 근소한 차이로 앞서갑니다. v3 대비 상대적 개선은 BEIR +1.10, MIRACL +2.6%, RTEB +4.3%(법무 검색에서 큰 향상), 구조화 데이터 랭킹(Struct-IR) +24.8%입니다. 리스트와이즈 추론은 짧은 컨텍스트에서 긴 컨텍스트까지 v3보다 1.22–1.56배 빠르게 실행됩니다(A100, FlashAttention-2). 멀티도메인 학습 혼합은 반구조화 데이터(표, JSON, XML)와 도메인별 코퍼스에서 특히 강한 향상을 제공합니다.
모범 사례
jina-reranker-v3.5는 jina-reranker-v3의 드롭인 대체품입니다: 요청 스키마가 변하지 않으므로, 모델 문자열을 바꾸는 데 코드 변경이 필요하지 않습니다. 쿼리를 후보 목록 전체에 대해 단일 호출로 랭킹합니다 — 문서를 표준 rerank 엔드포인트로 전달하고 반환 결과를 제한하려면 top_n을 사용하거나, 문서 임베딩도 가져오려면 return_embeddings를 설정하세요. 모델은 구조화 데이터 랭킹, 법무 및 기타 도메인별 검색, 다국어 컬렉션에서 특히 강합니다. 하이브리드 어텐션 설계로 긴 후보 목록에서도 지연이 낮게 유지됩니다. 131K 토큰 컨텍스트 윈도우는 청킹 없이 매우 긴 문서를 지원합니다. Hugging Face에서 CC-BY-NC-4.0으로 사용 가능; 상업적 사용은 Jina AI에 문의하세요. 에어갭 또는 온프레미스 배포를 위해 양자화 가중치가 제공됩니다. 1단계 검색기로 jina-embeddings-v5-text-small 또는 jina-embeddings-v4와 페어링하세요.