Reranker
jina-reranker-v3
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 망분리
개요
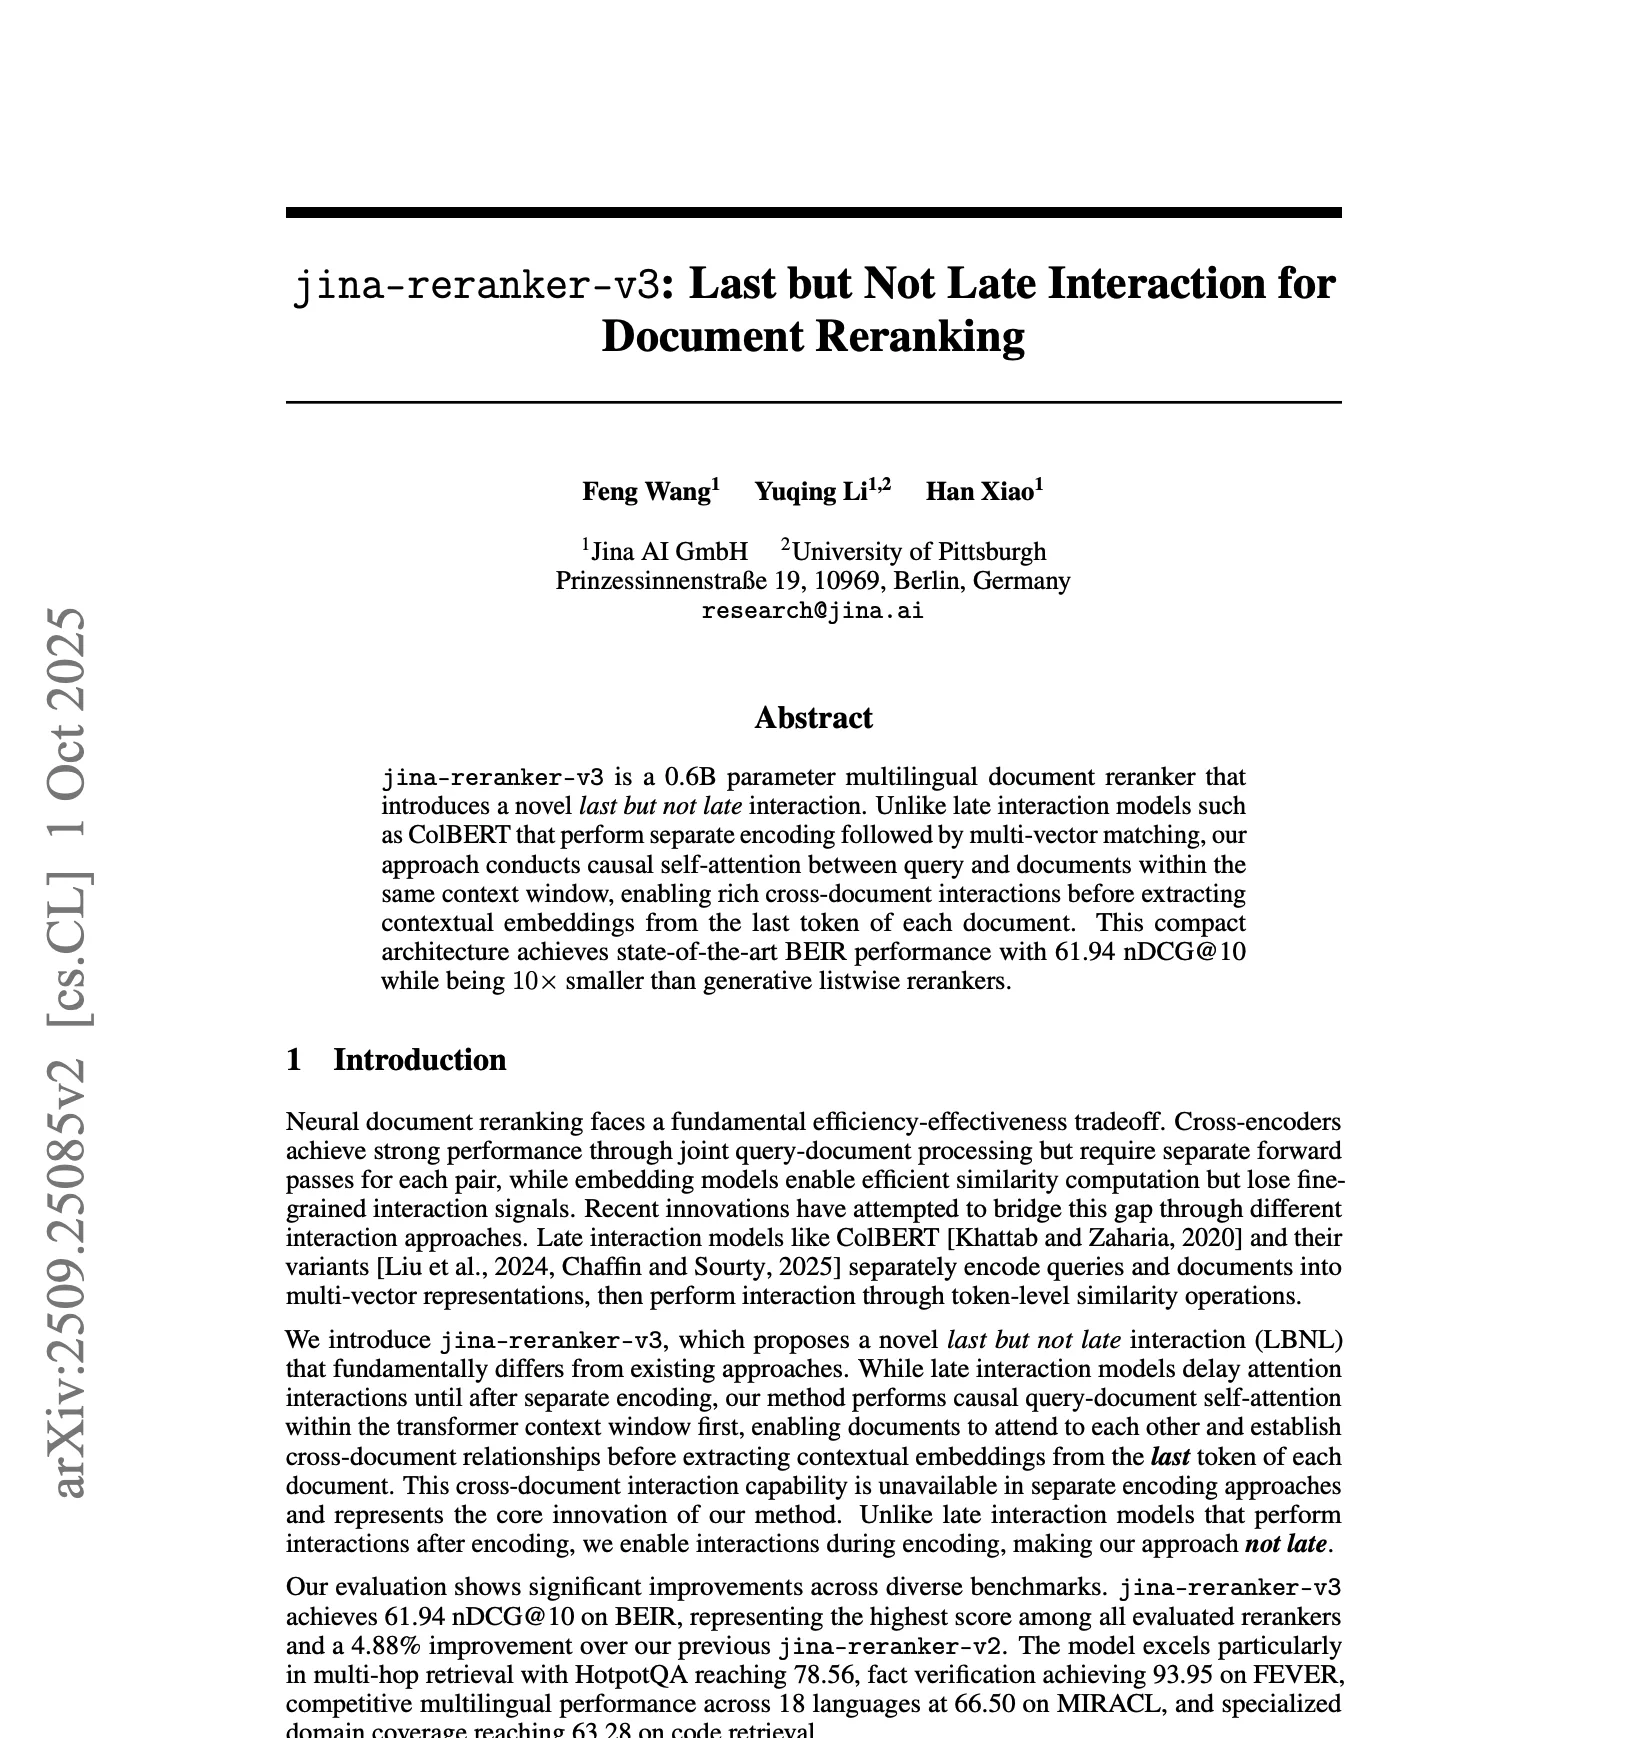
jina-reranker-v3는 597M 파라미터의 다국어 리스트와이즈 리랭커로, ‘last but not late’(LBNL) 상호작용을 도입합니다 — 페어와이즈 크로스 엔코더 스코어링에서 벗어난 패러다임 전환입니다. 각 쿼리-문서 쌍을 따로 평가하는 대신, 단일 131K 토큰 컨텍스트 윈도우 안에서 후보 문서 목록 전체를 동시에 처리하며, 인과적 어텐션으로 문서 간 관계를 포착합니다. 가장 근접한 경쟁 모델보다 2.5배 적은 파라미터로 BEIR에서 SOTA 성능(61.94 NDCG{'@'}10)을 달성합니다.
방법
핵심 혁신은 LBNL 아키텍처입니다. 표준 크로스 엔코더에서는 각 쿼리-문서 쌍이 독립적으로 스코어링됩니다. 레이트 인터랙션 모델(ColBERT)에서는 문서가 개별적으로 인코딩되고 토큰 단위로 매칭됩니다. LBNL은 두 방식의 강점을 결합합니다: 쿼리와 모든 후보 문서가 단일 인과적 어텐션 컨텍스트를 공유하므로, 모델은 문서 간에 어텐션을 적용해 페어와이즈 스코어링이 놓치는 상대적 관련성 신호를 포착할 수 있습니다. 모델은 포워드 패스당 최대 16개 문서(학습 중에는 양성 1개, 음성 15개)를 처리하며, 각 문서는 고정 길이로 잘립니다. 임베딩은 각 문서의 마지막 토큰에서 Last-Token-Pooling으로 추출되며, 인과적 어텐션 메커니즘이 앞선 컨텍스트의 정보를 자연스럽게 집계합니다. 131K 토큰 컨텍스트 윈도우는 기본 주파수를 조정한 회전 위치 임베딩으로 구현됩니다. 학습에는 InfoNCE, 분산 손실(가중치 0.45), 이중 매칭 손실(가중치 0.85), 유사도 손실을 결합한 다목적 손실을 쓰는 3단계 점진적 커리큘럼을 적용합니다.
성능
BEIR에서 모델은 61.94 NDCG{'@'}10을 달성해 평가된 모든 리랭커 가운데 최고이며, jina-reranker-v2 대비 4.88% 향상입니다. 멀티홉 검색(HotpotQA 78.56)과 사실 검증(FEVER 93.95)에서 강합니다. 다국어 성능은 18개 언어에서 MIRACL 66.50이며, 아랍어 78.69, 태국어 81.06입니다. 코드 검색은 CoIR에서 63.28입니다. 1.5B mxbai-rerank-large(61.44)를 2.5배 적은 파라미터로 능가하고, 같은 규모의 bge-reranker-v2-m3보다 5.43% 앞섭니다. 성능은 문서 순서 전반에서 비교적 안정적입니다: 무작위(62.54), 내림차순(61.94), 오름차순(61.52) — 후보 순서와 무관한 견고한 리스트와이즈 스코어링을 보여줍니다.
모범 사례
임베딩 추출을 위해 system/user/assistant 역할과 특수 토큰이 있는 구조화된 프롬프트 템플릿을 사용하세요. 131K 컨텍스트를 초과하는 컬렉션에는 포워드 패스당 최대 64개 문서를 처리하세요. 문서를 무작위로 또는 관련성 내림차순으로 정렬한 것이 최적입니다(성능 차이는 1% 미만). 비교 랭킹 작업에는 문서 간 상호작용 능력을 활용하세요 — 모델의 리스트와이즈 설계는 페어와이즈 스코어링이 놓치는 후보 간 관계를 포착합니다. 다국어 애플리케이션에서 모델은 18개 언어에 걸쳐 강력한 제로샷 전이를 제공합니다. 대규모 문서 세트에는 배치 처리를 구현하고, 쿼리 임베딩을 배치 간에 일관되게 유지하세요. 256차원 출력 임베딩은 효율적인 유사도 계산을 지원합니다. 멀티홉 추론 및 사실 검증 작업에 이상적입니다. 프로덕션에는 하이브리드 어텐션을 통한 1.22–1.56배 빠른 추론을 위해 jina-reranker-v3.5를 사용하세요.