소식

토큰 하나하나로 검색 AI를 가속합니다.

RSS
추천
학술 논문
arXiv
9월 02, 2026
jina-ocr-v1: Efficient Document Parsing with Speculative Decoding and Dense Verifiable Rewards
arXiv
7월 20, 2026
jina-reranker-v3.5: An Efficient Listwise Reranker with Hybrid Attention and Self-Distillation
SIGIR 2026
5월 11, 2026
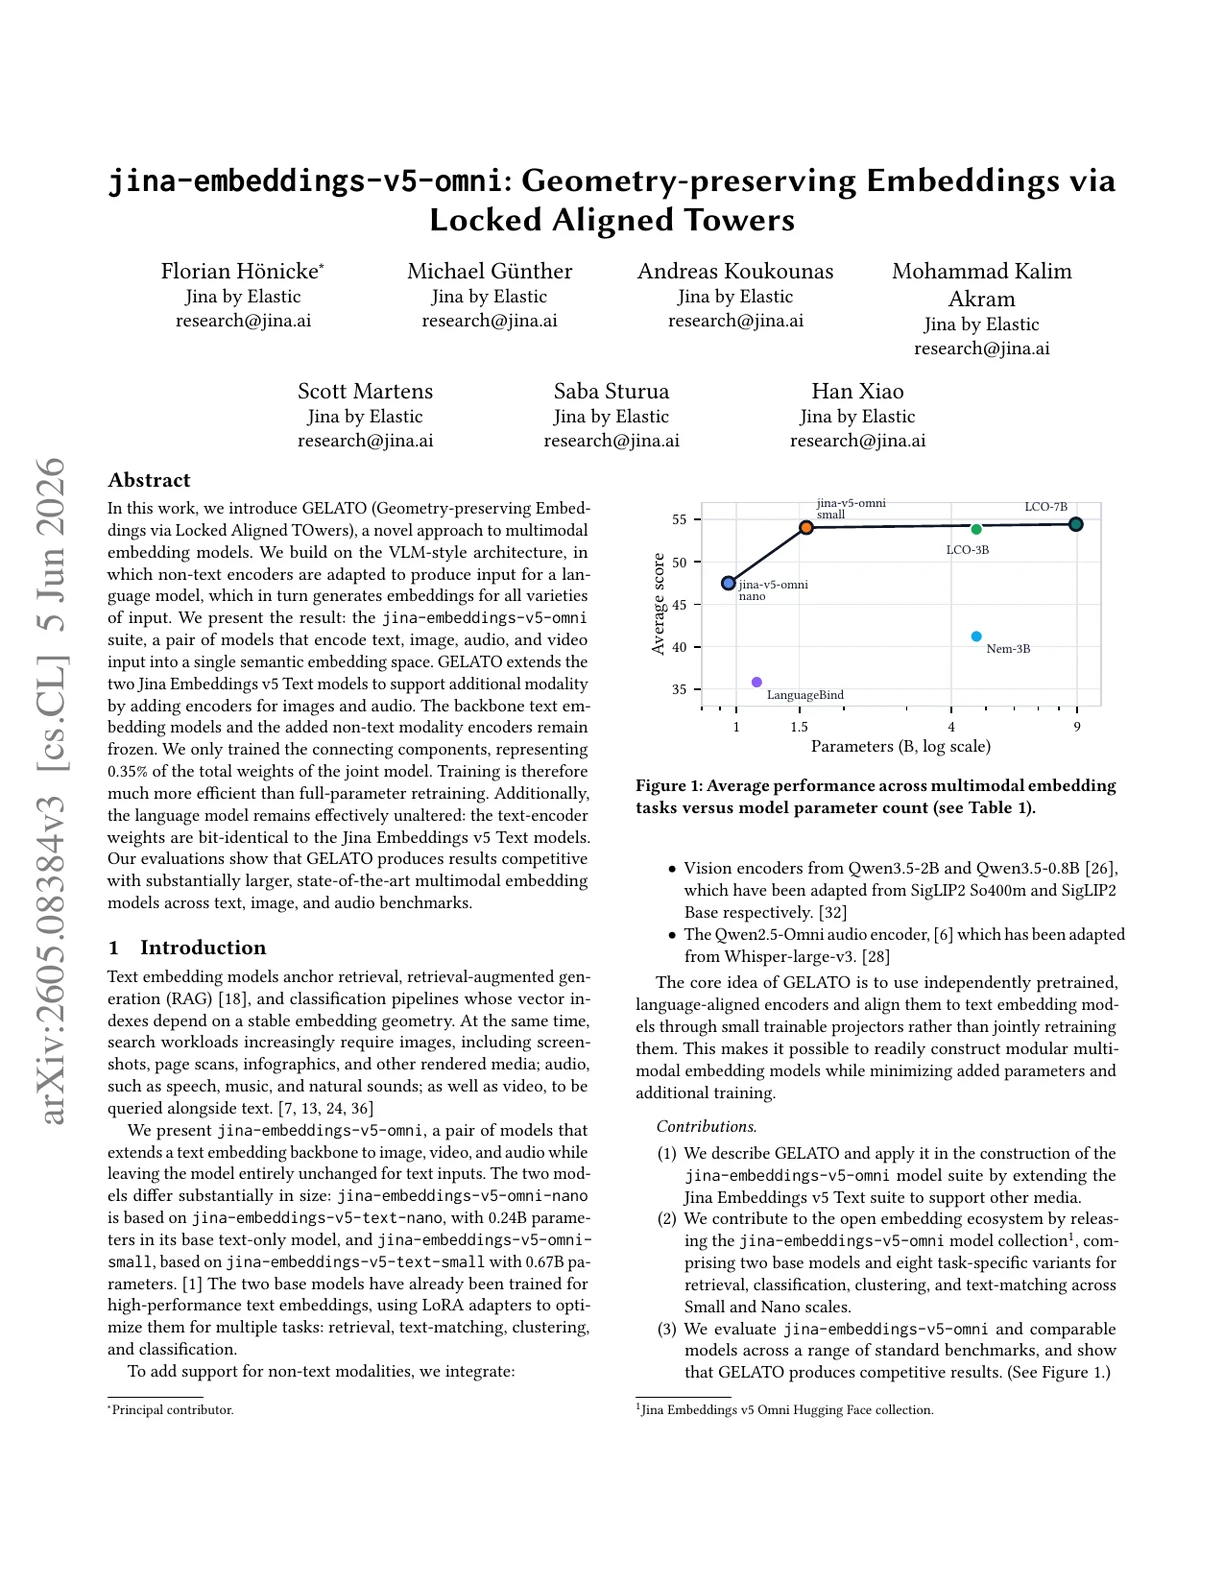
jina-embeddings-v5-omni: Geometry-preserving Embeddings via Locked Aligned Towers
SIGIR 2026
2월 17, 2026
jina-embeddings-v5-text: Task-Targeted Embedding Distillation
ICLR 2026
1월 22, 2026
Embedding Compression via Spherical Coordinates
arXiv
12월 29, 2025
Vision Encoders in Vision-Language Models: A Survey
ICLR 2026
12월 04, 2025
Jina-VLM: Small Multilingual Vision Language Model
AAAI 2026
10월 01, 2025
jina-reranker-v3: Last but Not Late Interaction for Document Reranking
NeurIPS 2025
8월 31, 2025
Efficient Code Embeddings from Code Generation Models
EMNLP 2025
6월 24, 2025
jina-embeddings-v4: Universal Embeddings for Multimodal Multilingual Retrieval
ICLR 2025
3월 04, 2025
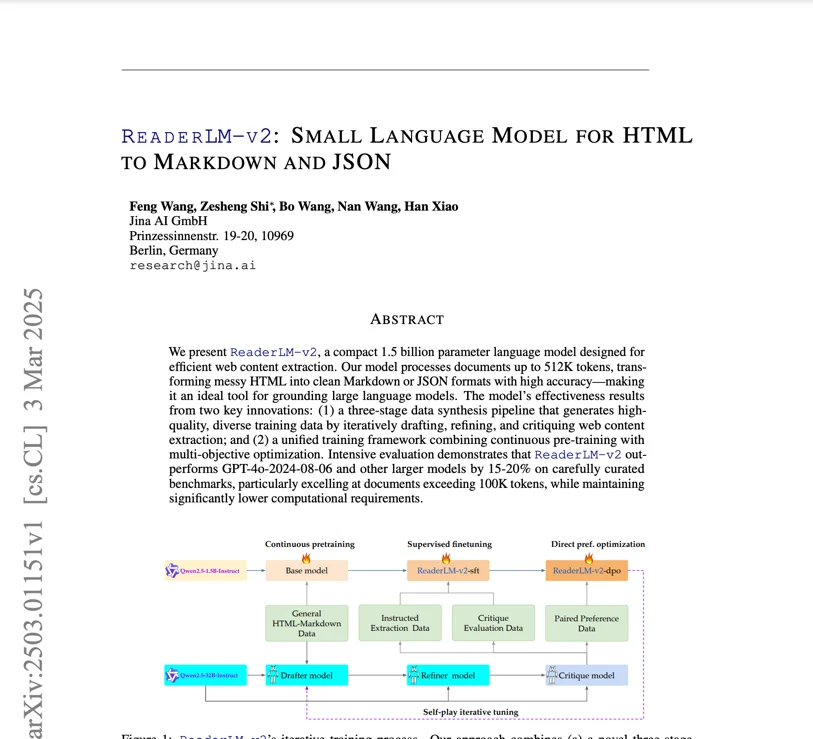
ReaderLM-v2: Small Language Model for HTML to Markdown and JSON
ACL 2025
12월 17, 2024
AIR-Bench: Automated Heterogeneous Information Retrieval Benchmark
ICLR 2025
12월 12, 2024
jina-clip-v2: Multilingual Multimodal Embeddings for Text and Images
ECIR 2025
9월 18, 2024
jina-embeddings-v3: Multilingual Embeddings With Task LoRA
SIGIR 2025
9월 07, 2024
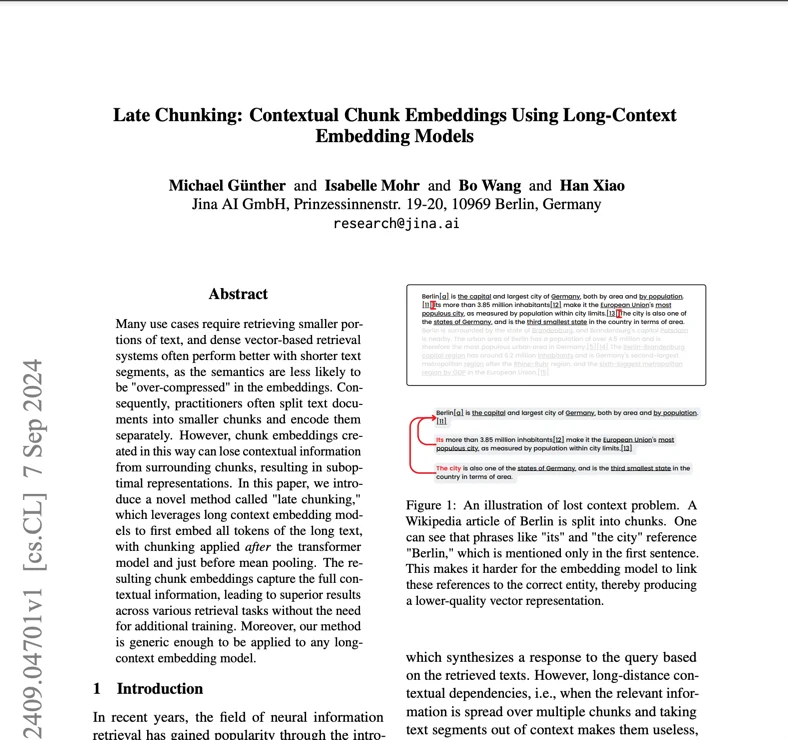
Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models
EMNLP 2024
8월 30, 2024
Jina-ColBERT-v2: A General-Purpose Multilingual Late Interaction Retriever
WWW 2025
6월 21, 2024
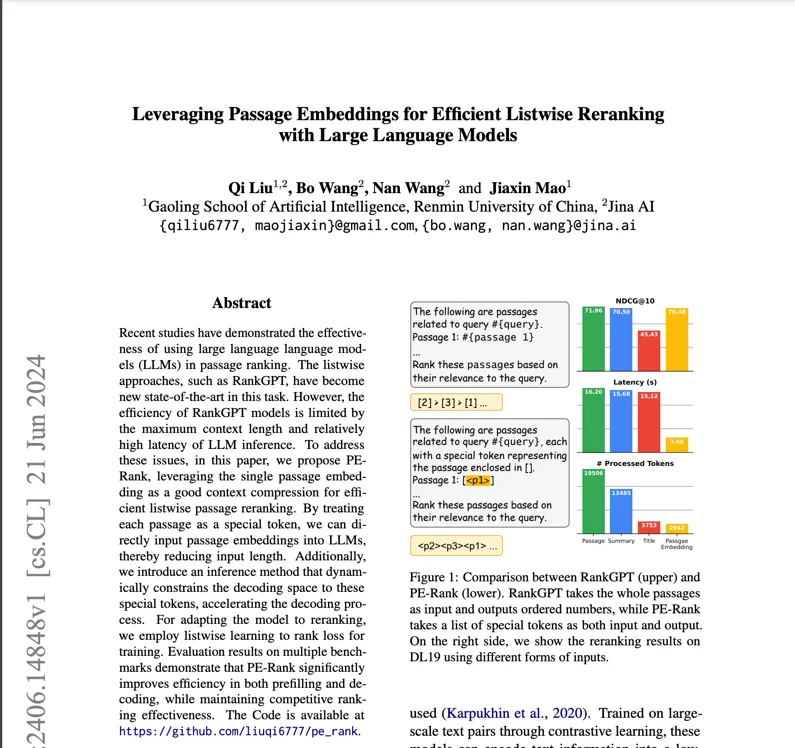
Leveraging Passage Embeddings for Efficient Listwise Reranking with Large Language Models
ICML 2024
5월 30, 2024
Jina CLIP: Your CLIP Model Is Also Your Text Retriever
arXiv
2월 26, 2024
Multi-Task Contrastive Learning for 8192-Token Bilingual Text Embeddings
arXiv
10월 30, 2023
Jina Embeddings 2: 8192-Token General-Purpose Text Embeddings for Long Documents
EMNLP 2023
7월 20, 2023
Jina Embeddings: A Novel Set of High-Performance Sentence Embedding Models
총 21개의 논문.

9월 14, 2026 • 9 분 소요
jina-ocr-v1: 저예산 GPU에서의 더 빠른 문서 파싱
jina-ocr-v1은 34억 개의 파라미터와 5억 7천만 개의 활성 파라미터를 가진 비전 언어 모델로, OmniDocBench v1.6에서 91.1점, olmOCR-Bench에서 83.4점을 기록했습니다.
8월 03, 2026 • 11 분 소요
jina-reranker-v3.5: 하이브리드 어텐션과 자기 증류를 통한 더 빠른 리스트와이즈(Listwise) 재순위화(Reranker)
BEIR 벤치마크에서 Qwen3-Reranker-4B를 능가하고, v3 대비 최대 1.56배 빠른 속도로 재순위화(reranking)하며, 반정형 데이터 검색에서 9.6 nDCG@10 향상을 달성한 0.6B 규모의 리스트와이즈(listwise) 재순위화 모델(Reranker)입니다.
5월 12, 2026 • 7 분 소요
jina-embeddings-v5-omni: 텍스트, 이미지, 오디오 및 비디오를 위한 벡터 모델(Embeddings)
하나의 모델, 네 가지 모달리티: 텍스트, 이미지, 오디오, 비디오. 1.6B 및 0.9B 크기의 동급 최강 옴니 向量模型(Embeddings).
3월 11, 2026 • 7 분 소요
멀티모달 LLM 을 활용한 오디오 임베딩 부트스트래핑
모든 멀티모달 대형 언어 모델 을 25배 적은 데이터로 CLAP 을 능가하는 소형 오디오 임베딩 모델 로 변환해 보세요.
3월 06, 2026 • 6 분 소요
원시 수치 값에서 임베딩 모델 식별하기
원시 숫자를 읽어 벡터 모델을 핑거프린팅하는 아주 작은 트랜스포머입니다. 피처 엔지니어링은 필요하지 않습니다.
2월 19, 2026 • 7 분 소요
jina-embeddings-v5-text: 새로운 SOTA 소형 다국어 임베딩(Embeddings)
최고 수준의 성능을 자랑하는 1B 미만의 다국어 向量模型 두 가지가 Elastic Inference Service, Llama.cpp 및 MLX에서 제공됩니다.
12월 04, 2025 • 7 분 소요
Jina-VLM: 작은 다국어 비전 언어 모델
새로운 20억 규모의 비전 언어 모델이 다국어 VQA에서 SOTA를 달성하고, 텍스트 전용 작업에서 치명적인 망각을 겪지 않습니다.
10월 03, 2025 • 7 분 소요
Jina Reranker v3: SOTA 다국어 검색을 위한 0.6B Listwise 재정렬기
쿼리 및 모든 후보 문서를 단일 컨텍스트 창에서 고려하는 새로운 0.6B 파라미터 목록별 재정렬기(Reranker)입니다.
9월 09, 2025 • 11 분 소요
Llama.cpp 및 GGUF의 멀티모달 向量模型
저희는 llama.cpp 및 GGUF에 멀티모달 向量模型을 도입했으며, 그 과정에서 몇 가지 놀라운 문제점을 발견했습니다.
9월 04, 2025 • 6 분 소요
Jina 코드 임베딩: 0.5B 및 1.5B에서 SOTA 코드 검색
코드 생성 LLM → 코드 向量模型: 0.5B/1.5B 모델이 25개의 코드 검색 벤치마크에서 SOTA 성능을 달성했습니다.