


 jina-ai

사람들이 저희에게 묻는 흥미로운 질문 중 하나는 "임베딩 (Embeddings)의 분위기를 어떻게 확인하나요?"입니다. 물론 공용 벤치마크에서 진지하고 정량적인 평가를 위한 MTEB가 있지만, 개방형 도메인 또는 새로운 문제에 대해서는 어떻게 해야 할까요? 오늘은 디버깅 및 시각화를 위해 사용하는 작은 내부 도구를 공유하고자 합니다. 분위기 테스트 툴킷이라고 부를 수도 있습니다. 저희는 이것을 Correlations라고 부르며, GitHub에서 오픈 소스로 제공됩니다.
tag디자인
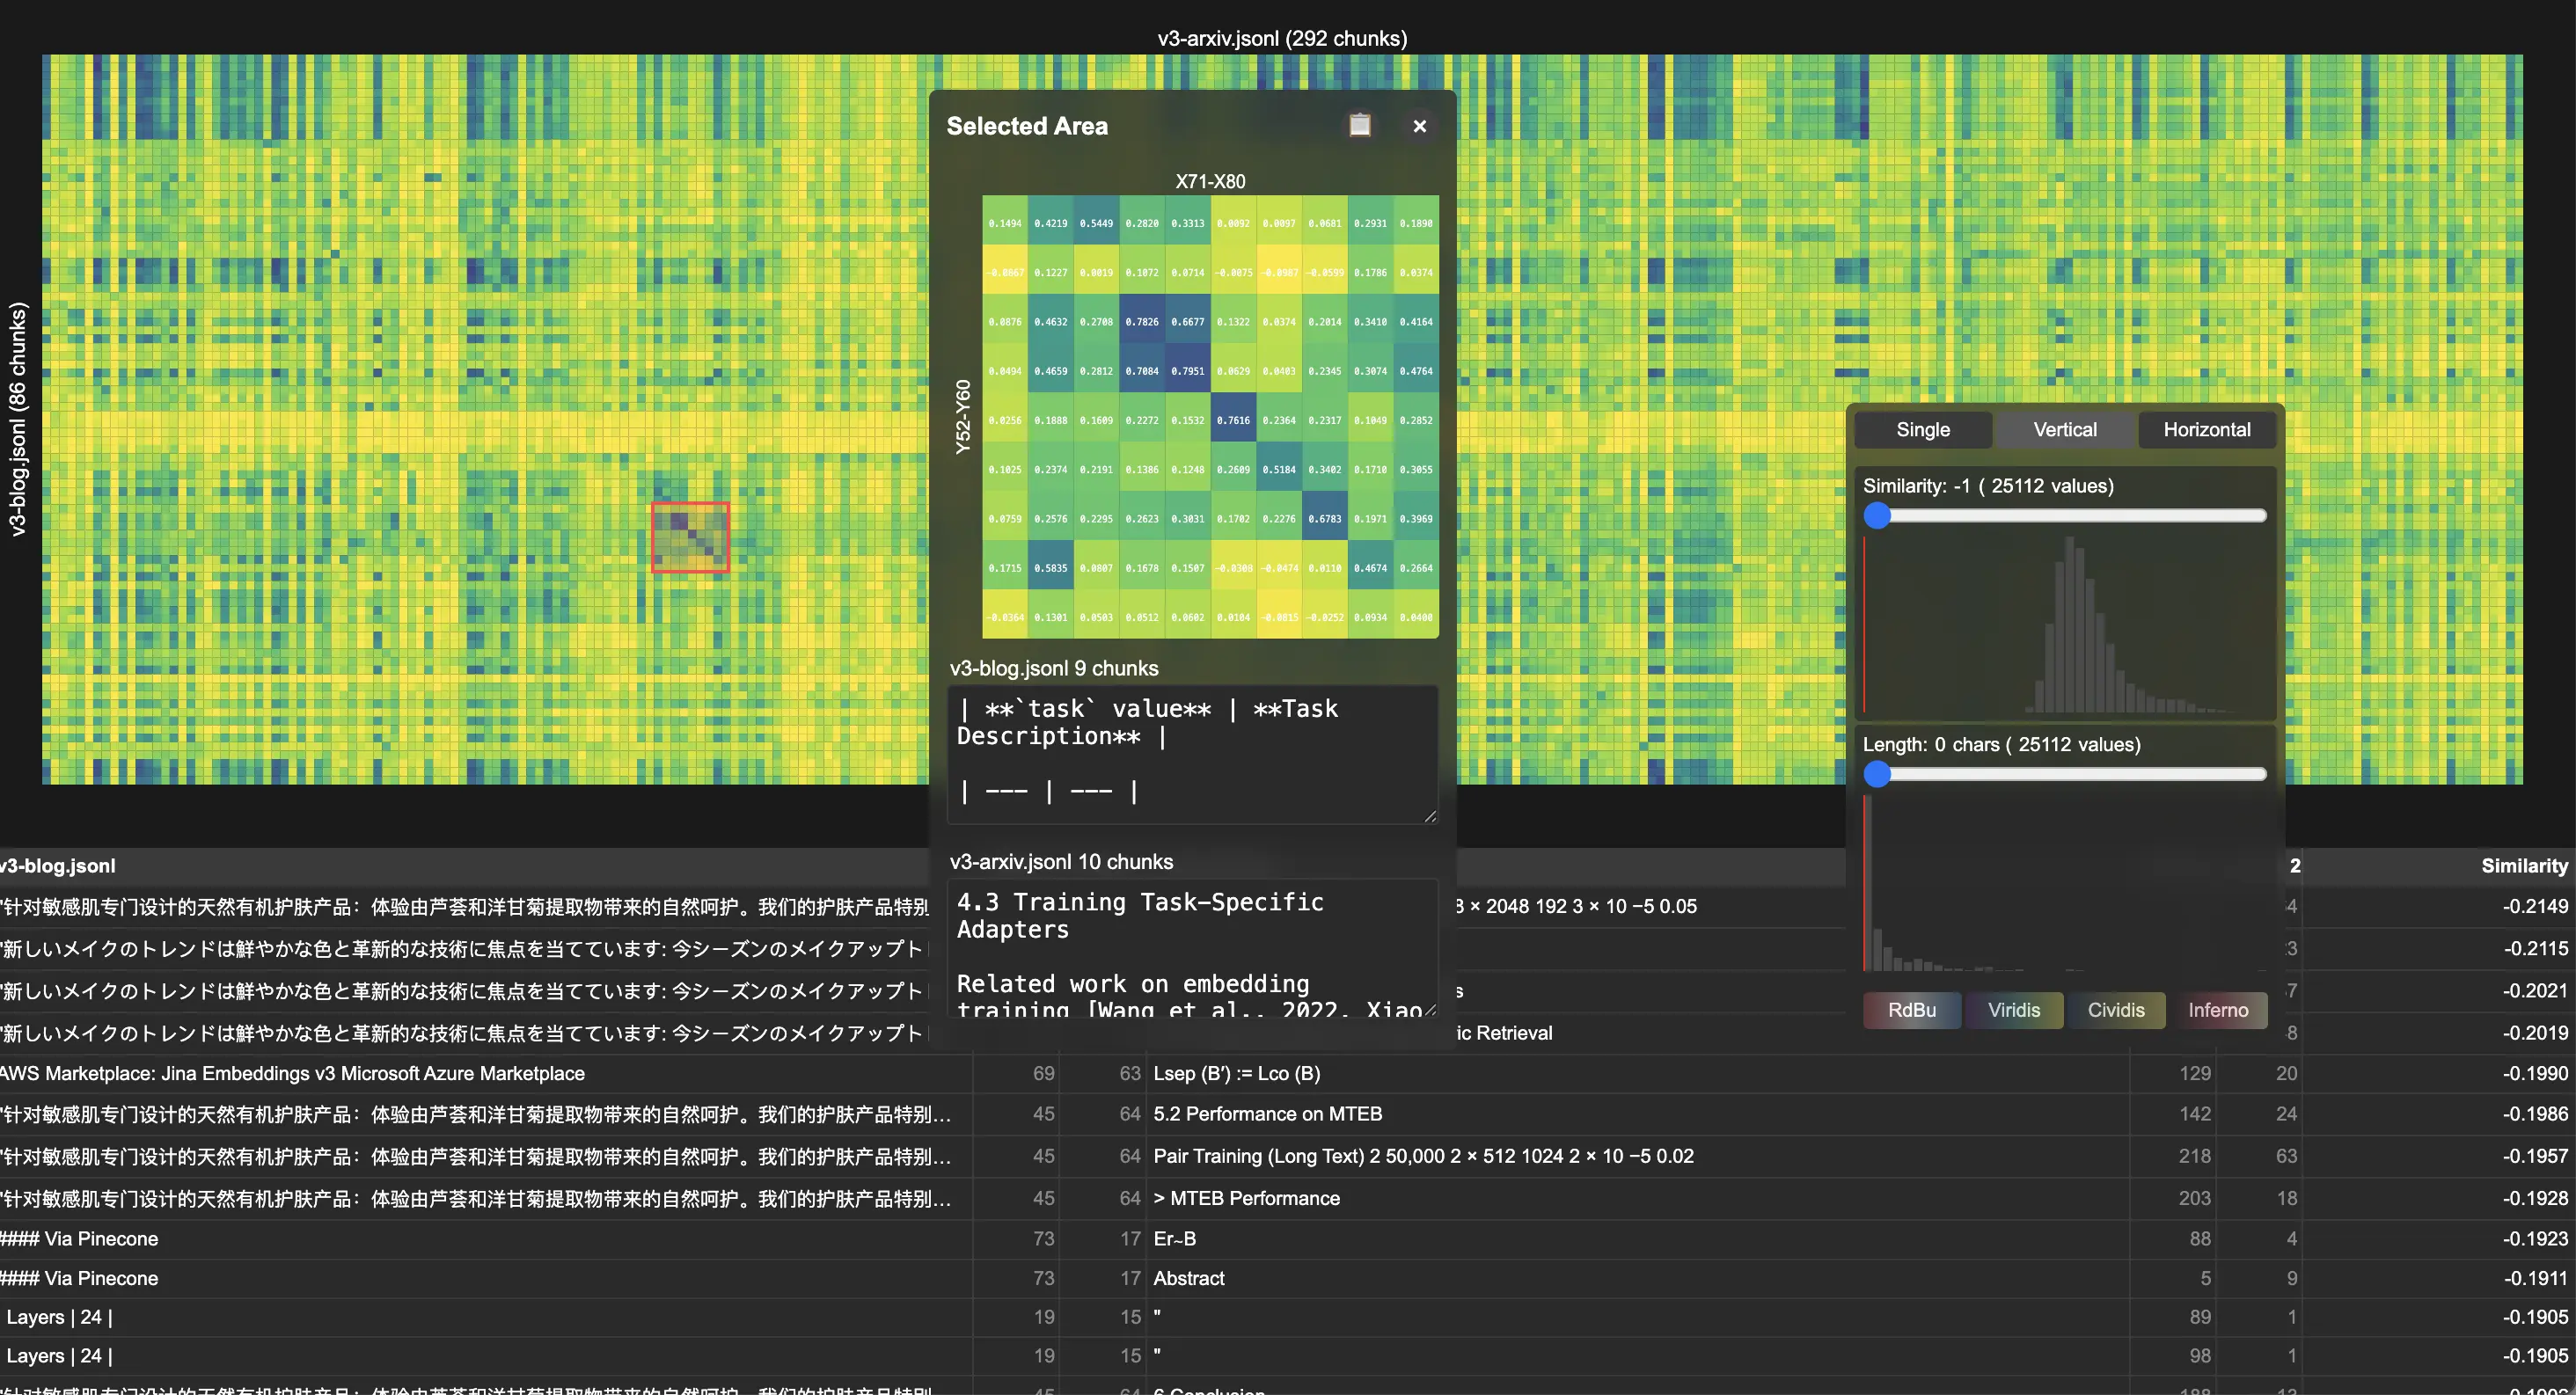
Correlations는 각 셀이 동일하거나 다른 문서 모음, 양식, 하이퍼파라미터 또는 모델의 청크인지 여부에 관계없이 두 조각 간의 코사인 유사성을 보여주는 대화형 히트맵을 생성합니다. 다음과 같은 여러 상호 작용을 지원합니다.
- 호버 검사: 개별 셀 쌍에 대한 원본 텍스트/이미지 및 유사성 점수
- 영역 선택: 유사성 패턴에 대한 집중 분석을 위한 대화형 영역 선택
- 임계값 필터링: 노이즈를 줄이기 위한 유사성 점수 및 텍스트 길이 필터
이 도구는 2단계 파이프라인을 통해 작동합니다.
npm run embed: 구성 가능한 청크 전략(줄 바꿈, 구두점, 문자 기반 또는 정규식 패턴)과 함께 Jina 임베딩 (Embeddings) API 사용npm run corr: 실시간 상호 작용이 가능한 상관 관계 히트맵을 제공하는 브라우저 기반 UI
시작하려면:
npm install
export JINA_API_KEY=your_jina_key_here
npm run embed -- https://jina.ai/news/jina-embeddings-v3-a-frontier-multilingual-embedding-model -o v3-blog.jsonl -t retrieval.query
npm run embed -- https://arxiv.org/pdf/2409.10173 -o v3-arxiv.jsonl -t retrieval.passage
npm run corr -- v3-blog.jsonl v3-arxiv.jsonlJINA_API_KEY는 필요할 때 URL에서 콘텐츠를 임베딩 (Embedding)하고 읽는 데 사용되며, 로컬 텍스트 파일에서 읽는 것도 물론 지원됩니다. 자신의 임베딩 (Embeddings)을 가져와서 시각화 전용으로 npm run corr을 수행할 수도 있으며, 이 경우 JINA_API_KEY가 필요하지 않습니다. 이 도구는 자체 상관 분석(단일 컬렉션 내)과 교차 상관 분석(두 컬렉션 간)을 모두 지원합니다.
tag사용 사례
tag콘텐츠 중복 제거 및 정렬 분석
저희는 jina-embeddings-v3 출판물 분석을 통해 이 도구의 유용성을 입증합니다. 학술 논문과 릴리스 노트를 비교하여 시각화 결과, 문서 간의 강력한 청크 간 정렬을 나타내는 상관 관계 히트맵에서 뚜렷한 대각선 패턴이 나타났습니다. 자세한 검사를 통해 특히 LoRA 작업 유형을 설명하는 기술 섹션에서 체계적인 콘텐츠 재사용이 나타났습니다.
tag인용 및 참조 유효성 검사
이 도구는 검색된 구절이 생성된 주장을 실제로 뒷받침하는지 확인하는 것이 중요한 검색 증강 생성 시스템에서 인용 정확성을 검증하는 데 유용합니다. 유사성 기반 분석은 예를 들어 유사성별로 항목을 그룹화하여 패턴을 밝히는 등 대규모 데이터 세트를 탐색하는 강력하고 직관적인 도구입니다.
tag청킹 전략 탐색
후기 청킹 및 기타 세분화 전략은 텍스트 세그먼트 내 및 세그먼트 간의 의미론적 일관성에 미치는 영향을 검토하여 평가할 수 있습니다. 시각화는 의미 구조와 일치하는 유사성 패턴을 보여줌으로써 후기 청킹 효과와 최적의 청크 경계를 식별하는 데 도움이 됩니다.
tag교차 양식 분석
이 도구는 jina-clip-v2를 통해 텍스트를 넘어 이미지 向量模型 (Embeddings)을 지원하여 멀티모달 애플리케이션을 위한 텍스트-이미지 상관 관계 패턴 분석을 가능하게 합니다.
tag向量模型 (Embedding) 시각화 관련 연구
해석 가능성 문제는 고차원 向量模型 (Embeddings)으로 작업할 때 특히 심각합니다. 向量模型 (Embedding) 시각화 기술은 크게 발전했으며, 다양한 접근 방식은 다음과 같이 분류할 수 있습니다.
- 차원 축소 기반: 고차원 공간을 2D/3D로 투영하는 PCA, t-SNE, UMAP를 사용하는 기존 접근 방식
- 대화형 탐색 기반: 직접 조작 및 탐색을 가능하게 하는 Parallax 및 TextEssence와 같은 도구
- 도메인별 솔루션: 생물학적 데이터를 위한 Clustergrammer와 같은 특수 도구
- 직접 유사성 시각화: 전체 관계 정보를 보존하는 당사의 접근 방식과 유사한 히트맵 기반 방법
| 방법 | 접근 방식 | 사용 사례 |
|---|---|---|
| Correlations | 직접 쌍별 유사성 히트맵 | 텍스트 유사성 디버깅, 정렬 분석 |
| Embedding Projector | PCA, t-SNE 및 사용자 정의 선형 투영 | 대화형 시각화 및 해석 |
| Parallax | 의미론적 탐색을 위한 대수 공식 | 의미론적 관계 이해 |
| TextEssence | 비교 코퍼스 분석 | 통시적 분석, 코퍼스 비교 |
| Nomic Atlas | 클라우드 기반 확장 가능한 시각화 | 대규모 데이터 세트, 협업 |
| Clustergrammer | 클러스터링이 포함된 대화형 히트맵 | 고차원 생물학적 데이터 |
| t-SNE | 비선형 클러스터 시각화 | 모델 디버깅, 혼동 식별 |
| UMAP | 로컬 및 글로벌 구조 보존 | 중간 규모-대규모 데이터 세트, 일반 분석 |
| PCA | 선형 차원 축소 | 초기 탐색, 기준선 비교 |
tag점 단위 접근 방식의 한계
기존 시각화 도구는 주로 2D 공간에서의 점 단위 표현에 중점을 두기 때문에 쌍별 관계에 대한 중요한 정보를 잃을 수 있습니다. 또한 대부분의 도구는 서로 다른 소스, 양식(modalities) 또는 向量模型 (Embedding) 전략(예: 후기 청킹 켜기/끄기) 간의 비교 평가보다는 단일 向量模型 (Embedding) 공간 분석을 위해 설계되었습니다.
예를 들어, 최근 Jina에서 두 가지 사용 사례를 발견했습니다. 첫 번째는 DeepSearch의 인용구를 교차 확인하는 것으로, 생성된 보고서를 참조 자료의 원본 발췌문과 일치시켜야 합니다. 두 번째는 멀티모달 검색으로, 새로운 레이블이 지정되지 않은 데이터에서 이미지-텍스트 및 이미지-이미지 정렬을 확인해야 합니다. 두 경우 모두 두 向量模型 (Embedding) 컬렉션 간의 관계를 탐색해야 합니다. 따라서 Correlations를 사용하여 일치 항목이 얼마나 잘 정렬되는지 파악하고 가장 높은 상관 관계가 일관되게 올바른 일치 항목에 해당하는지 확인합니다.
tag결론
단순한 느낌 확인을 넘어, correlations는 의미론적 관계에 대한 더 깊은 통찰력을 제공할 수 있습니다. 시작점으로, 상관 관계 행렬에서 몇 가지 주요 통계를 추출할 수 있습니다.
- 행렬 밀도: 지정된 임계값 이상의 상관 관계 비율로, 전체적인 의미론적 응집력을 나타냅니다.
- 고유값 분포: 주성분 분석은 유사성 구조의 지배적인 패턴을 보여줍니다.
- 행렬 순위: 유사성 관계의 유효 차원을 나타냅니다.
- 조건 수: 수치 안정성 및 잠재적 다중 공선성 문제를 측정합니다.
고급 분석에는 응집력 있는 의미론적 영역을 나타내는 의미 있는 부분 행렬을 추출하는 작업도 포함될 수 있습니다. n차 실수 행렬에서 k차 최대 합 주 부분 행렬을 추출하는 것은 가장 높은 상관 관계가 있는 세그먼트를 식별할 수 있는 일반적인 조합 최적화 문제입니다.


