Reader
LM-v2
 API Reader
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 Air-gapped
Обзор
ReaderLM-v2 — небольшая языковая модель на 1,54B параметров, которая с высокой точностью превращает беспорядочный HTML в чистый Markdown или JSON и обрабатывает документы до 512K токенов. Это идеальный инструмент для привязки больших языковых моделей к источникам: он переводит веб-контент в структурированные форматы, которые LLM эффективно используют. На задачах преобразования HTML в Markdown модель превосходит Qwen2.5-32B-Instruct и Gemini2-flash-expr, работая при этом за малую долю их стоимости.
Методы
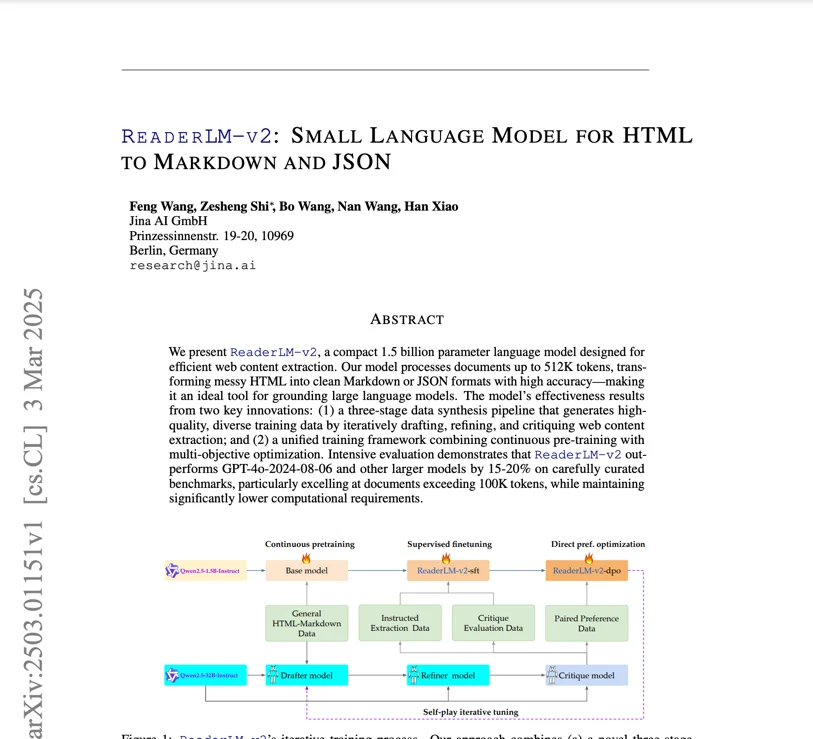
Эффективность модели обусловлена двумя ключевыми новшествами. Во-первых, трёхстадийный конвейер синтеза данных генерирует качественные и разнообразные обучающие данные, итеративно составляя, уточняя и критикуя извлечение веб-контента — этот подход на синтетических данных обеспечивает модель широким разнообразием HTML-структур без ручной разметки. Во-вторых, единый фреймворк обучения сочетает непрерывное предобучение с мультицелевой оптимизацией, позволяя модели одновременно обучаться конвертации HTML в Markdown и HTML в JSON. «Широкая и неглубокая» (shallow-but-wide) архитектура только декодирования (28 слоёв, 1536 скрытых измерений, 12 query-голов, 2 KV-головы) оптимизирована для операций выборочного копирования. Контекст в 512K токенов обеспечивается zigzag-ring-attention. Обучение с контрастивной потерей существенно снижает проблемы деградации.
Производительность
На задачах преобразования HTML в Markdown модель достигает ROUGE-L 0,84, Jaro-Winkler 0,82 и расстояния Левенштейна 0,22, превосходя Qwen2.5-32B-Instruct и Gemini2-flash-expr. На задачах HTML в JSON она сохраняет конкурентоспособное качество: F1 0,81 и доля успешных ответов 98 %. На GPU T4 модель обрабатывает 67 токенов/с на входе и 36 токенов/с на выходе. Обучение с контрастивной функцией потерь значительно снижает дегенерацию — циклы токенов и повторы в выводе. Контекстное окно в 512K токенов избавляет от чанкинга на большинстве реальных документов.
Рекомендации
Модель доступна через ноутбук Google Colab, демонстрирующий конвертацию HTML в Markdown, извлечение JSON и следование инструкциям. Для задач «HTML в Markdown» вводите необработанный HTML без префиксных инструкций. Для извлечения JSON укажите целевую схему в промпте. Вспомогательная функция create_prompt упрощает создание промптов для обеих задач. Модель работает на бесплатном уровне T4 GPU в Colab (требуются vllm и triton), но без поддержки bfloat16 или Flash Attention 2 имеет ограничения; для продакшена рекомендуется RTX 3090/4090. Доступна на AWS SageMaker, Azure и маркетплейсе GCP. Лицензия CC-BY-NC 4.0 для некоммерческого использования. Используйте эту модель как этап предобработки в RAG-конвейерах: конвертируйте веб-контент в чистый Markdown перед эмбеддингом с помощью jina-embeddings-v5-text-small.