Elastic
Jina AI
Модели
API
keyboard_arrow_down
Reader
Конвертируйте любой URL в Markdown для лучшей привязки LLM к источникам.
Эмбеддинги
Мультимодальные многоязычные векторные представления.
Реранкер
Реранкер для максимизации релевантности результатов поиска.
MCP
terminal
CLI
article
llms.txt
smart_toy
Агенты
data_object
Схема
menu_book
Документация
Авторизоваться
login
warning
Эта модель устарела из-за появления новых моделей.
Эмбеддинги
Лицензия Apache 2.0
open_in_new Пост о релизе

jina-clip-v1

Мультимодальные модели эмбеддинга для изображений и английского текста
Лицензия
Apache-2.0
Дата выпуска
calendar_month
2024-06-05
Вход
image
Изображение
abc
Текст
arrow_forward
Выход
more_horiz
Вектор
Подробности модели
Параметры: 223M
Длина входного токена: 8K
Размер входного изображения: 224×224
Выходной размер: 768
Базовая модель help_outline
open_in_new
EVA02-B-16
link
jina-embeddings-v2-base-en
Обученные языки help_outline
1 языки
Похожие модели
link
jina-clip-v2
link
jina-embeddings-v3
link
jina-colbert-v2
Доступно через
API Jina AI
AWS SageMaker
Microsoft Azure
Hugging Face
Air-gapped
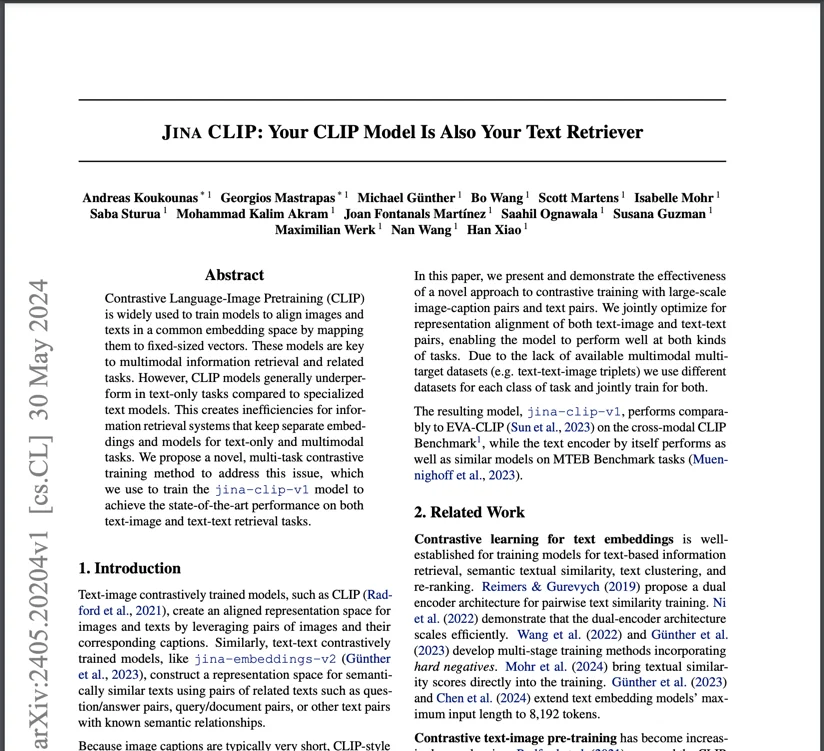
График ввода-вывода 1

Текст

jina-clip-v1

Вектор

График ввода-вывода 2

Изображение

jina-clip-v1

Вектор

Парето-фронт help_outline
workspace_premium
MTEB English
ViDoRe v1
MIEB
CLIP Benchmark
CLIP Benchmark · t2i-recall@5
chevron_leftchevron_right
300M1B3.0B10B20406080100bge-visualized-m3BiModernVBERTDSE-Phi3dse-qwen2-2b-mrl-v1e5-vjina-clip-v2jina-embeddings-v3jina-embeddings-v4llama-nemoretriever-col…MoCa-3Bnemotron-colembed-vl-8b…nllb-siglip-largeONE-PEACESauerkrautLM-ColLFM2-45…SauerkrautLM-ColMinistr…siglip-so400m-patch14-3…SigLIP2-L-512/16VLM2VecVultronRetrieverFlash-Q…jina-clip-v1Параметры (лог)nDCG@5
Эта модель
На фронте
Jina AI
Другие
ViDoRe v1
17.72
Параметры
223M
Ранг по баллу
32 / 33
Парето-фронт
На фронте
Распределение значенийhelp_outline
AUC 0.8440
Корпус
Пары переводов
Поиск по документации
Изображение / баннер
0.6750.000.200.400.600.80
Связанные20.2%
Сложный отрицательный3.2%
Несвязанные1.2%
Рекомендуемые пороги
FPR 0.1 · 0.478
FPR 0.01 · 0.675
FPR 0.001 · 0.785
FPR 0.0001 · 0.823
сбалансированный · 0.376
AUC
0.8440
Потолок шума
0.779
Обрыв полноты
0.123
Измерено пар
119 / 11k
Компоненты вектораhelp_outline
-0.18-0.010.15
σ 0.0361 · 183k значений
Геометрия эмбеддинговhelp_outline
0768
Среднее по измерениям, наведите для диапазона
Уровень шума
0.283
Эффективных изм.
55 / 768
Выберите модели для сравнения
Публикации (1)
ICML 2024
май 30, 2024
Jina CLIP: Your CLIP Model Is Also Your Text Retriever

Обзор

jina-clip-v1 — мультимодальная эмбеддинг-модель на 223M параметров, достигающая передовых результатов как в поиске «текст в текст», так и «текст в изображение» — впервые среди моделей семейства CLIP. В отличие от стандартных CLIP-моделей, жертвующих поиском только по тексту ради кросс-модального согласования, jina-clip-v1 использует мультизадачное контрастивное обучение, чтобы сохранять сильный результат во всех сочетаниях поиска. Поддерживается текстовый контекст 12 288 токенов — в 100 раз больше лимита в 77 токенов исходного CLIP.

Методы

Архитектура сочетает адаптированный текстовый энкодер Jina BERT v2 (12 288 токенов благодаря ALiBi) с энкодером изображений EVA-02 от Beijing Academy for AI. Ключевое новшество — метод мультизадачного контрастивного обучения: модель обучается одновременно на (1) парах «изображение-подпись» для кросс-модального согласования, (2) парах «текст-текст» для сохранения качества поиска только по тексту и (3) более длинных описаниях изображений, сгенерированных ИИ, для устойчивости к разной длине текста. На финальном этапе используются тройки текста с трудными негативами для обострения семантического различения. Этот мультизадачный подход предотвращает катастрофическое забывание при поиске только по тексту, характерное для стандартного обучения CLIP. Энкодер изображений обрабатывает тайлы 224×224 пикселей; каждый тайл расходует 1000 токенов вычислительной мощности.

Производительность

В поиске только по тексту модель даёт прирост производительности на 165% по сравнению с OpenAI CLIP (0,429 против 0,162 на MTEB). Для задач с изображениями: на 2% лучше в «текст в изображение» (0,899), на 6% в «изображение в текст» (0,803) и на 12% в «изображение в изображение» (0,916). В zero-shot визуальной классификации (CIFAR-100) превосходит стандартный CLIP. Кросс-модальные результаты на Flickr8k/30k и MSCOCO Captions конкурентоспособны со специализированными одно-модальными моделями. Текстовый контекст 12 288 токенов — большое преимущество для поиска длинных текстовых документов наряду с изображениями. В 2026 году jina-clip-v2 заменяет эту модель поддержкой 89 языков и обработкой изображений 512×512.

Руководство

Модель обрабатывает изображения тайлами 224×224 пикселя; каждый тайл расходует 1000 токенов. Изображение 750×500 пикселей требует 12 тайлов (12 000 токенов). Текст требует примерно 1,1 токена на слово. Планируйте бюджет токенов соответственно для смешанных мультимодальных запросов. Модель пока поддерживает только английский — для мультиязычных приложений используйте jina-clip-v2. Доступна через Jina Embeddings API и как open-source релиз на Hugging Face под лицензией Apache 2.0. Для продакшена варианты AWS Marketplace и Azure предоставляют оптимизированную инфраструктуру. Используйте косинусное сходство для кросс-модального сравнения. Для новых мультимодальных проектов предпочитайте jina-clip-v2 (89 языков, изображения 512×512, поддержка MRL) или jina-embeddings-v4 (контекст 32K, мульти-векторный режим, поддержка кода).

Блоги, в которых упоминается эта модель
июнь 25, 2025 • 12 минуты чтения
Jina Embeddings v4: Универсальные векторные модели (Embeddings) для мультимодального многоязыкового поиска
Jina Embeddings v4 — это универсальная модель векторного представления (Embeddings) с 3,8 миллиардами параметров для мультимодального и многоязыкового поиска, которая поддерживает вывод как одно-, так и многовекторных векторных представлений (Embeddings).
Jina AI
Word "Embeddings" followed by a numeric or symbol representation, displayed in multiple colors on a technology-themed, colorf
апрель 08, 2025 • 21 минуты чтения
jina-reranker-m0: Многоязычный мультимодальный ранжировщик документов
Представляем jina-reranker-m0, наш новый мультиязычный мультимодальный ранжировщик для поиска визуальных документов, демонстрирующий передовую производительность в задачах поиска многоязычных длинных документов и программного кода.
Jina AI
Modern dot matrix text display on a dark blue background, conveying a digital feel.
декабрь 12, 2024 • 12 минуты чтения
Масштабирование вычислений во время тестирования для моделей встраивания
Качество результатов растет с увеличением вычислений — больше на обучение, больше на поиск. Хорошая предварительно обученная модель дает отличный старт, но вычисления во время тестирования продвигают вас еще дальше. Важно понимать эту новую парадигму масштабирования вычислений во время тестирования, даже для моделей встраивания.
Han Xiao
David Hockney artwork of a hand holding a rod with three colored spheres on a blue-toned background.
декабрь 04, 2024 • 13 минуты чтения
Нужно ли всё ещё разбивать текст на части, когда модели с длинным контекстом могут обрабатывать его целиком?
Сравнение эффективности моделей встраивания с длинным контекстом при использовании различных стратегий разбиения на чанки для поиска оптимального подхода под ваши задачи.
Michael Günther
Alex C-G
Artistic pixel art of two seagulls on colored pipes with speech bubbles; one reads "Too long?" and the other shows math equat
ноябрь 21, 2024 • 9 минуты чтения
Jina CLIP v2: Мультиязычные мультимодальные эмбеддинги для текста и изображений
Jina-CLIP v2 — мультимодальная модель эмбеддингов размером 0.9B с многоязычной поддержкой 89 языков, высоким разрешением изображений 512x512 и представлениями Matryoshka.
Jina AI
Digital number "2" displayed in a mosaic of colorful squares against a dark background, creating a futuristic vibe.
Текущий язык / тема
Search Foundation
Reader
Эмбеддинги
Реранкер
Получить API-ключ Jina
Ограничение скорости
О нас
Новости
Загрузить логотип Jina
open_in_new
Скачать логотип Elastic
open_in_new
Статус API
Elastic © 2026.БезопасностьУсловия использованияКонфиденциальностьУправление файлами cookieНе продавайте и не передавайте мою личную информацию третьим лицам.
Данный веб-сайт и весь связанный с ним контент, программное обеспечение, продукты и услуги предназначены исключительно для профессионального использования. Использование в потребительских целях не предполагается и не рекомендуется.