

 Эмбеддинги
 Реранкер
jina-colbert-v2
 API Jina AI
 AWS SageMaker
 Microsoft Azure
 Google Облако
 Hugging Face
 Air-gapped
Обзор
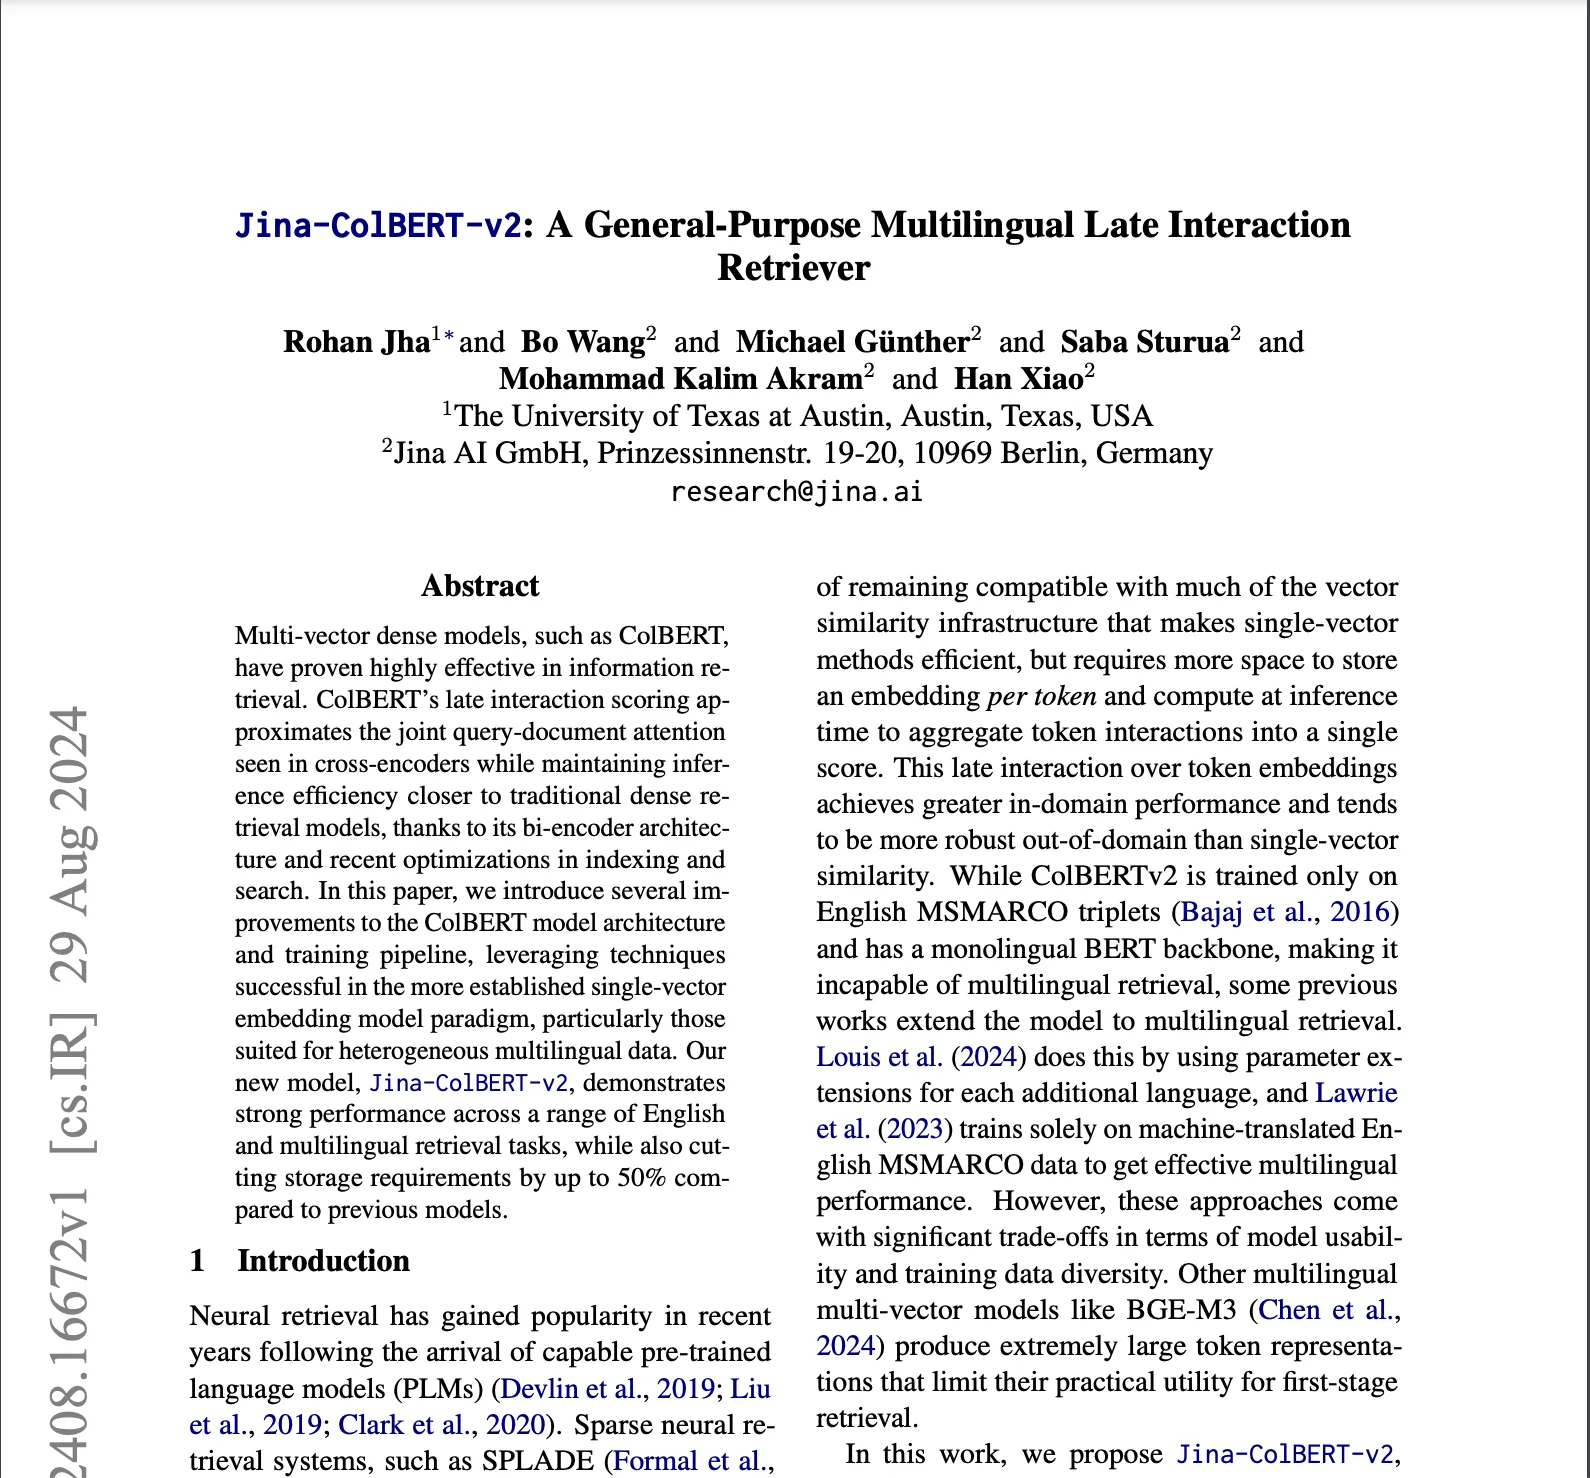
jina-colbert-v2 — мультиязычная late-interaction поисковая модель на 560M параметров, поддерживающая 89 языков. Это первая мультиязычная модель типа ColBERT, генерирующая компактные эмбеддинги на уровне токенов (64–128 измерений на токен), что обеспечивает масштабируемый и экономичный мультиязычный поиск. Обучение представлений Matryoshka позволяет снизить размерность с 128 до 64 при падении качества всего на 1,5%, вдвое сокращая требования к хранилищу.
Методы
Модель построена на архитектуре late-interaction ColBERT с модифицированным бэкбоном XLM-RoBERTa (560M параметров), усиленной rotary position embeddings и оптимизированной Flash Attention. Обучение включает два ключевых этапа: (1) начальное предобучение на разнообразных слабо-надзорных данных различных языков, (2) дообучение на размеченных тройках данных с контролируемой дистилляцией из более крупной учительной модели. Ключевая инновация — реализация обучения представлений Matryoshka для мульти-векторных эмбеддингов: модель производит векторы на уровне токенов в 128, 96 или 64 измерениях из одного процесса обучения, обеспечивая динамическую оптимизацию хранилища без переобучения. Контекст документов в 8 192 токенов (расширяемый до 12 288) и лимит запросов в 32 токена управляются ALiBi позиционным кодированием.
Производительность
Модель достигает улучшения на 6,5% по сравнению с исходным ColBERT-v2 на английских задачах, со средним счётом 0,521 на 14 бенчмарках BEIR. Она превосходит традиционные методы поиска на основе BM25 во всех тестируемых языках на бенчмарках MIRACL, демонстрируя особую силу в межъязыковых сценариях. Снижение с 128 до 64 измерений приводит лишь к 1,5% потери качества, вдвое сокращая требования к хранилищу — например, хранение 100 миллионов документов с 64-мерными векторами стоит 659,62 $/месяц на AWS, против 1 319,24 $ для 128 измерений. Мультиязычный охват модели (89 языков) и компактные эмбеддинги на уровне токенов делают её уникально подходящей для глобальных поисковых приложений.
Руководство
Модель требует аппаратного обеспечения с поддержкой CUDA для оптимальной производительности. Она поддерживает длину документов до 8 192 токенов (расширяемую до 12 288), ограничивая запросы 32 токенами. Для продакшен-развёртывания доступна через Jina Search Foundation API, AWS marketplace и Azure, с некоммерческой версией на Hugging Face. При реализации указывайте, что именно вы эмбеддите — запросы или документы: модель использует асимметричное кодирование. Модель не рассчитана на обработку в реальном времени сверхбольших коллекций документов без должной индексации; для ANN-поиска используйте FAISS, Qdrant или Weaviate. Для задач в специфической области рассмотрите дообучение на вашем корпусе. Для поиска с единственным вектором и выходом в больших измерениях рассмотрите jina-embeddings-v4 (режим мульти-векторов) или jina-embeddings-v5-text-small.




