Эмбеддинги
jina-embeddings-v3
 Elastic Inference Service
 API Jina AI
 AWS SageMaker
 Microsoft Azure
 Google Облако
 Hugging Face
 Air-gapped

Обзор
jina-embeddings-v3 — мультиязычная текстовая embedding-модель на 570M параметров, поддерживающая 89 языков и окно контекста в 8 192 токена. Её определяющая инновация — использование специализированных LoRA-адаптеров: тот же 570M-бэкбон производит оптимизированные эмбеддинги для retrieval, классификации, кластеризации и text-matching путём замены лёгких весов адаптеров (каждый менее 60M параметров). При релизе она достигла SOTA-качества по MTEB, превзойдя проприетарные эмбеддинги OpenAI и Cohere на английских задачах.
Методы
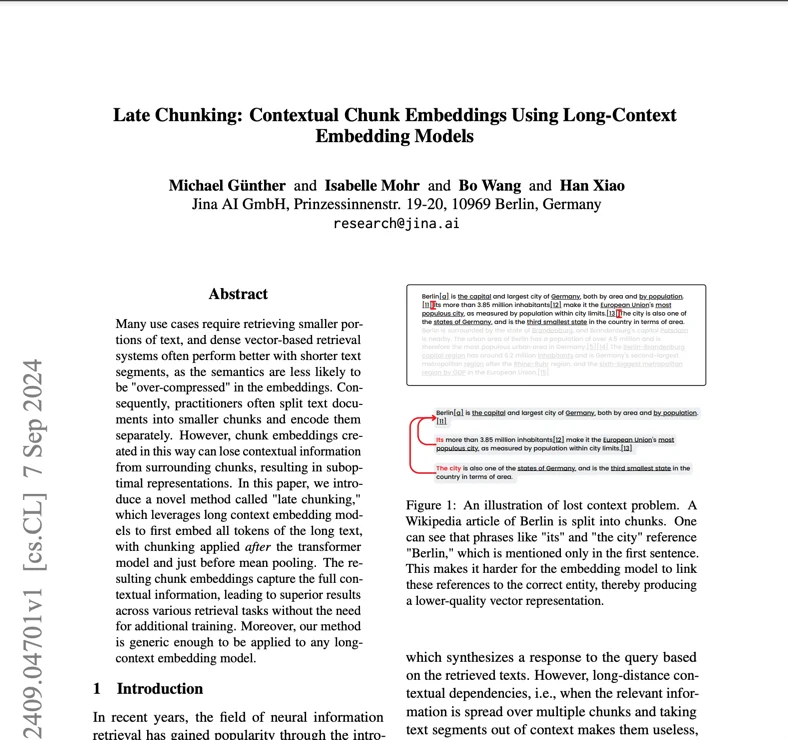
Модель построена на бэкбоне jina-XLM-RoBERTa с 24 слоями трансформера, используя Rotary Position Embeddings (RoPE) с настроенной базовой частотой для экстраполяции длинного контекста до 8 192 токенов. Обучение следовало трёхэтапной программе: (1) мультиязычное предобучение на 89 языках, (2) контрастная дообучка на наборах данных с парным текстом для формирования базового качества эмбеддингов, (3) обучение специализированных LoRA-адаптеров. Каждый LoRA-адаптер добавляет менее 3 % к общему числу параметров, специализируя модель для конкретной задачи: retrieval.query и retrieval.passage для асимметричного поиска, separation для кластеризации, classification для категоризации и text-matching для семантического сходства. Matryoshka Representation Learning (MRL) позволяет урезать эмбеддинги с 1024 до 32 измерений, сохраняя более 90 % качества retrieval при 64 измерениях. Поддерживается late chunking для документов, превышающих окно контекста.
Производительность
На MTEB jina-embeddings-v3 достигла среднего балла 65,52 по всем задачам, с особенно сильными результатами в классификации (82,58) и сходстве предложений (85,80). Она превзошла multilingual-e5-large-instruct на всех мультиязычных задачах и обошла e5-mistral-7b-instruct (в 12× больше параметров) на английских задачах. На мультиязычном MTEB она набрала 64,44, продемонстрировав стабильное качество на 89 языках. Урезание MRL сохранило 92 % качества retrieval при 64 измерениях против полных 1024. В 2026 году jina-embeddings-v5-text-small вытесняет эту модель для большинства задач, предлагая контекст 32K и обучение на основе дистилляции с более высокой точностью на параметр.
Руководство
Выберите подходящий LoRA-адаптер для вашей задачи: retrieval.query/retrieval.passage для поиска, separation для кластеризации, classification для категоризации, text-matching для семантического сходства. Используйте параметр `late_chunking для документов, превышающих 8 192 токенов. Урезание Matryoshka до 256 или 512 измерений подходит для индексации с ограничениями хранилища; для re-ranking используйте полные 1024 измерения. Модель требует GPU с поддержкой CUDA для продакшн-пропускной способности. Для новых мультиязычных проектов предпочтительна jina-embeddings-v5-text-small` (контекст 32K, обучение дистилляцией, более высокая точность). Модель не рассчитана на генерацию текста или сложное рассуждение — она производит эмбеддинги, а не текст.