Эмбеддинги
jina-embeddings-v5-omni-small
 GGUF
 MLX
 Elastic Inference Service
 API Jina AI
 AWS SageMaker
 Hugging Face
 MacOS
 Air-gapped
Обзор
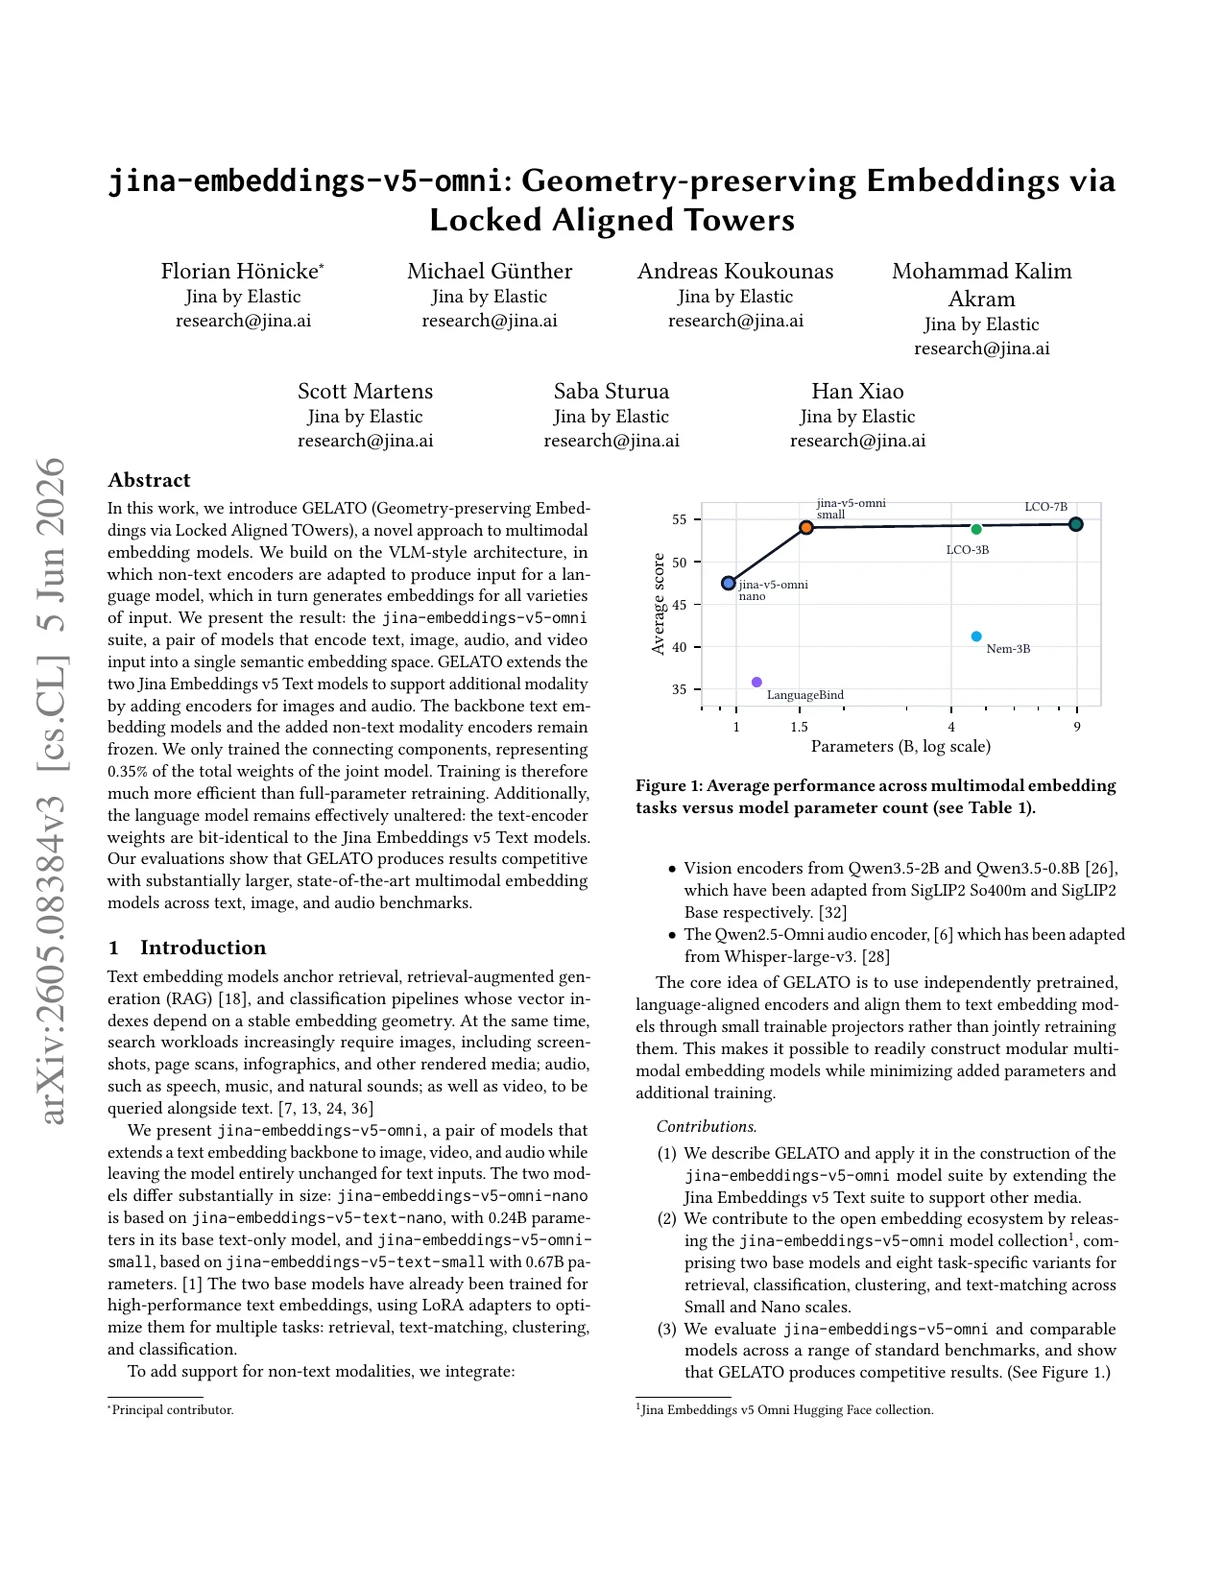
jina-embeddings-v5-omni-small — мультимодальная embedding-модель примерно на 1,74B параметров, принимающая текст, изображения, видео, аудио и PDF и формирующая эмбеддинги в общем 1024-мерном векторном пространстве. Это модель эмбеддингов по умолчанию для API Jina, и она обеспечивает наилучший баланс точности и эффективности среди мультимодальных embedding-моделей Jina. Выводы только для текста побитово идентичны jina-embeddings-v5-text-small, что позволяет бесшовно мигрировать с текстового режима на мультимодальный без реиндексации.
Методы
Модель обучается на третьей стадии, расширяющей jina-embeddings-v5-text-small. Во время мультимодального обучения текстовый backbone Qwen3-0,6B-Base и все четыре task-specific LoRA-адаптера замораживаются; обучаются заново только кросс-модальные проекторы. Vision-энкодер SigLIP2 Large обрабатывает изображения и видео (32 равномерно выбранных кадра на видео). Audio-энкодер Whisper-large-v3 обрабатывает аудио-вход. Страницы PDF рендерятся как изображения и обрабатываются через визуальный путь. Обучение использует контрастивный loss с кросс-модальными жёсткими негативами для выравнивания визуальных и аудио-представлений с существующим текстовым пространством эмбеддингов. Вывод в 1024 измерений поддерживает обрезку Matryoshka до 32 измерений. 32K-токенное контекстное окно покрывает текстовый вход. Модель поддерживает квантованный и MLX инференс для Apple Silicon.
Производительность
Производительность только для текста побитово идентична jina-embeddings-v5-text-small (67,0 MMTEB в среднем на уровне задач, 71,7 английский MTEB) — текстовый backbone и LoRA-адаптеры не затрагиваются при мультимодальном обучении. В кросс-модальном поиске модель демонстрирует сильное выравнивание на задачах text-image, text-audio и text-video. Поиск страниц PDF обрабатывается через визуальный путь. Модель omni-small обеспечивает наилучший баланс точности и эффективности среди мультимодальных embedding-моделей Jina для серверного развёртывания, причём эмбеддинги в 1024 измерений обладают бо́льшей дискриминирующей силой, чем 768-мерный вариант omni-nano.
Руководство
Выберите подходящий LoRA-адаптер: retrieval, text-matching, clustering или classification. Для мультимодальных входов через API передавайте напрямую URL изображений, URL аудиофайлов, URL видеофайлов или URL PDF — модель направляет каждую модальность через соответствующий энкодер. Поддерживаемые аудиоформаты включают WAV, MP3, FLAC, OGG, M4A и Opus. Видеовходы обрабатываются как 32 равномерно выбранных кадра. Модальности можно свободно смешивать в рамках одного батча: пространство эмбеддингов общее для всех модальностей. Используйте косинусное сходство для сравнения. Обрезка Matryoshka с 1024 до 32 измерений поддерживается. Текстовые эмбеддинги drop-in совместимы с jina-embeddings-v5-text-small — при обновлении реиндексация не нужна. Для edge-развёртывания без GPU используйте вместо этого jina-embeddings-v5-omni-nano.