Эмбеддинги
jina-embeddings-v5-text-nano
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Hugging Face
 Air-gapped
Обзор
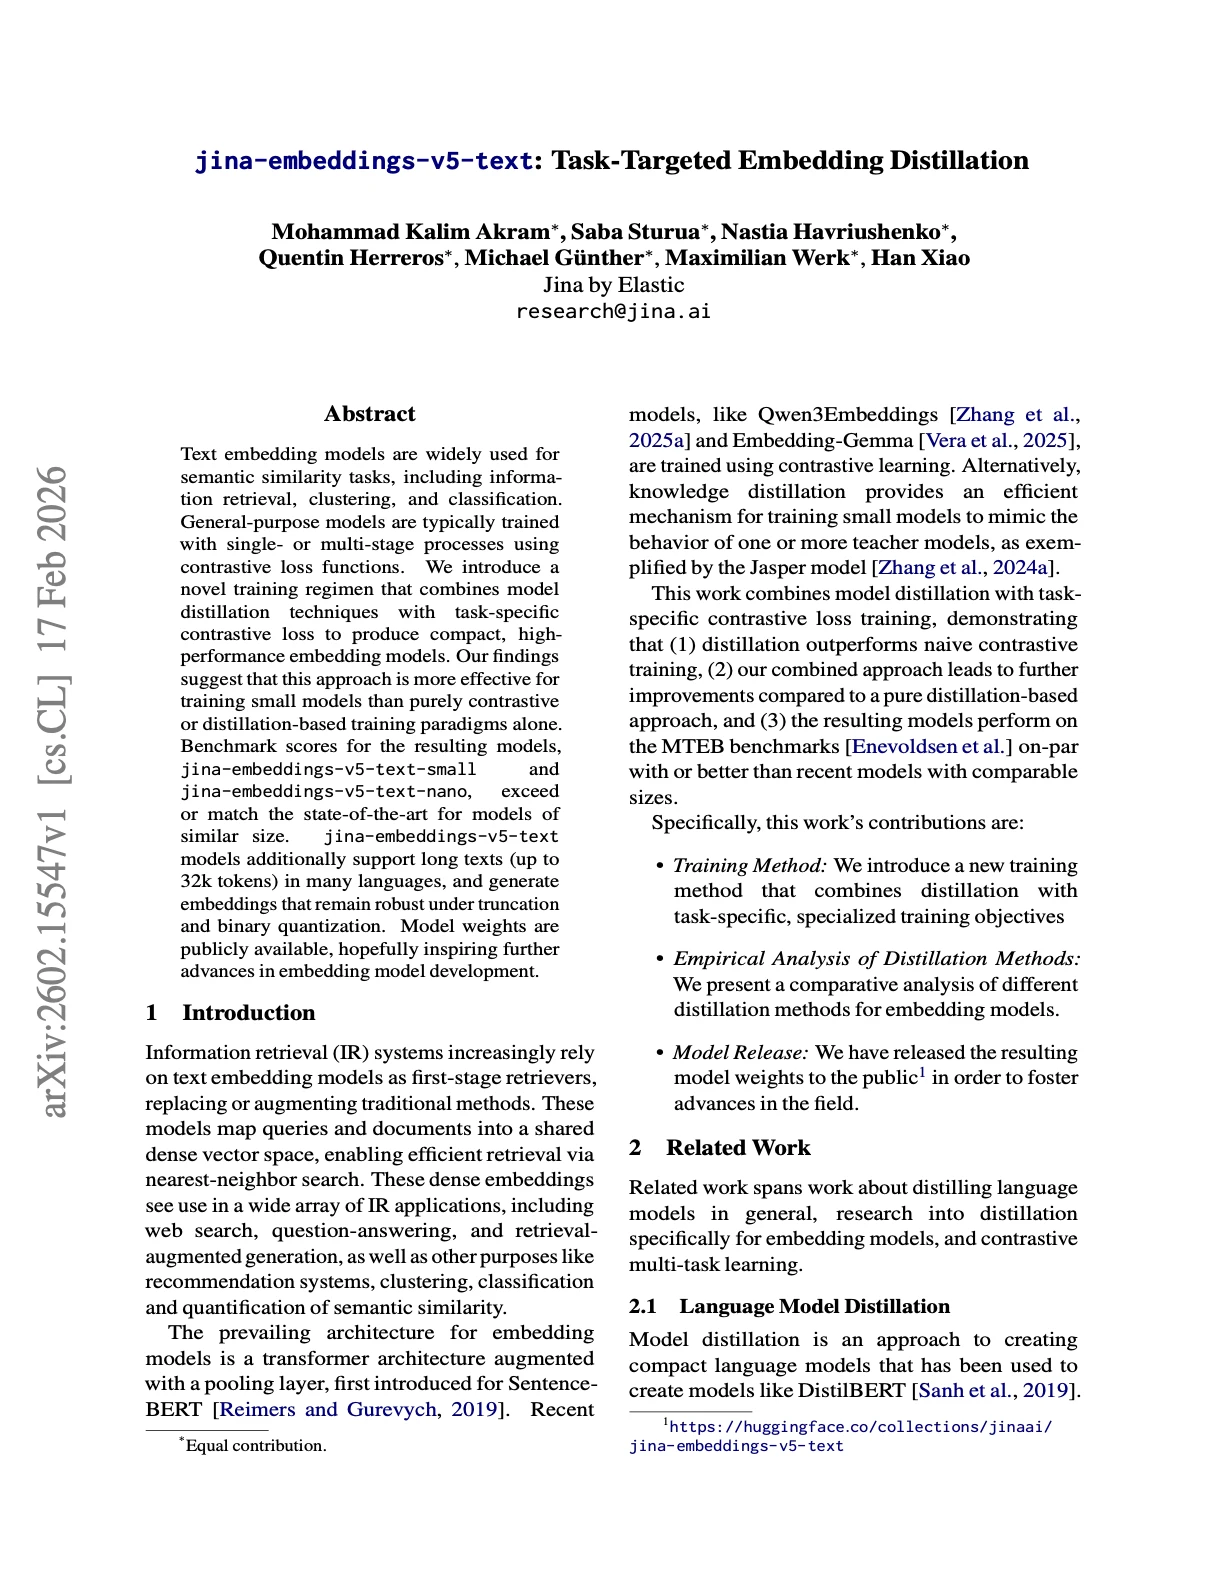
jina-embeddings-v5-text-nano — мультиязычная текстовая эмбеддинг-модель на 239M параметров, построенная на backbone EuroBERT-210M. Она поддерживает 8K-токенный контекст, формирует 768-мерные эмбеддинги с обрезкой Matryoshka до 32 измерений и даёт наибольшую точность на параметр в семействе эмбеддинг-моделей Jina под 500M. Рассчитана на edge-развёртывание, чувствительные к задержке приложения и среды с ограничением ресурсов, где нет полноценной GPU.
Методы
Модель построена на EuroBERT-210M — компактном двунаправленном энкодере, обученном на мультиязычных данных, покрывающих 15 основных языков. Она использует Last-Token-Pooling для формирования эмбеддингов из представления финального токена. Обучение следует двухэтапному рецепту дистилляции: во-первых, дистилляция знаний из более крупной модели-учителя передаёт качество эмбеддингов; во-вторых, task-специфичный контрастивный loss дообучает модель на задачах поиска, text-matching, кластеризации и классификации. Matryoshka Representation Learning позволяет обрезать размерность эмбеддингов до любого поддерживаемого размера (32, 64, 128, 256, 512, 768), сохраняя сильную производительность. Geometric Orthogonal Regularization (GOR) ограничивает деградацию качества под бинарной квантизацией менее чем 2 пунктами в MTEB retrieval. 8K-контекстное окно обеспечивает обработку длинных документов без чанкинга.
Производительность
На MMTEB (мультиязычный) модель достигает в среднем 65,5 (уровень задач) и 57,7 (уровень типов) всего при 239M параметрах, превосходя все модели с числом параметров менее 500M, включая KaLM-mini-v2.5 (60,1, 494M), voyage-4-nano (58,9, 480M) и Gemma-300M (61,1, 308M). Оценки по задачам: классификация 69,2, кластеризация 52,7, парная классификация 81,9, ранжирование 64,6, поиск 63,3, STS 78,2. На английском MTEB она набирает 71,0 в среднем, почти догоняя гораздо более крупный jina-embeddings-v5-text-small (71,7). Поиск в частности: 63,26 на MTEB-M, 64,08 на RTEB, 56,06 на BEIR, 63,65 на LongEmbed. Благодаря регуляризации GOR эмбеддинги остаются устойчивыми при бинарной квантизации.
Рекомендации
Выберите подходящий task-префикс: 'retrieval' для асимметричного query-document поиска, 'text-matching' для симметричного сходства, 'clustering' для группировки, 'classification' для категоризации. Обрезка Matryoshka до 256 измерений сохраняет более 95% качества поиска, сокращая хранилище на 67%. Бинарная квантизация поддерживается для дальнейшего сокращения хранилища. Backbone EuroBERT хорошо покрывает 15 основных языков, включая английский, французский, немецкий, испанский, китайский, японский, арабский и хинди. Используйте косинусное сходство для сравнения эмбеддингов. Доступна через Jina AI API, Hugging Face (Sentence Transformers, vLLM) и квантованные варианты для llama.cpp. Для нагрузок, требующих 32K контекста или более высокой точности, используйте вместо этого jina-embeddings-v5-text-small.