Эмбеддинги
jina-embeddings-v5-text-small
 GGUF
 MLX
 Elastic Inference Service
 API Jina AI
 AWS SageMaker
 Hugging Face
 Air-gapped
Обзор
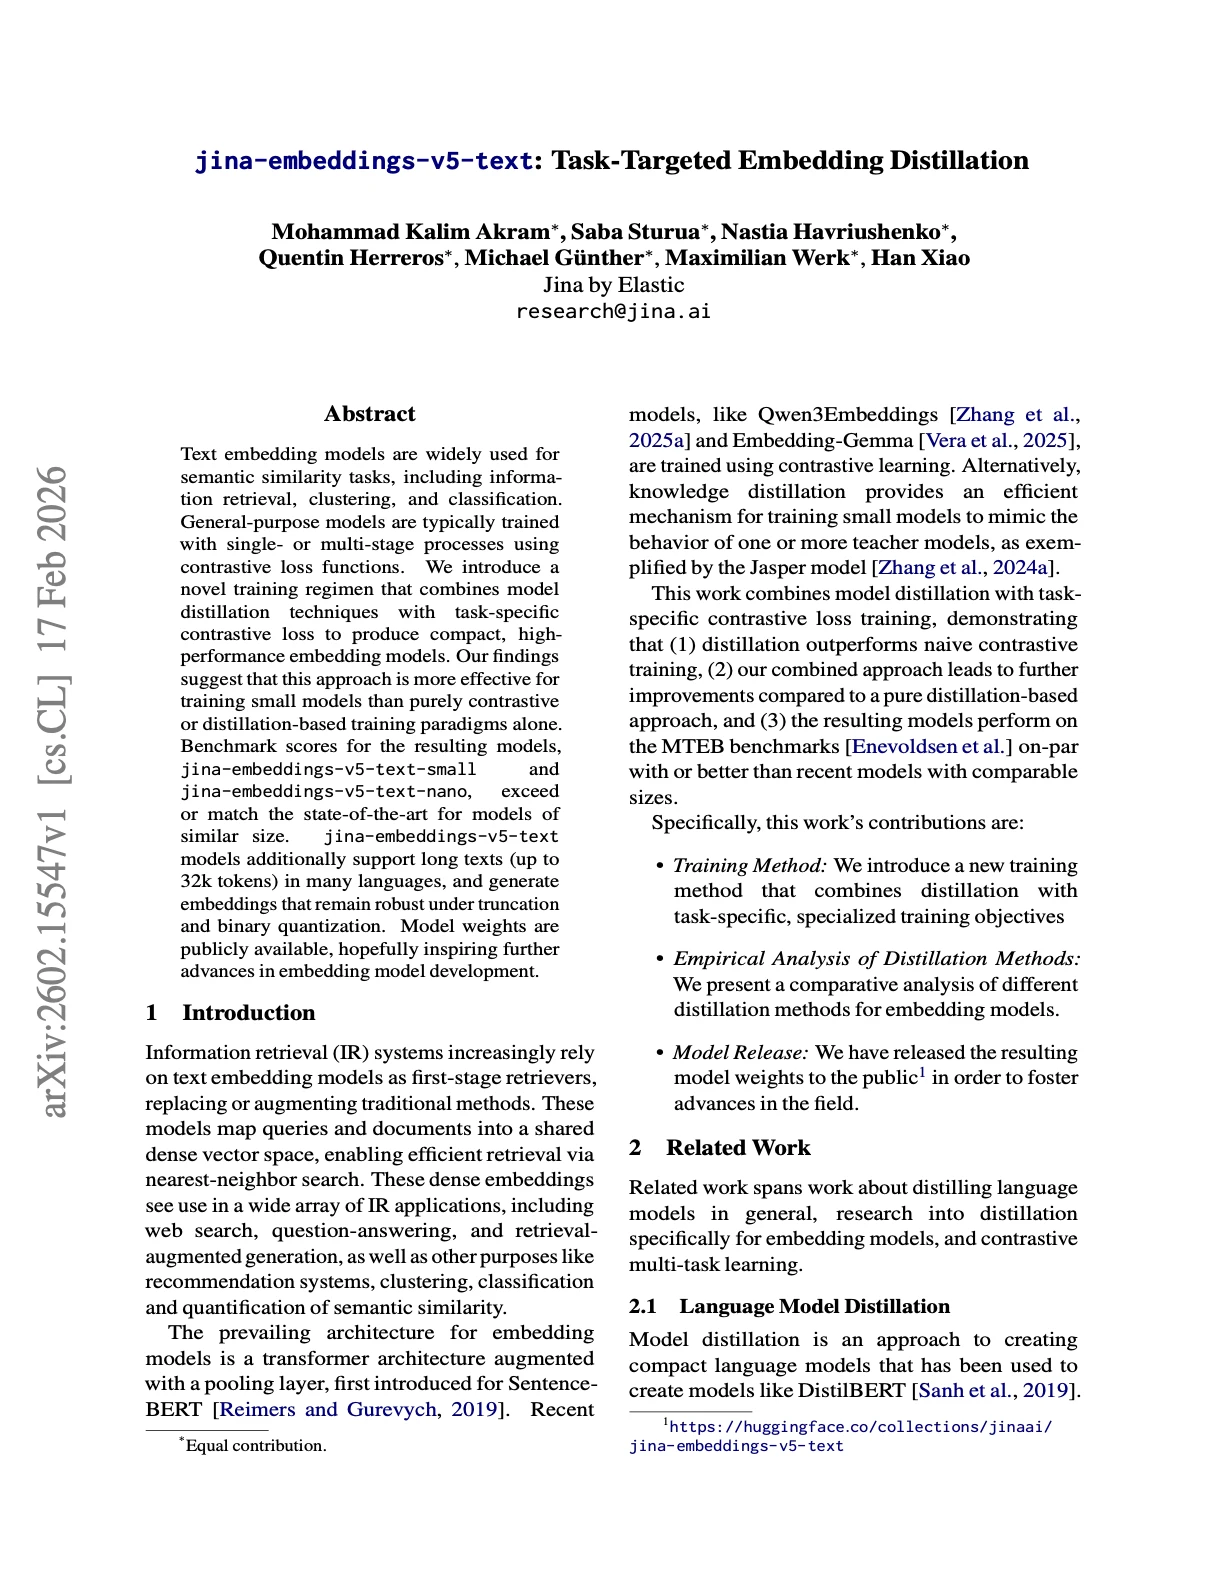
jina-embeddings-v5-text-small — мультиязычная текстовая embedding-модель на 677M параметров, построенная на backbone Qwen3-0,6B-Base. Она поддерживает 32K-токенный контекст, формирует 1024-мерные эмбеддинги с обрезкой Matryoshka до 32 измерений и набирает наивысший средний MTEB среди всех моделей с параметрами менее 1B. Это модель эмбеддингов по умолчанию для API Jina и основная рекомендация для продакшн RAG-конвейеров.
Методы
Модель построена на Qwen3-0,6B-Base — мультиязычной языковой модели, обученной на 119 языках. Она использует Last-Token-Pooling для формирования эмбеддингов. Обучение следует двухэтапному режиму: (1) дистилляция эмбеддингов из Qwen3-Embedding-4B (teacher на 4B параметров) передаёт высококачественные представления эмбеддингов студенту на 677M; (2) task-specific контрастивный loss дообучает модель на задачах поиска, text-matching, кластеризации и классификации. Geometric Orthogonal Regularization (GOR) гарантирует, что эмбеддинги остаются робастными при бинарной квантизации с минимальной потерей качества. Matryoshka Representation Learning позволяет обрезать размерность с 1024 до 32, сохраняя сильное качество поиска выше 256 измерений. 32K-контекстное окно обеспечивается rotary position embeddings с настроенными базовыми частотами, а модель дополнительно обучалась на данных длинного контекста для робастного поиска длинных документов.
Производительность
На MMTEB (мультиязычный) модель набирает 67,0 в среднем (уровень задач) и 58,9 в среднем (уровень типов) — наивысшее среди всех моделей с параметрами менее 1B. Оценки по задачам: классификация 71,3, кластеризация 53,4, парная классификация 82,9, ранжирование 65,7, поиск 64,9, STS 78,9. На английском MTEB — 71,7 в среднем, превосходя Qwen3-0,6B с инструкциями (70,5) и jina-embeddings-v3 (65,7). Поиск в частности: 64,88 на MTEB-M, 66,84 на RTEB, 56,67 на BEIR, 66,39 на LongEmbed. Примечательно: модель превосходит своего 4B teacher Qwen3-Embedding-4B в парной классификации (42,0 против 26,8 на MMTEB), при размере в 6 раз меньше, — доказательство того, что дистилляция в сочетании с task-specific контрастивным обучением способна превзойти качество teacher на отдельных задачах.
Руководство
Выберите подходящий LoRA-адаптер: 'retrieval' для асимметричного query-document поиска (префикс 'Query:' для запросов, 'Document:' для пассажей), 'text-matching' для симметричного сходства (префикс 'Document:' для обоих входов), 'clustering' для группировки связанных документов, 'classification' для категоризации и анализа тональности. Обрезка Matryoshka до 256–512 измерений подходит для индексации с ограничениями по хранению; для ранжирования используйте все 1024 измерения. Бинарная квантизация поддерживается с минимальной потерей качества. 32K-контекстное окно обрабатывает длинные документы нативно без чанкинга. Используйте косинусное сходство для сравнения эмбеддингов. Доступно через Jina AI API, Hugging Face (Sentence Transformers, vLLM) и квантованные варианты для llama.cpp. Для мультимодальных нагрузок используйте вместо этого jina-embeddings-v5-omni-small.