Реранкер
jina-reranker-v3.5
 GGUF
 MLX
 Elastic Inference Service
 API Jina AI
 AWS SageMaker
 Microsoft Azure
 Google Облако
 Hugging Face
 Air-gapped
Обзор
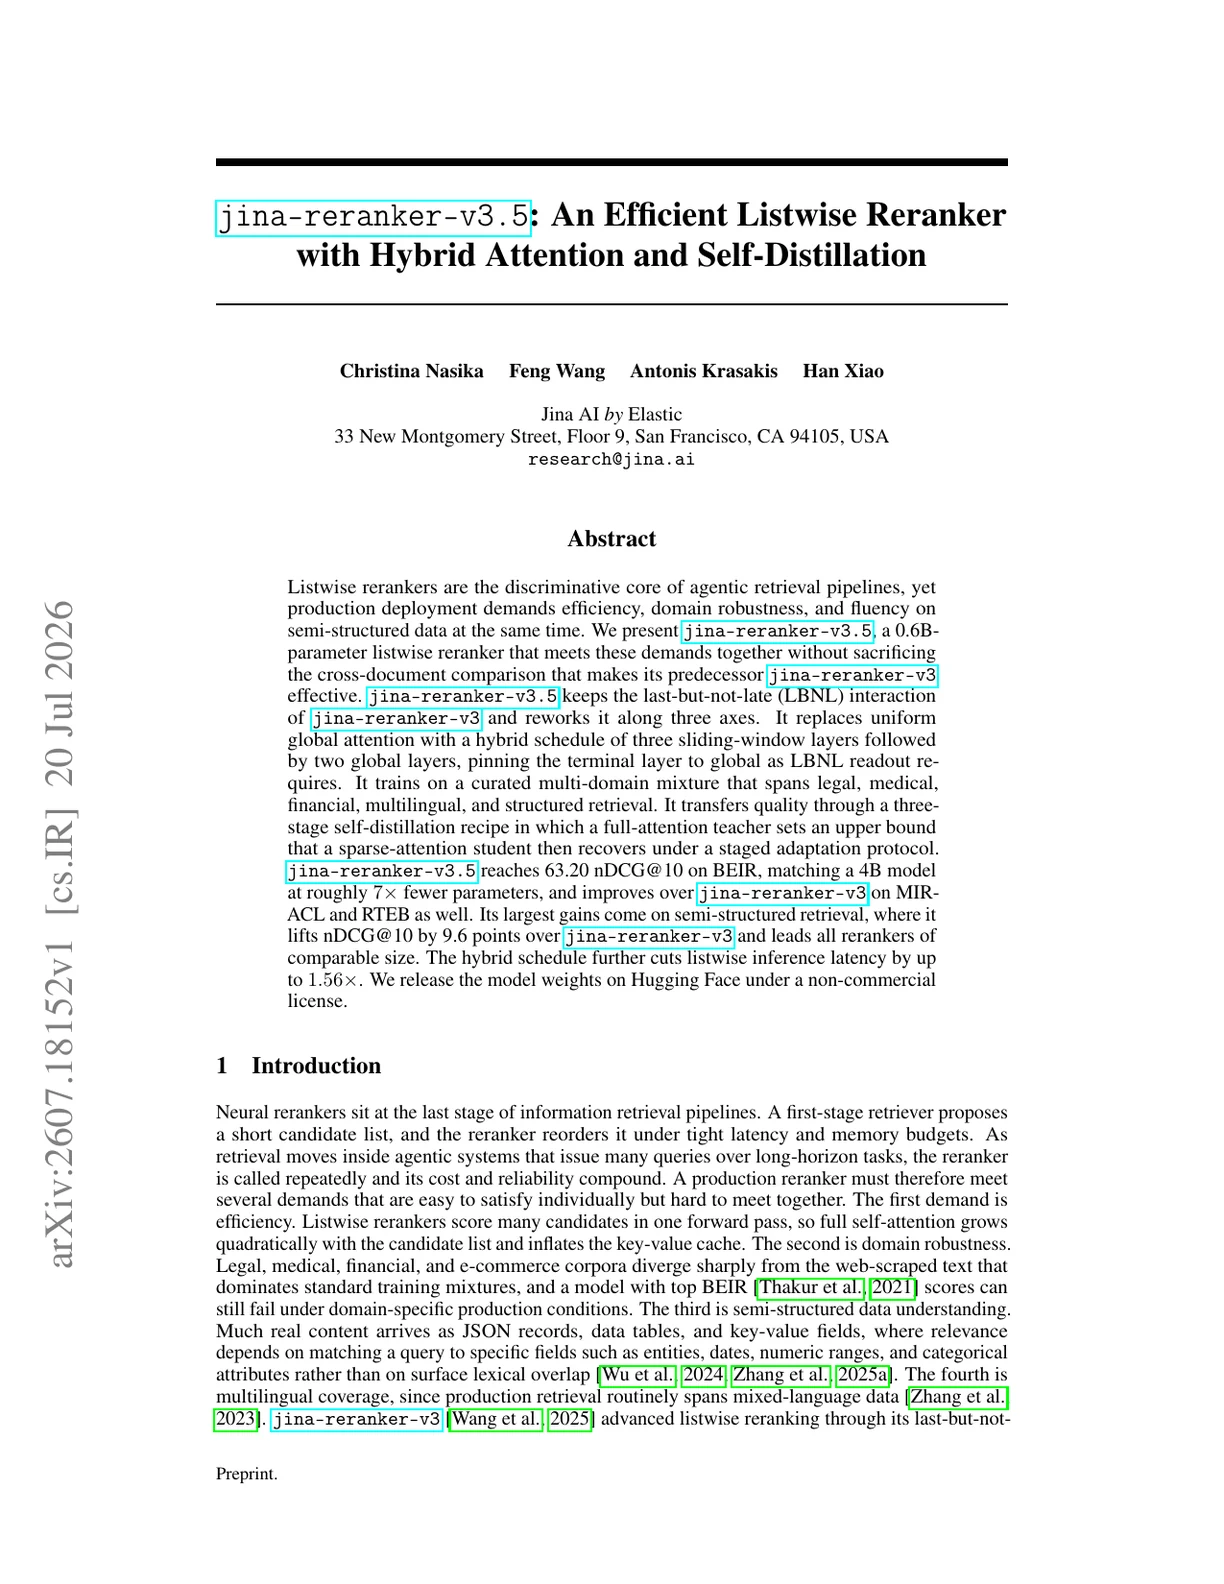
jina-reranker-v3.5 — listwise-реранкер на 0,6B параметров, сопоставимый с моделями на 4B параметров при примерно в 7 раз меньшем числе параметров. Он вводит гибридную раскладку внимания (три слоя скользящего окна + два глобальных слоя) в связке с трёхэтапным рецептом самодистилляции, переносящим качество от учителя с полным вниманием к ученику с разреженным вниманием. Это drop-in-замена jina-reranker-v3, сохраняющая ту же схему API при повышении эффективности и покрытия доменов.
Методы
Архитектура сохраняет listwise-дизайн LBNL из jina-reranker-v3: запрос и все кандидаты разделяют единое окно контекста, а эмбеддинги читаются из финального токена каждого документа. Ключевое нововведение — гибридная раскладка внимания. Вместо равномерного глобального внимания на каждом слое модель использует три слоя скользящего окна (ограничивающие внимание каждой позиции локальным окном), за которыми следуют два глобальных слоя. Конечный слой закреплён за глобальным вниманием, поскольку механизм чтения LBNL требует, чтобы финальный токен обращал внимание на весь контекст. Обучение идёт в три этапа: (1) учитель с полным вниманием обучается на курированной мультидоменной смеси, охватывающей юридическую, медицинскую, финансовую, мультиязычную и структурированную задачи поиска; (2) ученик с разреженным вниманием инициализируется от учителя и дообучается с поэтапной адаптацией, постепенно увеличивая долю шагов обучения с гибридной раскладкой; (3) финальный проход дистилляции, где ученик учится воспроизводить мягкие распределения рангов учителя, восстанавливая более 97 % качества ранжирования учителя при работе по более дешёвому пути разреженного внимания.
Производительность
По единому top-100 протоколу с jina-embeddings-v5-text-small в качестве первичного ретривера модель набирает 63,20 NDCG{'@'}10 на BEIR, 74,11 на MIRACL, 70,95 на RTEB и 48,3 на Struct-IR, улучшая jina-reranker-v3 (62,10 / 72,20 / 68,01 / 38,7) по каждой оси. Её результат на BEIR чуть обходит 4B Qwen3-Reranker (62,28) примерно при 7× меньшем числе параметров. Относительные приросты против v3 включают +1,10 BEIR, +2,6 % MIRACL, +4,3 % RTEB (с большими приростами в юридическом поиске) и +24,8 % в ранжировании структурированных данных (Struct-IR). Listwise-вывод работает в 1,22–1,56 раза быстрее v3 от коротких контекстов к длинным (A100, FlashAttention-2). Мультидоменная обучающая смесь даёт особенно сильные улучшения на полуструктурированных данных (таблицы, JSON, XML) и доменных корпусах.
Руководство
jina-reranker-v3.5 — drop-in-замена jina-reranker-v3: схема запроса не меняется, поэтому смена строки модели не требует изменений кода. Она ранжирует запрос против полного списка кандидатов в одном вызове — передавайте документы через стандартный endpoint rerank и используйте top_n для ограничения возвращаемых результатов, либо включите return_embeddings, чтобы также получить эмбеддинги документов. Модель особенно сильна в ранжировании структурированных данных, поиске в юридических и других специализированных доменах и мультиязычных коллекциях. Её дизайн с гибридным вниманием поддерживает низкую задержку на длинных списках кандидатов. Окно контекста в 131K токенов поддерживает очень длинные документы без чанкинга. Доступна под CC-BY-NC-4.0 на Hugging Face; для коммерческого использования обращайтесь в Jina AI. Для air-gapped или on-premises-развёртываний доступны квантованные веса. Комбинируйте с jina-embeddings-v5-text-small или jina-embeddings-v4 в качестве первичного ретривера.