Реранкер
jina-reranker-v3
 GGUF
 MLX
 Elastic Inference Service
 API Jina AI
 AWS SageMaker
 Microsoft Azure
 Google Облако
 Hugging Face
 Air-gapped
Обзор
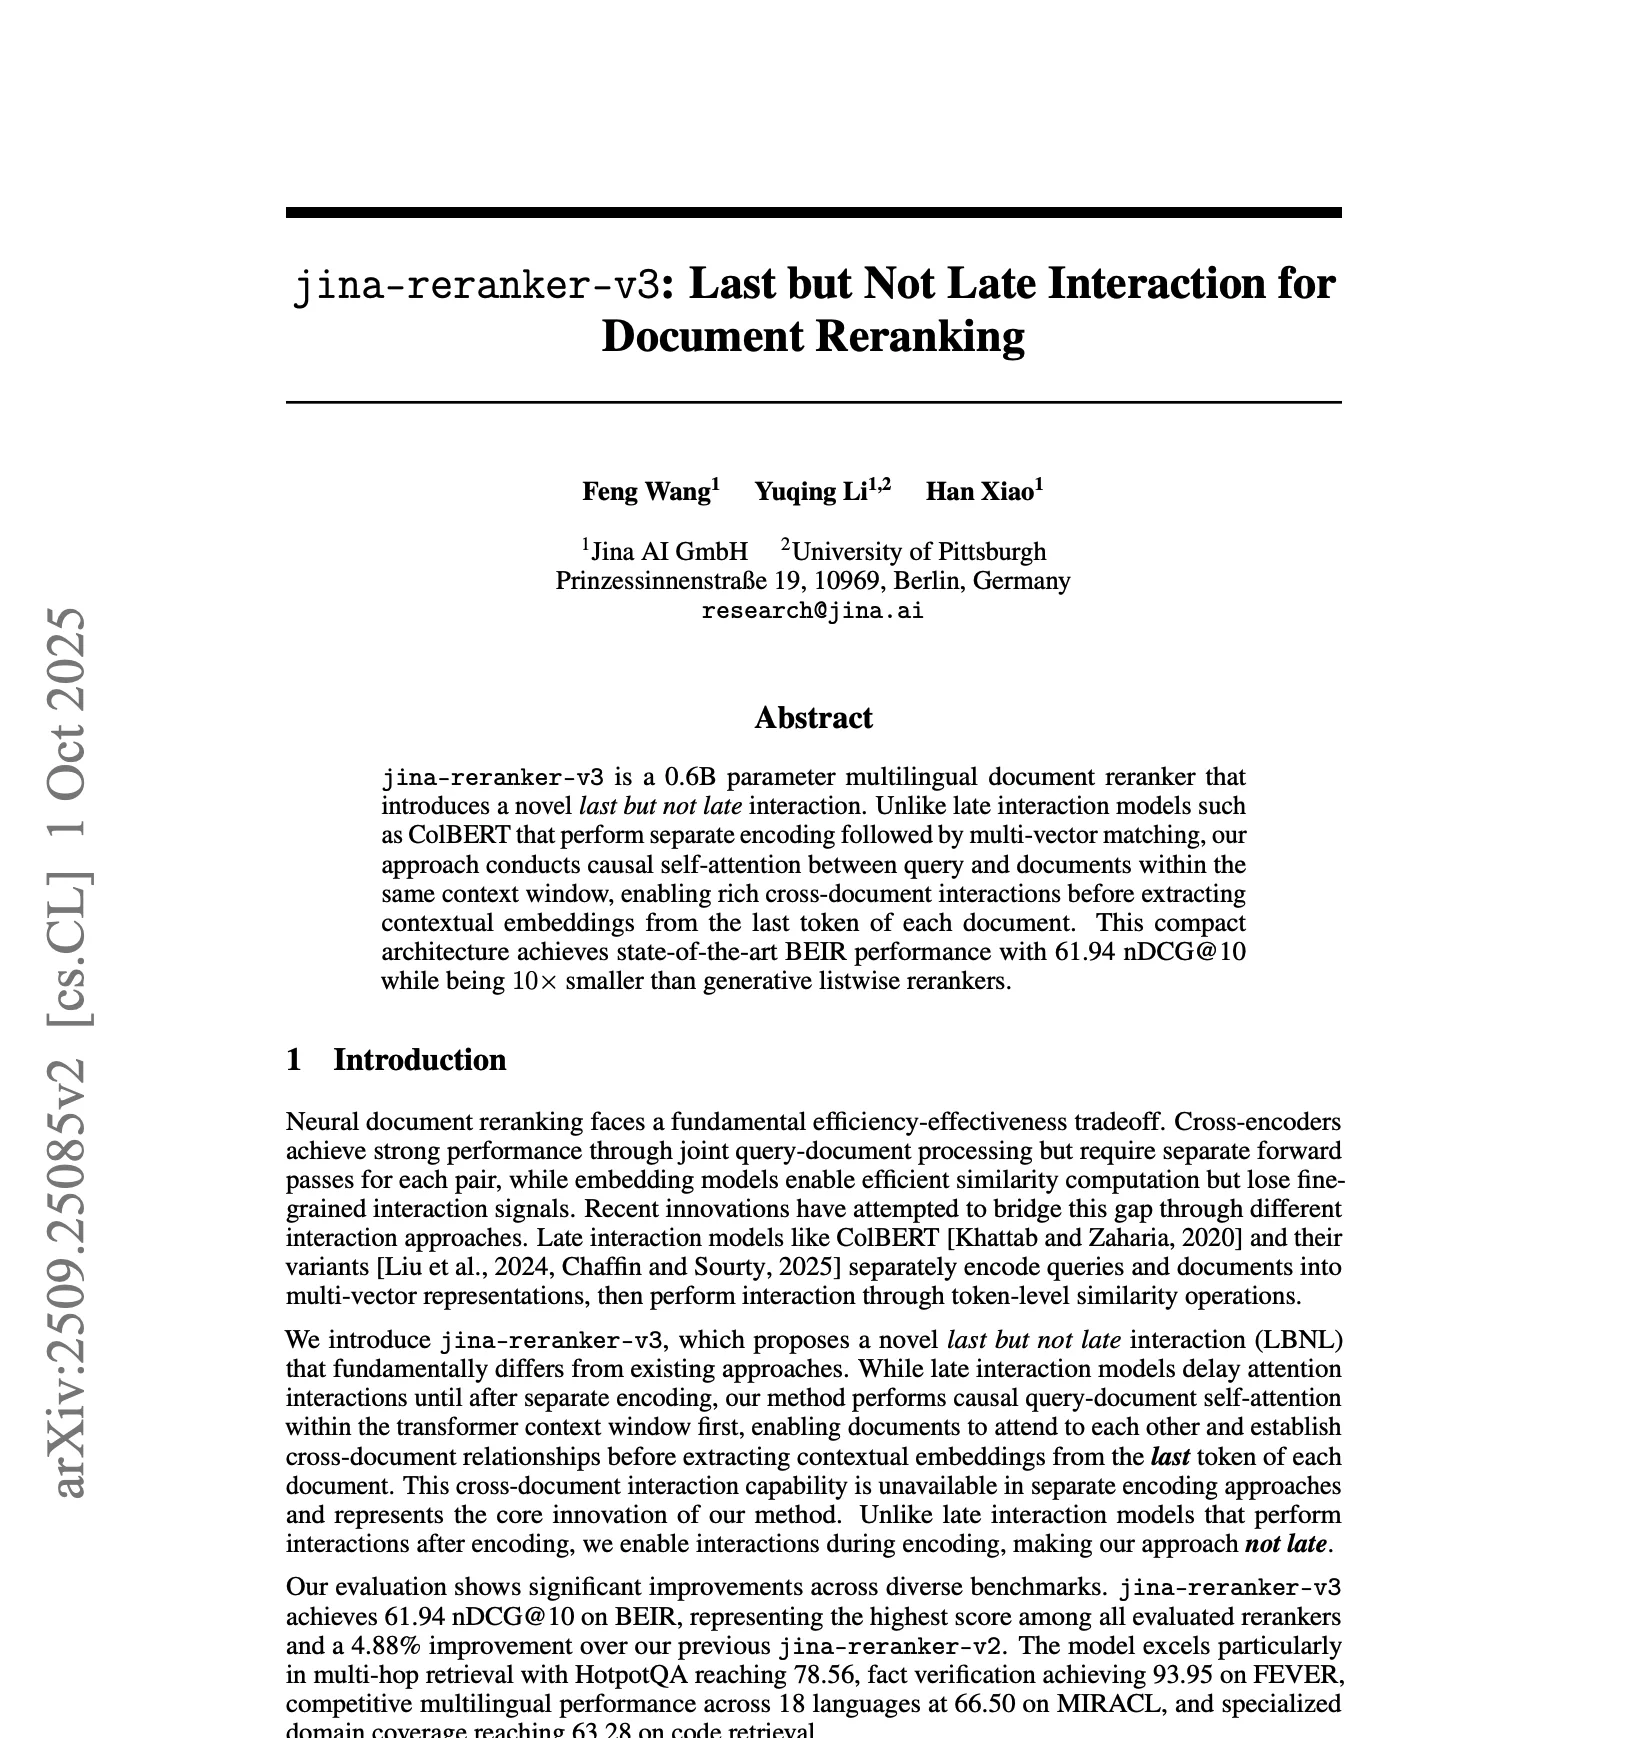
jina-reranker-v3 — мультиязычный listwise-реранкер на 597M параметров, вводящий взаимодействие 'last but not late' (LBNL) — сдвиг парадигмы от попарного cross-encoder-скоринга. Вместо оценки каждой пары «запрос–документ» в изоляции он обрабатывает целый список кандидатов одновременно в едином окне контекста в 131K токенов, используя каузальное внимание для захвата междокументных связей. Он достигает SOTA-качества на BEIR (61,94 NDCG{'@'}10) с числом параметров в 2,5 раза меньшим, чем у ближайшего конкурента.
Методы
Ключевое нововведение — архитектура LBNL. В стандартном cross-encoder каждая пара «запрос–документ» оценивается независимо. В модели late-interaction (ColBERT) документы кодируются отдельно и сопоставляются по токенам. LBNL объединяет сильные стороны обоих: запрос и все кандидаты разделяют единое каузальное окно внимания, что позволяет модели обращать внимание между документами и захватывать сигналы относительной релевантности, которые попарный скоринг упускает. Модель обрабатывает до 16 документов за прямой проход (один позитив и 15 негативов при обучении), причём каждый документ обрезается до фиксированной длины. Эмбеддинги извлекаются из финального токена каждого документа через Last-Token-Pooling, используя каузальный механизм внимания для естественного агрегирования информации из предшествующего контекста. Окно контекста в 131K токенов обеспечивается вращающимся позиционным кодированием с настроенными базовыми частотами. Обучение использует трёхэтапную прогрессивную программу с многоцелевым loss, комбинирующим InfoNCE, дисперсионный loss (вес 0,45), dual matching loss (вес 0,85) и similarity loss.
Производительность
На BEIR модель достигает 61,94 NDCG{'@'}10 — высшего значения среди всех оценённых реранкеров и +4,88 % по сравнению с jina-reranker-v2. Она сильна в multi-hop поиске (78,56 на HotpotQA) и верификации фактов (93,95 на FEVER). Мультиязычное качество достигает 66,50 на MIRACL на 18 языках, с 78,69 на арабском и 81,06 на тайском. Поиск кода достигает 63,28 на CoIR. Модель превосходит mxbai-rerank-large на 1,5B (61,44) при 2,5× меньшем числе параметров и показывает +5,43 % против bge-reranker-v2-m3 того же масштаба. Качество относительно стабильно при разных порядках документов: случайный (62,54), по убыванию (61,94), по возрастанию (61,52) — что указывает на устойчивый listwise-скоринг, не зависящий от порядка кандидатов.
Руководство
Используйте структурированный шаблон промпта с ролями system/user/assistant и специальными токенами для извлечения эмбеддингов. Обрабатывайте до 64 документов за прямой проход для коллекций, превышающих контекст в 131K. Оптимально с документами, отсортированными случайно или по убыванию релевантности (разница в качестве <1 %). Используйте способность к междокументному взаимодействию для задач сравнительного ранжирования — listwise-дизайн модели захватывает связи между кандидатами, которые попарный скоринг упускает. Для мультиязычных приложений модель обеспечивает сильный zero-shot-перенос на 18 языков. Реализуйте батч-обработку для больших наборов документов, поддерживая эмбеддинги запроса неизменными между батчами. Выходные эмбеддинги в 256 измерений поддерживают эффективное вычисление близости. Идеальна для задач multi-hop-рассуждений и верификации фактов. Для продакшена используйте jina-reranker-v3.5 для 1,22–1,56× более быстрого вывода благодаря гибридному вниманию.