Новости

Ускорьте поиск ИИ, по одному токену за раз.

RSS
Избранное
Академические публикации
arXiv
сентябрь 02, 2026
jina-ocr-v1: Efficient Document Parsing with Speculative Decoding and Dense Verifiable Rewards
arXiv
июль 20, 2026
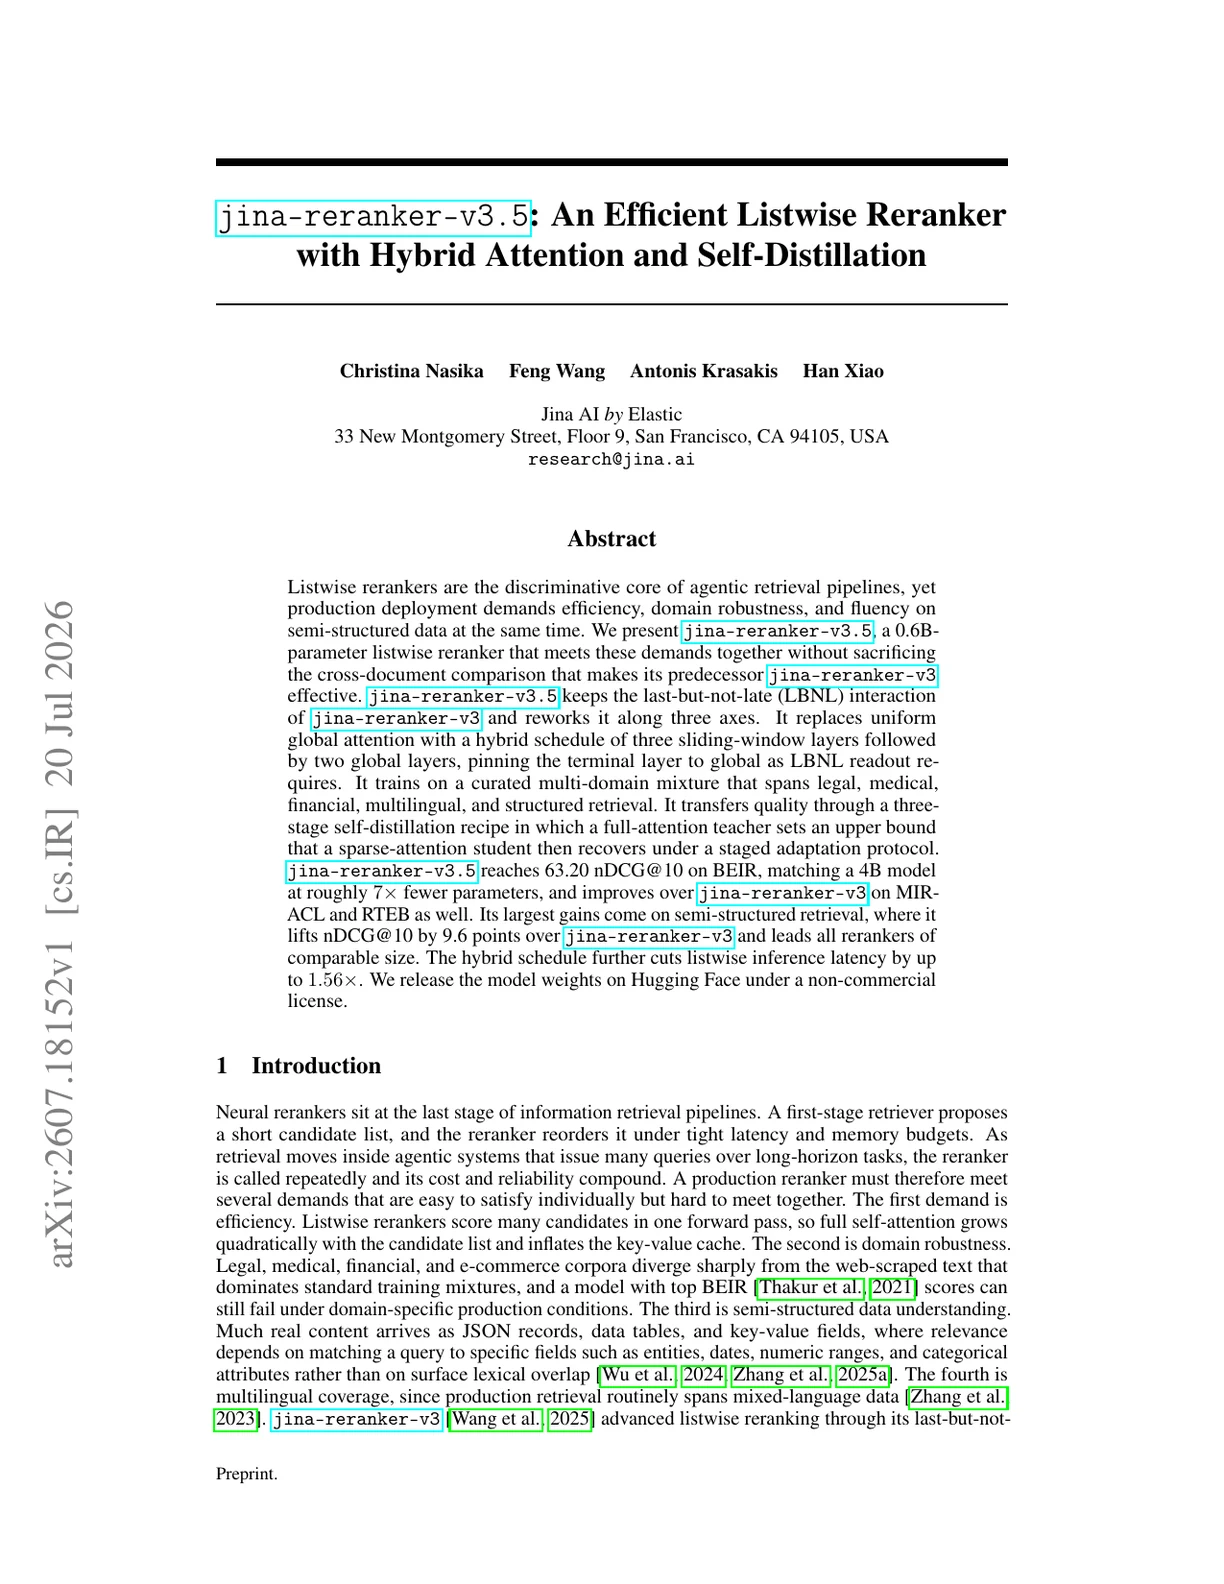
jina-reranker-v3.5: An Efficient Listwise Reranker with Hybrid Attention and Self-Distillation
SIGIR 2026
май 11, 2026
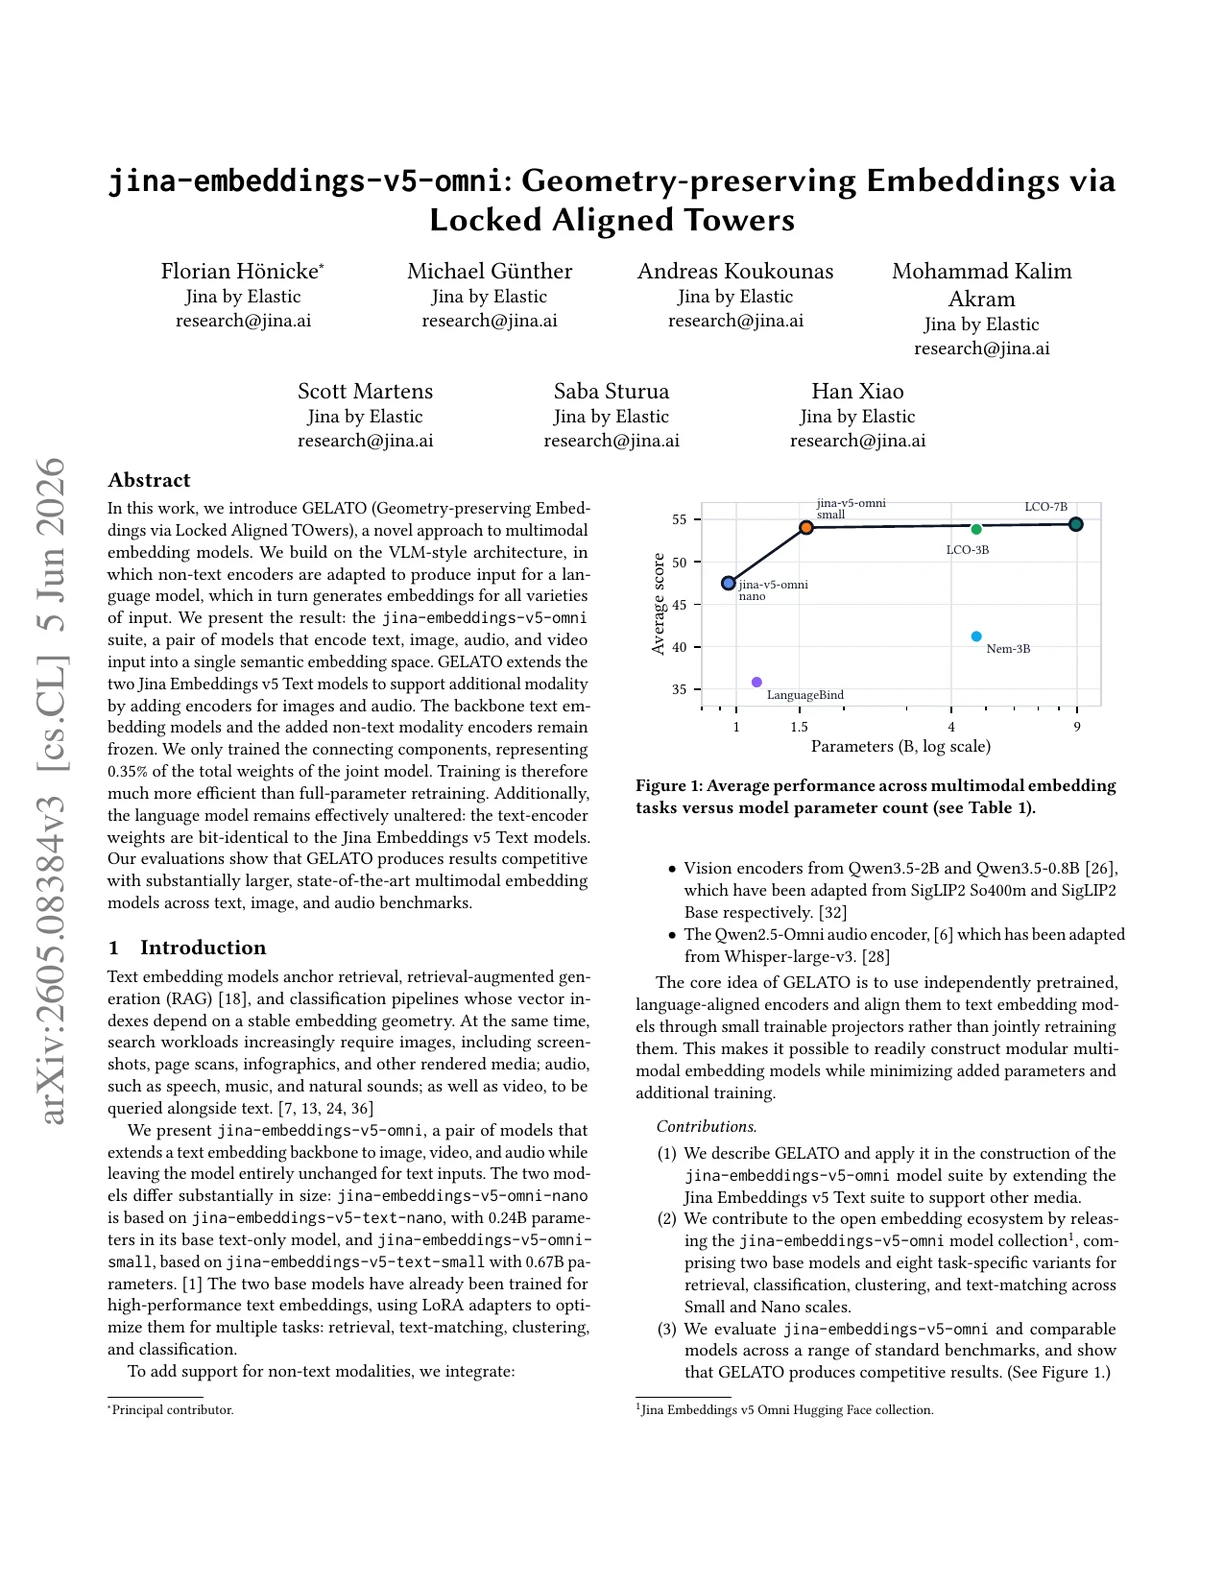
jina-embeddings-v5-omni: Geometry-preserving Embeddings via Locked Aligned Towers
SIGIR 2026
февраль 17, 2026
jina-embeddings-v5-text: Task-Targeted Embedding Distillation
ICLR 2026
январь 22, 2026
Embedding Compression via Spherical Coordinates
arXiv
декабрь 29, 2025
Vision Encoders in Vision-Language Models: A Survey
ICLR 2026
декабрь 04, 2025
Jina-VLM: Small Multilingual Vision Language Model
AAAI 2026
октябрь 01, 2025
jina-reranker-v3: Last but Not Late Interaction for Document Reranking
NeurIPS 2025
август 31, 2025
Efficient Code Embeddings from Code Generation Models
EMNLP 2025
июнь 24, 2025
jina-embeddings-v4: Universal Embeddings for Multimodal Multilingual Retrieval
ICLR 2025
март 04, 2025
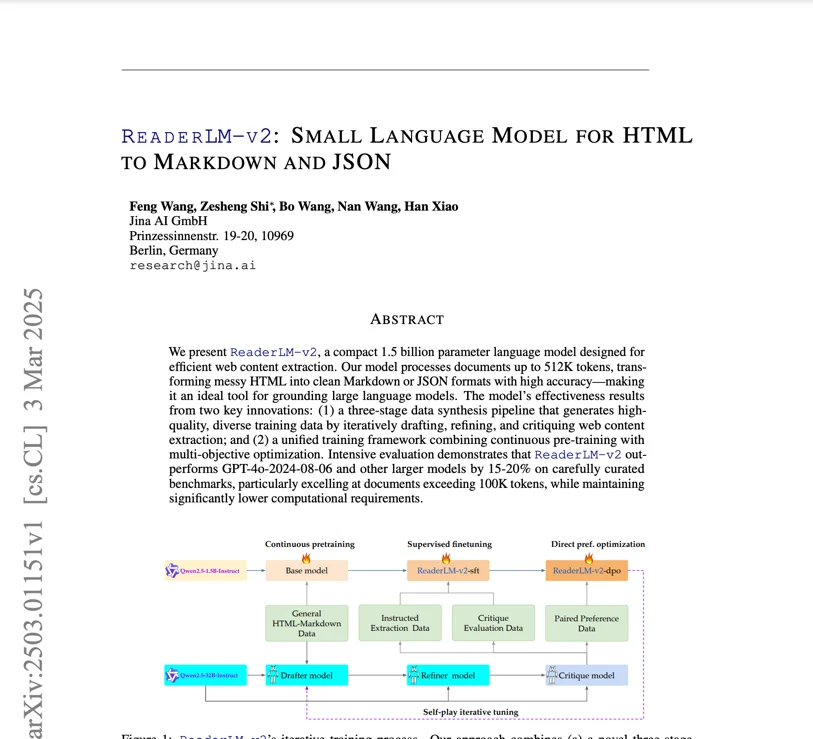
ReaderLM-v2: Small Language Model for HTML to Markdown and JSON
ACL 2025
декабрь 17, 2024
AIR-Bench: Automated Heterogeneous Information Retrieval Benchmark
ICLR 2025
декабрь 12, 2024
jina-clip-v2: Multilingual Multimodal Embeddings for Text and Images
ECIR 2025
сентябрь 18, 2024
jina-embeddings-v3: Multilingual Embeddings With Task LoRA
SIGIR 2025
сентябрь 07, 2024
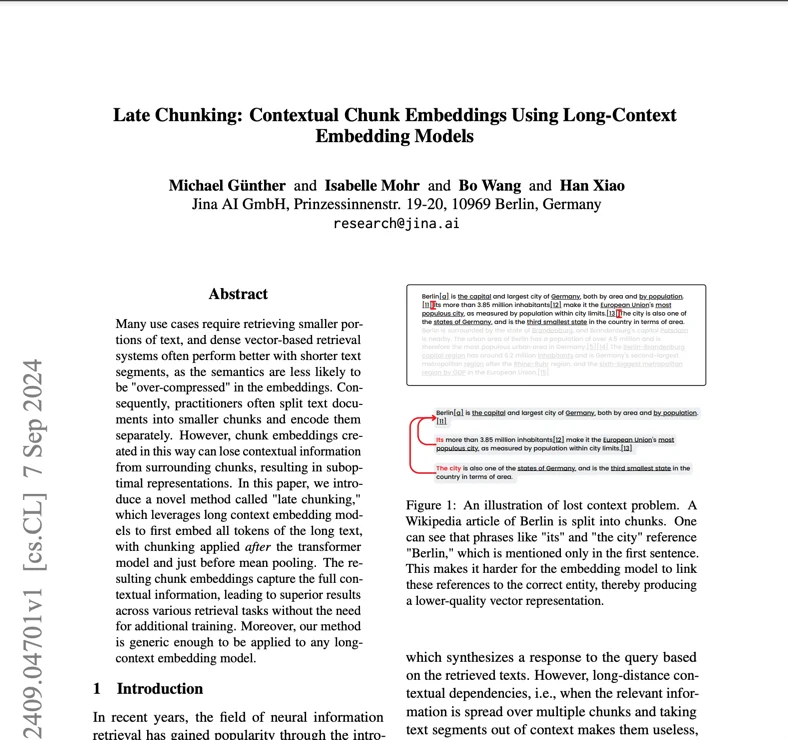
Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models
EMNLP 2024
август 30, 2024
Jina-ColBERT-v2: A General-Purpose Multilingual Late Interaction Retriever
WWW 2025
июнь 21, 2024
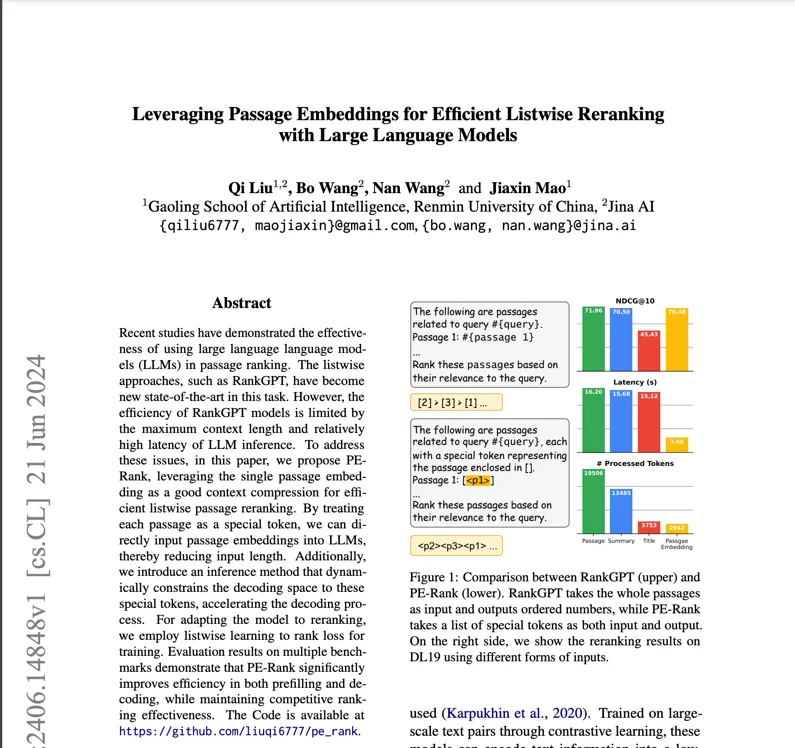
Leveraging Passage Embeddings for Efficient Listwise Reranking with Large Language Models
ICML 2024
май 30, 2024
Jina CLIP: Your CLIP Model Is Also Your Text Retriever
arXiv
февраль 26, 2024
Multi-Task Contrastive Learning for 8192-Token Bilingual Text Embeddings
arXiv
октябрь 30, 2023
Jina Embeddings 2: 8192-Token General-Purpose Text Embeddings for Long Documents
EMNLP 2023
июль 20, 2023
Jina Embeddings: A Novel Set of High-Performance Sentence Embedding Models
Всего публикаций 21.

сентябрь 14, 2026 • 9 минуты чтения
jina-ocr-v1: более быстрый разбор документов на недорогих GPU
jina-ocr-v1 — это мультимодальная языковая модель с 3,4 млрд параметров и 570 млн активных параметров, набравшая 91,1 балла в OmniDocBench v1.6 и 83,4 балла в olmOCR-Bench.
август 03, 2026 • 11 минуты чтения
jina-reranker-v3.5: Более быстрая попарная переранжировка (listwise reranking) с использованием гибридного внимания (hybrid attention) и самодистилляции
Listwise-переранкер (重排器) размером 0,6 млрд параметров, который превосходит Qwen3-Reranker-4B в бенчмарке BEIR, работает до 1,56 раза быстрее, чем v3, и обеспечивает прирост 9,6 nDCG@10 в задачах полуструктурированного поиска.
май 12, 2026 • 7 минуты чтения
jina-embeddings-v5-omni: Векторные модели для текста, изображений, аудио и видео
Одна модель, четыре модальности: текст, изображение, аудио, видео. Лучшие в своем классе омни-векторные модели (Embeddings) с 1,6 млрд и 0,9 млрд параметров.
март 11, 2026 • 7 минуты чтения
Бутстрэппинг аудиоэмбеддингов на базе мультимодальных LLM
Превратите любую мультимодальную LLM в малую векторную модель аудио, которая превосходит CLAP, используя в 25 раз меньше данных.
март 06, 2026 • 6 минуты чтения
Идентификация векторных моделей по сырым числовым значениям
Крошечный трансформер, который создает цифровые отпечатки векторных моделей, считывая необработанные цифры. Без проектирования признаков.
февраль 19, 2026 • 7 минуты чтения
jina-embeddings-v5-text: новые SOTA компактные мультиязычные векторные модели
Две многоязычные модели Embeddings объемом менее 1 млрд параметров с лучшей в своем классе производительностью, доступные в Elastic Inference Service, Llama.cpp и MLX.
декабрь 04, 2025 • 7 минуты чтения
Jina-VLM: Маленькая многоязычная модель Vision Language Model
Новая модель vision language на 2B достигла SOTA в многоязычном VQA, без катастрофического забывания в задачах, связанных только с текстом.
октябрь 03, 2025 • 7 минуты чтения
Jina Reranker v3: 0.6B Listwise Reranker для SOTA Мультиязычного Поиска
Новый списочный реранкер с 0.6B параметрами, который рассматривает запрос и все документы-кандидаты в едином контекстном окне.
сентябрь 09, 2025 • 11 минуты чтения
Мультимодальные 向量模型 в Llama.cpp и GGUF
Мы добавили мультимодальные向量模型 в llama.cpp и GGUF и попутно обнаружили несколько неожиданных проблем.
сентябрь 04, 2025 • 6 минуты чтения

Jina Code Embeddings: SOTA для извлечения кода при 0.5B и 1.5B
Генеративные LLM для кода → векторные модели кода: модели размером 0.5B/1.5B достигают SOTA производительности в 25 бенчмарках извлечения кода.