Reader
LM-v2
 Jina API
 AWS SageMaker
 微软云
 谷歌云
 Hugging Face
 物理隔离
概述
ReaderLM-v2 是一个 1.54B 参数的小型语言模型,能以高准确率将杂乱的 HTML 转换为干净的 Markdown 或 JSON,可处理长达 512K token 的文档。它是为大语言模型提供接地(grounding)的理想工具:将网页内容转换为 LLM 可高效消费的格式。该模型在 HTML 转 Markdown 任务上表现优于 Qwen2.5-32B-Instruct 和 Gemini2-flash-expr,而运行成本仅为其一小部分。
方法
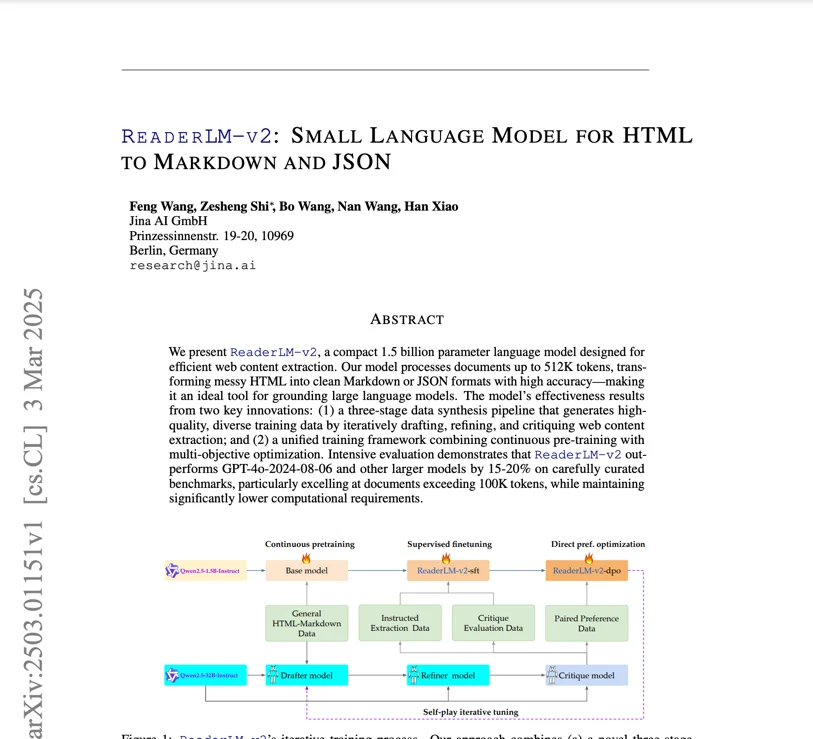
该模型的有效性来自两项关键创新。首先,三阶段数据合成流水线通过迭代地起草、精炼和批评网页内容抽取来生成高质量、多样化的训练数据——这种合成数据方法确保模型无需人工标注即可见到各种 HTML 结构。其次,统一训练框架将连续预训练与多目标优化相结合,使模型能够同时学习 HTML 转 Markdown 和 HTML 转 JSON 转换。'浅而宽'(shallow-but-wide)的解码器专属架构(28 层、1536 隐藏维度、12 个查询头、2 个 KV 头)针对选择性复制操作进行了优化。512K token 上下文通过 zigzag-ring-attention 实现。对比损失训练显著减少了退化问题。
性能
在 HTML 转 Markdown 任务上,该模型取得 ROUGE-L 0.84、Jaro-Winkler 0.82、Levenshtein 距离 0.22,超过 Qwen2.5-32B-Instruct 和 Gemini2-flash-expr。在 HTML 转 JSON 任务上,它以 F1 分数 0.81、98% 通过率保持有竞争力的表现。在 T4 GPU 上,该模型以输入 67 tokens/s、输出 36 tokens/s 的速度处理。退化问题(token 循环、重复输出)通过对比损失训练显著减少。512K token 上下文窗口消除了大多数实际文档的分块需求。
最佳实践
该模型可通过 Google Colab 笔记本访问,其中演示了 HTML 转 Markdown、JSON 提取和指令遵循。对于 HTML 转 Markdown 任务,直接输入原始 HTML,无需前缀指令。对于 JSON 提取,在提示中指定目标模式。create_prompt 辅助函数便于为两种任务创建提示。该模型可在 Colab 免费 T4 GPU 层级运行(需要 vllm 和 triton),但不支持 bfloat16 或 Flash Attention 2 时存在限制;生产环境建议使用 RTX 3090/4090。可通过 AWS SageMaker、Azure 和 GCP 市场获取。以 CC BY-NC 4.0 许可用于非商业用途。将此模型作为 RAG 流水线中的预处理步骤,在使用 jina-embeddings-v5-text-small 嵌入之前将网页内容转换为干净的 Markdown。