向量模型
 Apache 2.0 许可证
jina-clip-v1
Apache-2.0 Jina API
 AWS SageMaker
 微软云
 Hugging Face
 物理隔离
概述
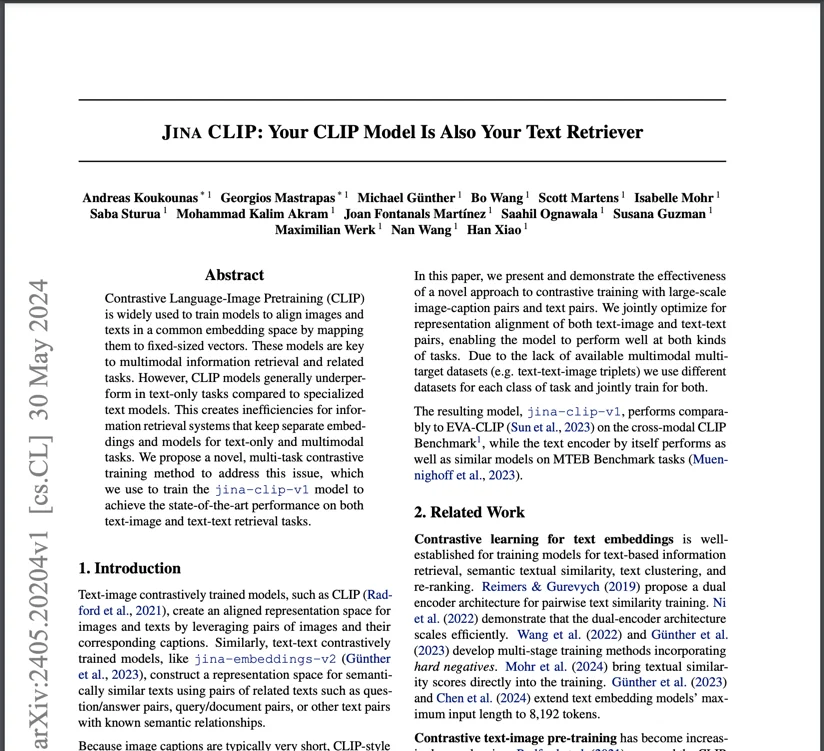
jina-clip-v1 是一个 223M 参数的多模态向量模型,在文本到文本和文本到图像检索任务上均达到最先进的性能——CLIP 家族模型中首次实现。与为跨模态对齐而牺牲纯文本检索的标准 CLIP 模型不同,jina-clip-v1 通过多任务对比训练在所有检索组合中保持强劲表现。它支持 12,288 token 的文本上下文,是原始 CLIP 77 token 限制的 100 倍。
方法
该架构将改造后的 Jina BERT v2 文本编码器(通过 ALiBi 支持 12,288 token)与北京智源人工智能研究院(Beijing Academy for AI)的 EVA-02 图像编码器相结合。关键创新是多任务对比训练方法:模型同时在 (1) 图像-字幕对上进行跨模态对齐、(2) 文本-文本对上保持纯文本检索质量、(3) AI 生成的图像长文本描述上提升对不同文本长度的鲁棒性进行训练。最后阶段使用困难负样本文本三元组来锐化语义区分。这种多任务方法防止了标准 CLIP 训练中常见的纯文本检索灾难性遗忘。图像编码器处理 224×224 像素块,每个块消耗 1,000 token 的处理容量。
性能
在纯文本检索中,该模型相比 OpenAI CLIP 性能提升 165%(MTEB 上 0.429 vs 0.162)。图像任务:文本到图像检索提升 2%(0.899)、图像到文本检索提升 6%(0.803)、图像到图像检索提升 12%(0.916)。在零样本视觉分类(CIFAR-100)上,优于标准 CLIP。在 Flickr8k/30k 和 MSCOCO Captions 上的跨模态性能与专门的单模态模型相当。12,288 token 的文本上下文对于连同图像检索长文档是重大优势。2026 年,jina-clip-v2 以 89 种语言支持和 512×512 图像处理取代该模型。
最佳实践
该模型以 224×224 像素块处理图像;每个块消耗 1,000 token。一张 750×500 像素的图像需要 12 个块(12,000 token)。文本约每词 1.1 token。请为混合模态查询相应规划 token 预算。该模型目前仅支持英语——多语言应用请使用 jina-clip-v2。可通过 Jina Embeddings API 使用,也可作为 Hugging Face 上 Apache 2.0 许可的开源版本。生产环境中,AWS Marketplace 和 Azure 部署选项提供优化的基础设施。跨模态比较请使用余弦相似度。新的多模态项目请优先选择 jina-clip-v2(89 种语言、512×512 图像、支持 MRL)或 jina-embeddings-v4(32K 上下文、多向量模式、支持代码)。