

 向量模型
jina-code-embeddings-1.5b
 GGUF
 Jina API
 AWS SageMaker
 微软云
 谷歌云
 Hugging Face
 物理隔离
概述
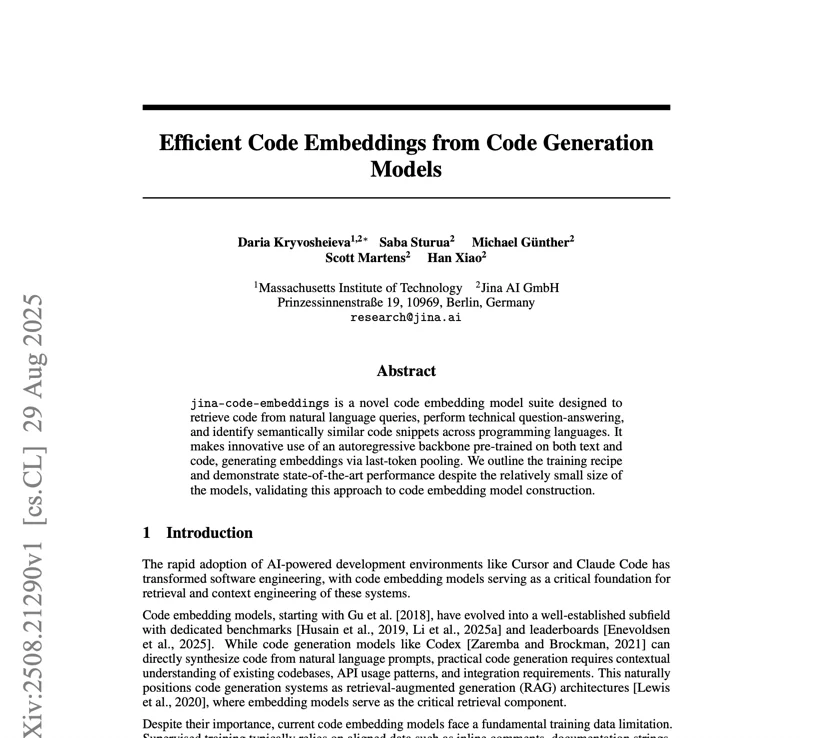
jina-code-embeddings-1.5b 是一个 1.5B 参数的代码向量模型,将编程代码和自然语言查询映射到共享的 1536 维语义空间。它支持 32K token 上下文窗口,可实现整个文件和多文件代码上下文的检索。它达到最先进的代码检索性能,显著超过其 0.5B 兄弟模型以及大得多的专用代码检索模型。
方法
该模型构建在自然语言和代码语料上预训练的自回归 Transformer 骨干之上,利用代码生成预训练目标产生丰富的语义表示。它通过 Last-Token-Pooling 从序列的最终位置提取向量——自回归模型的因果注意力自然地关注完整输入上下文,代码生成目标产生既捕捉句法结构又捕捉功能语义的表示。训练采用两阶段方案:(1) 在大规模代码-文本对上进行对比预训练,(2) 在精选的代码检索数据集上以困难负样本挖掘进行监督微调。32K 上下文长度通过调整基础频率的旋转位置编码实现。Matryoshka 表示学习支持将维度从 1536 截断到 128。
性能
该模型取得 79.04% 的总平均和 78.94% 的 MTEB Code 平均,为其参数级别树立了新基准。值得注意的分数:HumanEval 98.41%、MBPP 90.13%、WikiSQL 98.02%、CodeChefXLang 99.44%、CodeTransOceanContest(代码到代码)92.54%、COIR-CodeSearchNet(NL2Code)86.45%、Doc2Code 96.34%、StackOverflowQA 92.37%、SWE-Bench 86.33%(0.5B 变体为 83.00%)。它超过更大的替代方案,并在复杂的多文件和跨仓库任务上较 0.5B 变体有一致提升。
最佳实践
根据检索需求策略性地使用指令前缀:nl2code、code2code、code2nl、techqa、code2completion。在整个流水线中保持一致——在特定检索场景中,查询和文档使用相同类型的前缀。增强的 1.5B 容量非常适合涉及多种编程范式和大型代码库的复杂场景。通过用例分析确定平衡质量与资源的最优 Matryoshka 维度;256–512 维是索引的良好起点,重排序使用 1536 维。生产环境为与训练对齐请使用批量大小 256。凭借 99.44% 的 CodeChefXLang 性能,该模型非常适合跨仓库和跨语言搜索。将其作为 RAG 系统中的主要检索组件实施,并搭配 jina-reranker-v3.5 以提高前 50 候选的精度。使用余弦相似度比较向量。对于要求性能与效率兼备且延迟低于一秒的企业部署最为理想。

