

 向量模型
 重排模型
jina-colbert-v2
 Jina API
 AWS SageMaker
 微软云
 谷歌云
 Hugging Face
 物理隔离
概述
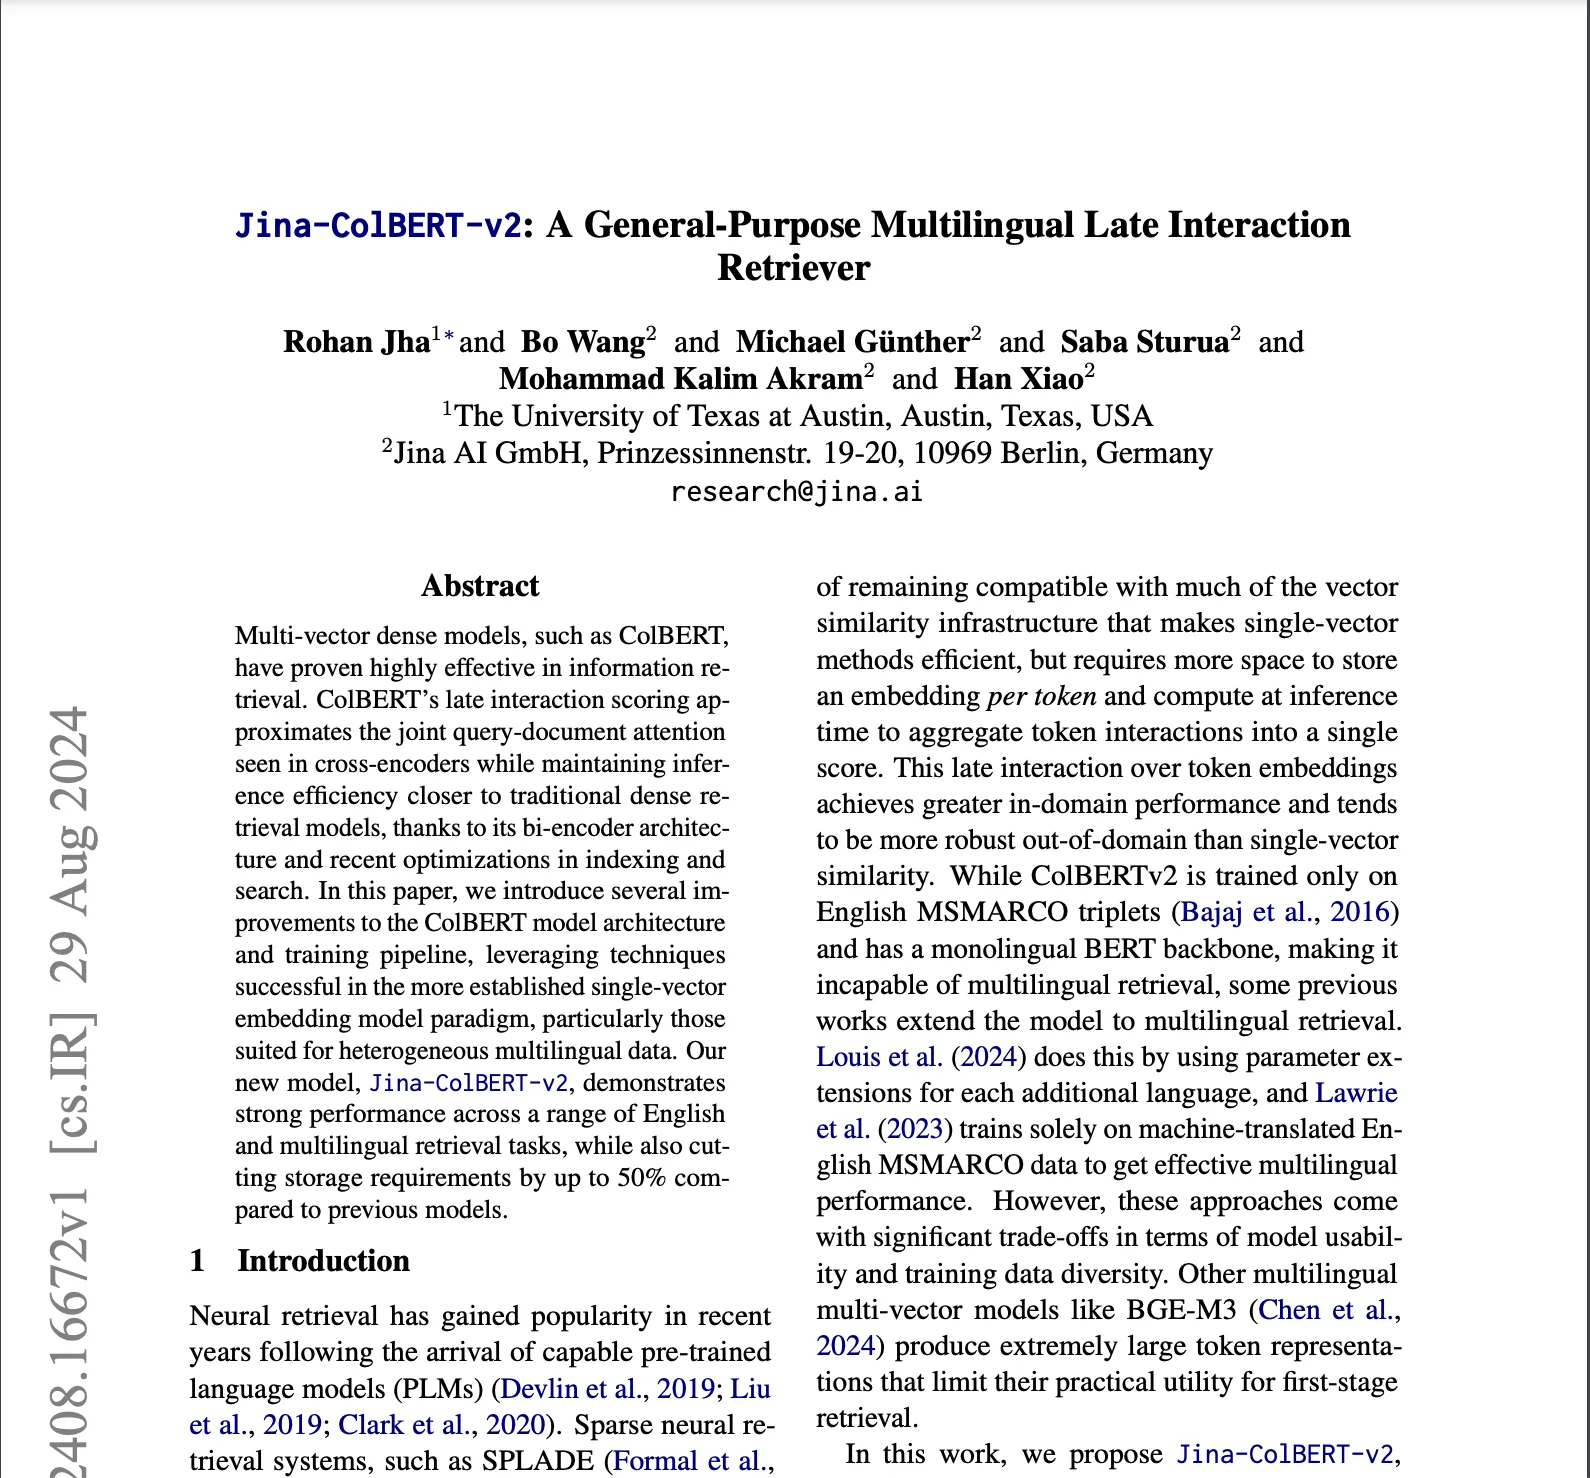
jina-colbert-v2 是一个 560M 参数的多语迟交互检索模型,支持 89 种语言。它是首个生成紧凑 token 级向量(每 token 64–128 维)的多语 ColBERT 类模型,实现可扩展、经济的多语搜索。Matryoshka 表示学习允许将维度从 128 降至 64,性能仅下降 1.5%,存储需求减半。
方法
该模型基于 ColBERT 迟交互架构,采用改进的 XLM-RoBERTa 骨干(560M 参数),增强旋转位置编码并以 Flash Attention 优化。训练涉及两个关键阶段:(1) 在来自各种语言的多样弱监督数据上进行初始预训练,(2) 使用标注三元组数据并借助更大教师模型的监督蒸馏进行微调。关键创新是为多向量表示实现 Matryoshka 表示学习:模型从单一训练过程产生 128、96 或 64 维的 token 级向量,无需重新训练即可实现动态存储优化。8,192 token 的文档上下文(可扩展至 12,288)和 32 token 的查询限制通过 ALiBi 位置编码管理。
性能
该模型在英语任务上较原始 ColBERT-v2 提升 6.5%,在 14 个 BEIR 基准上平均得分 0.521。它在 MIRACL 基准的所有测试语言上超过传统 BM25 检索方法,在跨语言场景中表现尤为突出。从 128 维降到 64 维仅导致 1.5% 的性能下降,同时存储需求减半——例如,在 AWS 上用 64 维向量存储 1 亿个文档每月花费 659.62 美元,而 128 维需 1,319.24 美元。模型的多语覆盖(89 种语言)和紧凑的 token 向量使其非常适合全球搜索应用。
最佳实践
该模型需要支持 CUDA 的硬件以获得最佳性能。它支持最长 8,192 token 的文档(可扩展至 12,288),查询限制为 32 token。生产部署可通过 Jina Search Foundation API、AWS 市场和 Azure 获得,Hugging Face 上有非商业版本。实施时请指定是嵌入查询还是文档——该模型使用非对称编码。该模型不适合在没有适当索引的情况下实时处理超大规模文档集合;请使用 FAISS、Qdrant 或 Weaviate 进行 ANN 搜索。对于领域特定任务,请在您的语料上微调。对于需要更高维度输出的单向量检索,请考虑 jina-embeddings-v4(多向量模式)或 jina-embeddings-v5-text-small。




