向量模型
 Qwen 研究许可证
jina-embeddings-v4
Qwen Research License GGUF
 Jina API
 Hugging Face
 物理隔离
概述
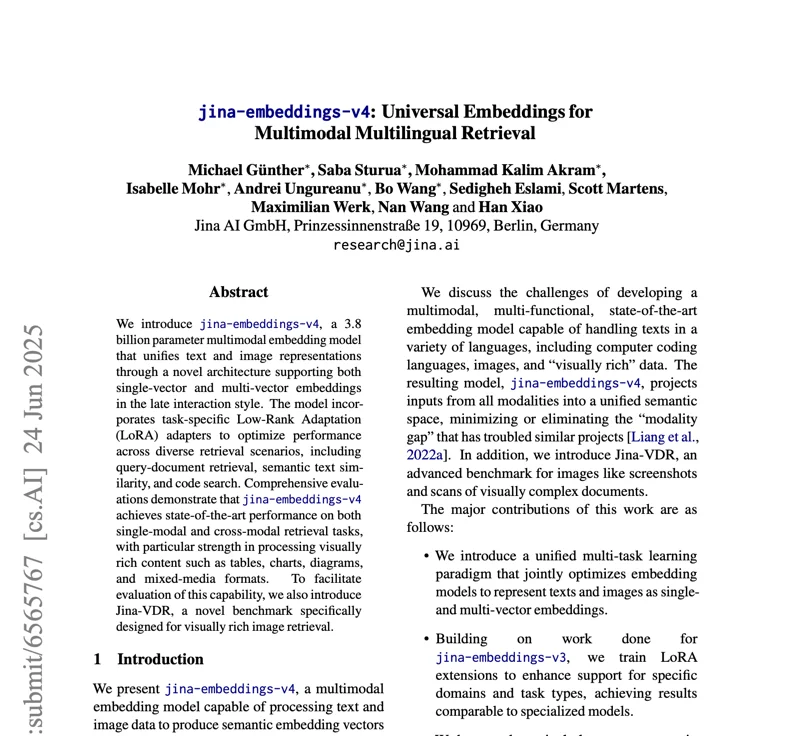
jina-embeddings-v4 是一个 3.8B 参数的多模态向量模型,将文本和图像表示统一在单一架构中。它独特地支持单向量(dense)和多向量(late-interaction/ColBERT 风格)两种输出模式,使团队无需切换模型即可在索引效率和检索精度之间权衡。该模型在视觉丰富的文档检索上取得 SOTA 性能,原生处理表格、图表、示意图和混合媒体格式。
方法
该架构将大型 transformer 编码器主干与基于 Qwen2.5-VL 的视觉编码器相结合,通过共享注意力层处理文本(最多 32K token)和图像(768×28×28 补丁)。三个任务特定的 LoRA 适配器(各 60M 参数)使模型专门用于:非对称查询-文档检索、语义文本相似性和代码搜索。双输出设计是关键创新:模型可以生成单个 2048 维 dense 向量(用于快速 ANN 索引,可经 Matryoshka 截断到 128 维),或一组 128 维 token 级向量用于 late-interaction 打分。训练采用两阶段课程:在文本-图像和文本-文本对上联合对比预训练,然后是任务特定的 LoRA 适配器训练。对超出 32K token 上下文窗口的文档支持 late chunking。适用 Qwen Research License。
性能
在 JinaVDR(视觉文档检索)上,该模型平均得分 72.19,而 ColPali-v1.2 为 64.50。在 ViDoRe 上,它取得平均 84.11(多向量模式下 90.17),而 ColPali 为 83.90。跨模态检索在 CLIP 基准上达到 84.11,超过 jina-clip-v2(81.12)和 nllb-clip-large-siglip(83.19)。文本检索得分:MTEB-en 55.97、MMTEB 66.49、LongEmbed 67.11(jina-embeddings-v3 为 55.66)。语义相似度在 English STS 上达到 85.89,多语言 STS 上 72.70。代码检索在 CoIR 上得分 71.59。跨模态对齐达到 0.71 余弦相似度(OpenAI CLIP 为 0.15)。多向量模式在视觉丰富任务上一致优于单向量模式;单向量模式为标准文本检索提供高效性能。
最佳实践
根据流水线选择输出模式:大规模 ANN 索引用单向量(可用 Matryoshka 截断到 128–512 维),视觉丰富文档的 top-k 候选重排序用多向量。通过 API 任务参数选择 LoRA 适配器:查询-文档搜索用 'retrieval',语义相似性用 'text-matching',代码检索用 'code'。对超过 32K token 的文档,使用 `late_chunking。每个 LoRA 适配器的 60M 参数开销可忽略(内存增加 <2%),且三个适配器可同时加载。该模型在 Qwen Research License 下授权(无商用许可证不得商用)。生产部署请使用支持 CUDA 的 GPU;该模型可通过 Jina API、AWS、Azure 和 GCP 市场获取。纯文本工作负载可考虑 jina-embeddings-v5-text-small`,它以一小部分计算成本提供更高的每参数精度。