向量模型
jina-embeddings-v5-omni-nano
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Hugging Face
 MacOS
 物理隔离
概述
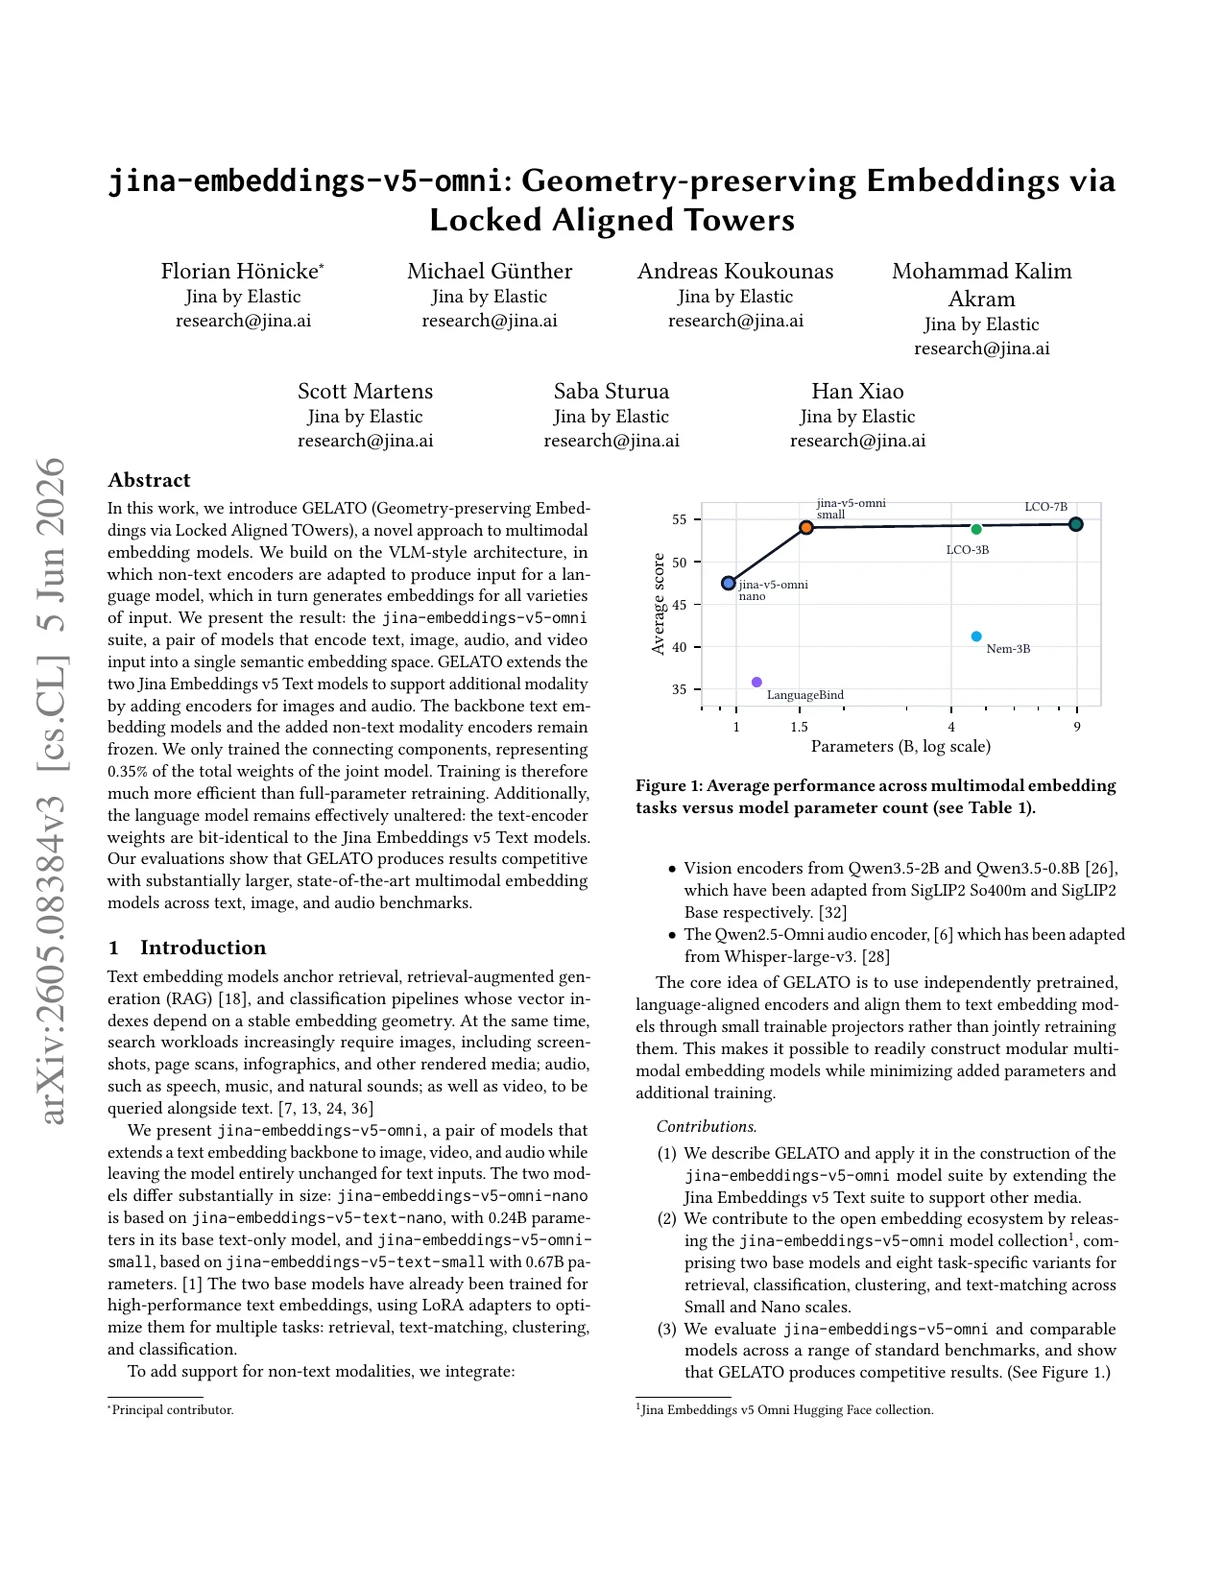
jina-embeddings-v5-omni-nano 是一个约 1.04B 参数的多模态向量模型,可接受文本、图像、视频和音频,在共享向量空间中生成向量。它是 v5-omni 家族的紧凑变体,专为无 GPU 可用的边缘和通用硬件而设计。纯文本输出与 jina-embeddings-v5-text-nano 按位相同,使其成为从纯文本到多模态的即插即用升级,无需重建索引。
方法
该模型通过第三阶段训练从 jina-embeddings-v5-text-nano 扩展出多模态能力。EuroBERT-210M 文本骨干和全部四个任务特定 LoRA 适配器均被冻结,只有跨模态投影器是新训练的。SigLIP2 Base 视觉编码器处理图像和视频(每视频均匀采样 32 帧)。Whisper-large-v3 音频编码器处理音频输入。PDF 页面渲染为图像,经视觉通路处理。训练使用带跨模态困难负样本的对比损失,将视觉和音频表示与现有文本向量空间对齐。768 维输出空间支持 Matryoshka 截断至 32 维。8K token 上下文窗口覆盖文本输入,图像和音频输入经各自编码器处理。
性能
纯文本性能与 jina-embeddings-v5-text-nano(MMTEB 任务级平均 65.5,英文 MTEB 71.0)按位相同。多模态性能因 768 维向量空间(对比 1024)更窄和文本骨干更小,略低于 jina-embeddings-v5-omni-small,但在文本-图像、文本-音频和文本-视频检索上保持强跨模态对齐。该模型针对 CPU 和边缘硬件优化,在这些环境中更大的 omni-small 模型无法高效运行。跨模态检索质量在其尺寸级别中具有竞争力。
最佳实践
与 jina-embeddings-v5-omni-small 相同的使用模式:选择合适的 LoRA 适配器(retrieval、text-matching、clustering、classification),并直接经 API 传递图像 URL、音频文件 URL、视频文件 URL 或 PDF URL——模型将每种模态路由到相应编码器。支持的音频格式:WAV、MP3、FLAC、OGG、M4A、Opus。视频输入按 32 帧均匀采样处理。可以在单个批次内自由混合模态;向量空间在所有模态间共享。使用余弦相似度进行比较。支持从 768 到 32 维的 Matryoshka 截断。纯文本向量与 jina-embeddings-v5-text-nano 即插即用兼容——升级时无需重建索引。对于需要更高精度的服务器部署,请使用 jina-embeddings-v5-omni-small(1024 维,更大的骨干)。