重排模型
jina-reranker-v3.5
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 微软云
 谷歌云
 Hugging Face
 物理隔离
概述
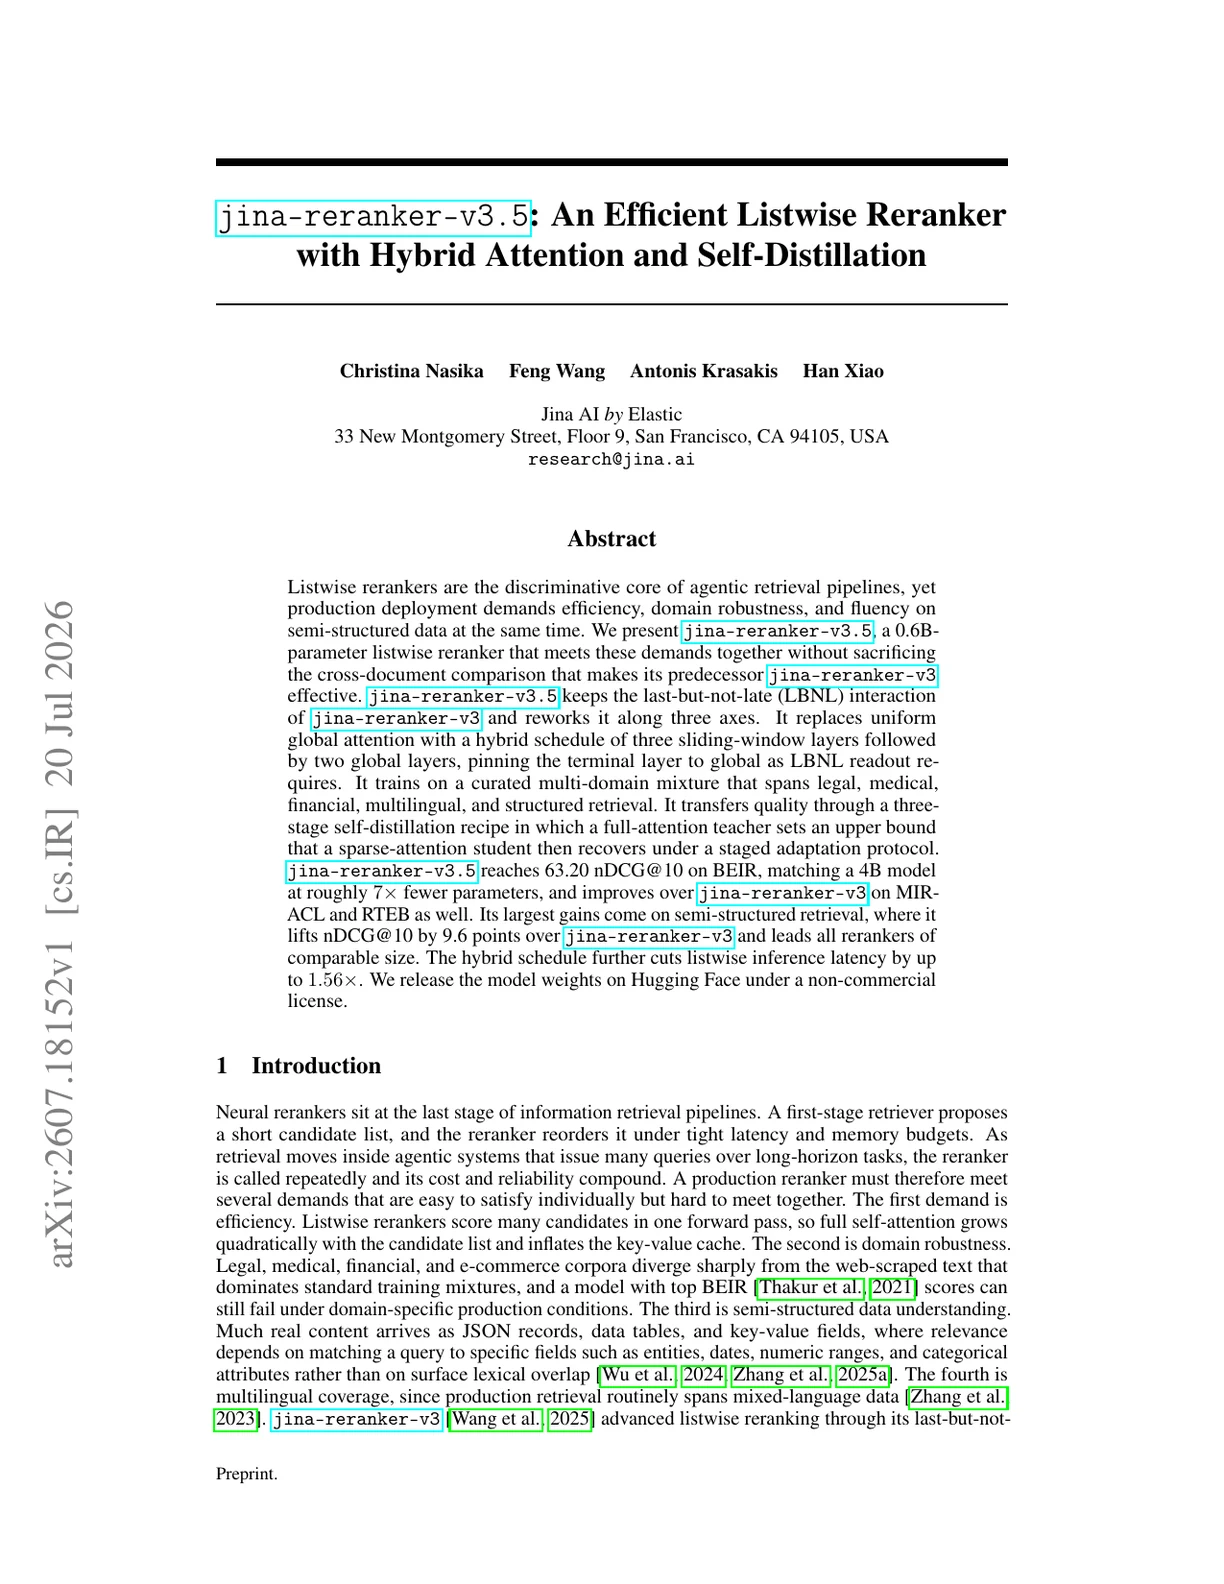
jina-reranker-v3.5 是一个 0.6B 参数的 listwise 重排序模型,参数量仅为 4B 参数模型的约 1/7,性能却与之相当。它引入混合注意力计划(三个滑窗层 + 两个全局层)配合三阶段自蒸馏配方,将质量从全注意力教师模型转移到稀疏注意力学生模型。它是 jina-reranker-v3 的即插即用替代,保持相同的 API 模式,同时提升效率和领域覆盖。
方法
架构保留了 jina-reranker-v3 的 LBNL listwise 设计:查询和所有候选文档共享单个上下文窗口,向量从每个文档的最后一个 token 读取。核心创新是混合注意力计划。模型不使用每层均匀的全局注意力,而是用三个滑窗注意力层(将每个位置的注意力限制在局部窗口)后接两个全局注意力层。由于 LBNL 读出机制要求最后一个 token 关注完整上下文,最后一层固定为全局注意力。训练分三阶段进行:(1) 全注意力教师模型在涵盖法律、医疗、金融、多语言和结构化检索的精选多领域混合上训练;(2) 稀疏注意力学生模型从教师初始化,通过分阶段适应微调,逐步增加使用混合计划的训练步比例;(3) 最终蒸馏遍,学生学习匹配教师的软排名分布,在运行更廉价的稀疏注意力推理路径的同时恢复教师 97% 以上的排名质量。
性能
在以 jina-embeddings-v5-text-small 作为一级检索器的统一 top-100 协议下,该模型在 BEIR 上得分 63.20 NDCG{'@'}10、MIRACL 74.11、RTEB 70.95、Struct-IR 48.3,在各项指标上均超过 jina-reranker-v3(62.10 / 72.20 / 68.01 / 38.7)。其 BEIR 分数以约为 4B Qwen3-Reranker 的 1/7 的参数量,略胜后者(62.28)。相对 v3 的提升包括 BEIR +1.10、MIRACL +2.6%、RTEB +4.3%(法律检索大幅提升)以及结构化数据排序(Struct-IR)+24.8%。listwise 推理从短上下文到长上下文比 v3 快 1.22–1.56 倍(A100,FlashAttention-2)。多领域训练混合在半结构化数据(表格、JSON、XML)和领域特定语料上带来尤其显著的提升。
最佳实践
jina-reranker-v3.5 是 jina-reranker-v3 的即插即用替代:请求模式不变,因此切换模型字符串无需代码改动。它在单次调用中对查询与完整候选列表进行排名——将文档通过标准 rerank 端点传递,使用 top_n 限制返回结果,或设置 return_embeddings 同时检索文档向量。该模型在结构化数据排序、法律和其他领域特定检索以及多语言集合上特别强。其混合注意力设计在长候选列表上保持低延迟。131K token 上下文窗口支持无需分块的超长文档。在 Hugging Face 上以 CC-BY-NC-4.0 许可提供;商业用途请联系 Jina AI。面向隔离或本地部署提供量化权重。与 jina-embeddings-v5-text-small 或 jina-embeddings-v4 配合作为一级检索器。