重排模型
jina-reranker-v3
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 微软云
 谷歌云
 Hugging Face
 物理隔离
概述
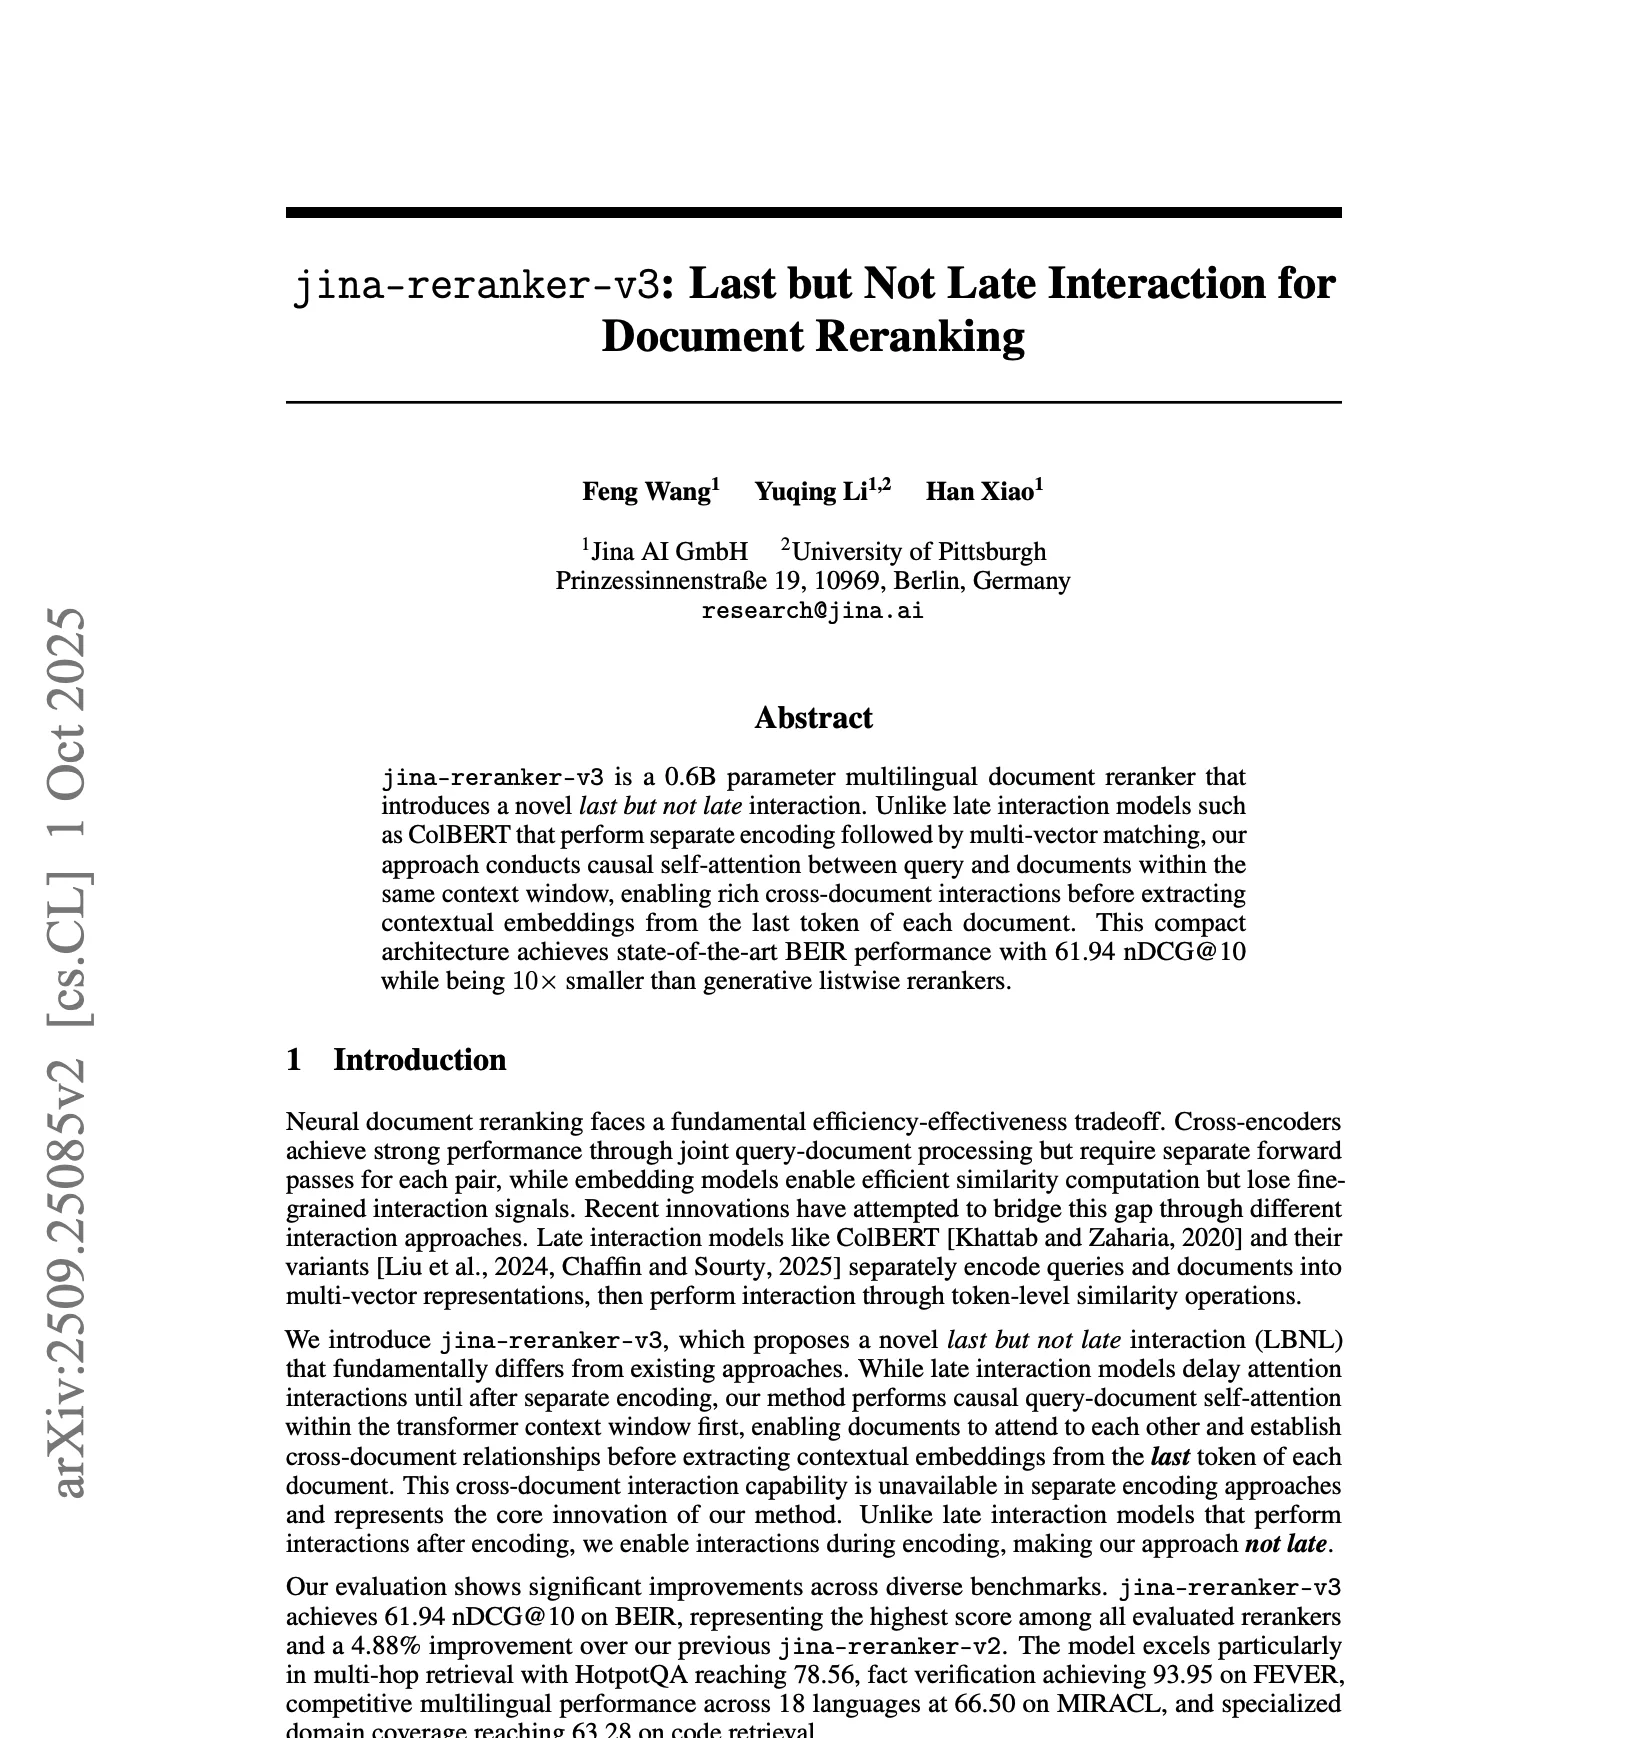
jina-reranker-v3 是一个 597M 参数的多语言 listwise 重排序模型,引入了 'last but not late'(LBNL)交互——这是相对于成对 cross-encoder 打分的一次范式转变。它不是孤立地评估每个查询-文档对,而是在单个 131K token 上下文窗口内同时处理整个候选文档列表,利用因果注意力捕捉文档间关系。它仅用最接近竞品 2.5 分之一的参数量,便实现了 SOTA 的 BEIR 性能(61.94 NDCG{'@'}10)。
方法
核心创新是 LBNL 架构。在标准 cross-encoder 中,每个查询-文档对独立打分。在 late-interaction 模型(ColBERT)中,文档单独编码并按 token 匹配。LBNL 结合了两者的优势:查询和所有候选文档共享单个因果注意力上下文,使模型能跨文档关注并捕捉成对打分遗漏的相对相关性信号。模型每次前向处理最多 16 个文档(训练时 1 个正例、15 个负例),每个文档被截断到固定长度。向量通过 Last-Token-Pooling 从每个文档的最后一个 token 提取,利用因果注意力机制自然地聚合前序上下文的信息。131K token 上下文窗口通过调整基频的旋转位置编码实现。训练使用三阶段渐进课程,结合 InfoNCE、离散损失(权重 0.45)、双匹配损失(权重 0.85)和相似度损失的多目标损失。
性能
在 BEIR 上,该模型达到 61.94 NDCG{'@'}10,是评估的所有重排序器中最高的,较 jina-reranker-v2 提升 4.88%。它在多跳检索(HotpotQA 78.56)和事实验证(FEVER 93.95)上表现卓越。多语言性能在 18 种语言上 MIRACL 达 66.50,其中阿拉伯语 78.69、泰语 81.06。代码检索在 CoIR 上达 63.28。它的参数量仅为 1.5B 的 mxbai-rerank-large 的 2.5 分之一,便超越了后者(61.44),并较同规模的 bge-reranker-v2-m3 提升 5.43%。性能在不同文档顺序下相对稳定:随机(62.54)、降序(61.94)、升序(61.52)——表明稳健的 listwise 打分不受候选顺序影响。
最佳实践
使用带 system/user/assistant 角色和特殊 token 的结构化提示模板进行向量提取。对于超过 131K 上下文的集合,每次前向最多处理 64 个文档。文档随机排序或按相关性降序排序时效果最佳(性能差异 <1%)。利用跨文档交互能力处理比较排序任务——模型的 listwise 设计能捕捉成对打分遗漏的候选间关系。对于多语言应用,模型在 18 种语言上提供强大的零样本迁移。为大型文档集实现批处理,在批次间保持查询向量一致。256 维输出向量支持高效的相似度计算。适合多跳推理和事实验证任务。生产环境请使用 jina-reranker-v3.5,通过混合注意力实现 1.22–1.56 倍更快的推理。