Reader
LM-v2
 Reader API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 實體隔離
概述
ReaderLM-v2 是一個 1.54B 參數的小型語言模型,能以高準確率把雜亂的 HTML 轉換成乾淨的 Markdown 或 JSON,可處理長達 512K 詞元的文件。它是大型語言模型建立事實依據(grounding)的理想工具:把網頁內容轉成 LLM 能高效取用的結構化格式。該模型在 HTML 轉 Markdown 任務上勝過 Qwen2.5-32B-Instruct 與 Gemini2-flash-expr,執行成本卻只是它們的一小部分。
方法
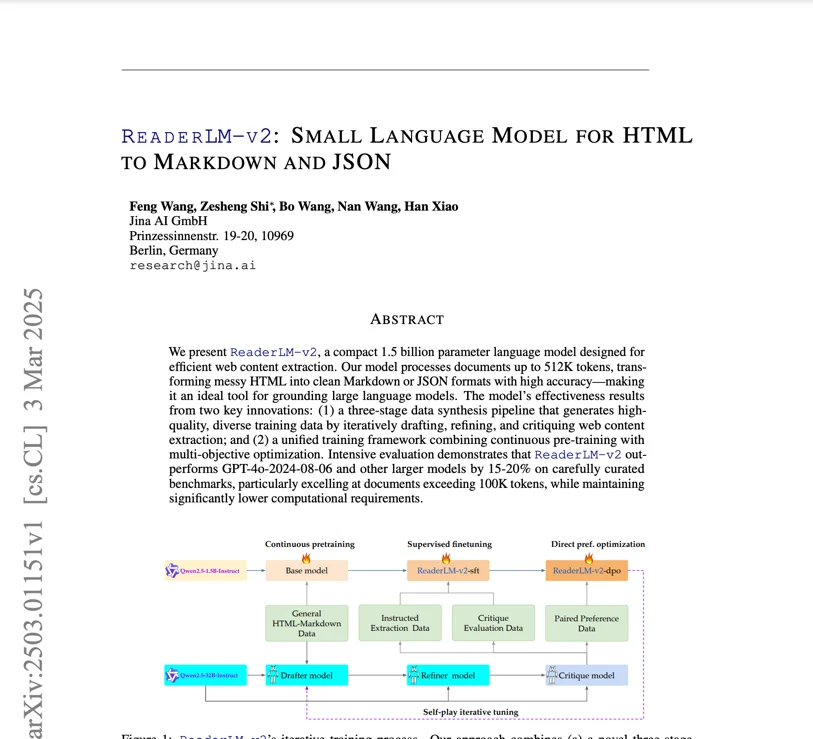
該模型的成效來自兩項關鍵創新。第一,三階段資料合成管線以反覆起草、精煉與評析網頁內容擷取的方式,產生高品質且多樣的訓練資料——這種合成資料做法讓模型不必人工標註,就能見識各種 HTML 結構。第二,統一的訓練框架把連續預訓練與多目標最佳化結合,讓模型同時學會 HTML 轉 Markdown 與 HTML 轉 JSON。「淺而寬」(shallow-but-wide)的僅解碼器架構(28 層、1536 隱藏維度、12 個查詢頭、2 個 KV 頭)針對選擇性複製作業最佳化。512K 詞元上下文靠 zigzag-ring-attention 達成。對比損失訓練大幅減少退化問題。
效能
在 HTML 轉 Markdown 任務上,該模型取得 ROUGE-L 0.84、Jaro-Winkler 0.82、Levenshtein 距離 0.22,勝過 Qwen2.5-32B-Instruct 與 Gemini2-flash-expr。在 HTML 轉 JSON 任務上,它以 F1 分數 0.81、98% 通過率維持具競爭力的表現。在 T4 GPU 上,它的處理速度為輸入 67 詞元/秒、輸出 36 詞元/秒。退化問題(詞元迴圈、重複輸出)透過對比損失訓練大幅減少。512K 詞元上下文視窗讓大多數真實文件都不必分塊。
最佳實務
該模型可透過 Google Colab 筆記本試用,內容示範 HTML 轉 Markdown、JSON 擷取與指令遵循。HTML 轉 Markdown 任務直接輸入原始 HTML,不需前置指令。JSON 擷取則在提示中指定目標結構。create_prompt 輔助函式可為這兩類任務快速建立提示。模型可在 Colab 免費 T4 GPU 層級執行(需要 vllm 與 triton),但缺少 bfloat16 或 Flash Attention 2 支援時會有限制;生產環境建議用 RTX 3090/4090。可透過 AWS SageMaker、Azure 與 GCP 市集取得。以 CC BY-NC 4.0 授權供非商業使用。把它當成 RAG 管線的前處理步驟:先用它把網頁內容轉成乾淨的 Markdown,再交給 jina-embeddings-v5-text-small 向量化。