向量模型
jina-code-embeddings-0.5b
 GGUF
 Jina API
 AWS SageMaker
 Microsoft Azure
 谷歌雲
 Hugging Face
 物理隔離
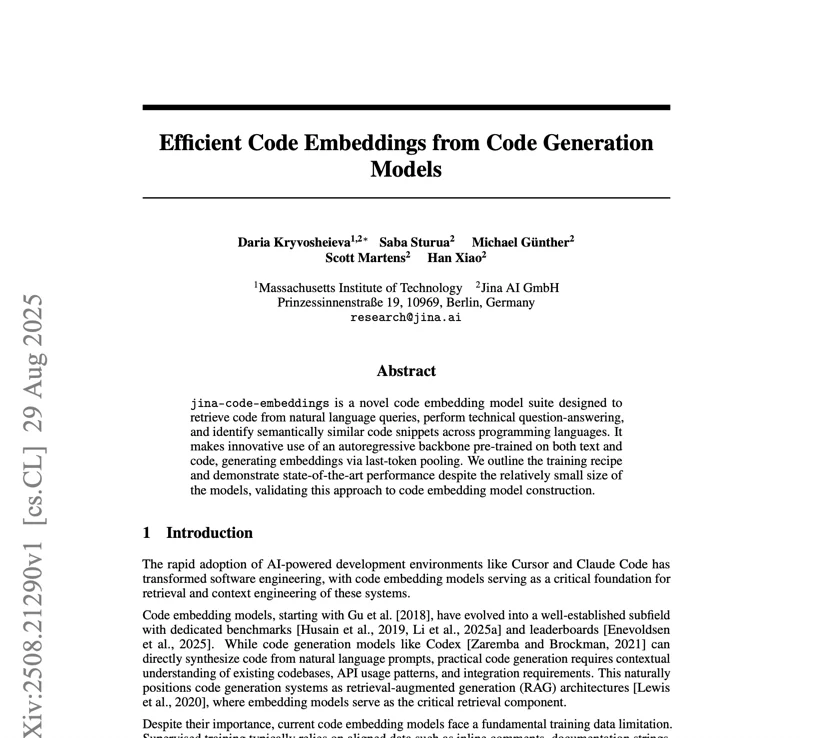
概述
jina-code-embeddings-0.5b 是一個 494M 參數的程式碼向量模型,將程式碼和自然語言查詢映射到共享的 896 維語意空間。它支援 32K token 上下文視窗,可實現整個函式和多重檔案檢索,並使用 Matryoshka 表示學習實現靈活維度(64–896)。它在同尺寸中達到最先進的程式碼檢索性能,超過參數量為其 3 倍的模型。
方法
該模型建構在自然語言和程式碼語料上預訓練的自回歸 Transformer 骨幹之上。與傳統向量模型使用的雙向池化不同,它透過 Last-Token-Pooling 從序列的最終位置提取向量。這是一個關鍵的架構洞見:自回歸模型的因果注意力自然地關注完整輸入上下文,而程式碼生成預訓練目標產生豐富的語意表示,能很好地遷移到檢索。訓練採用兩階段方案:(1) 在大幅度的程式碼-文字對(自然語言描述與程式碼實現配對)上進行對比預訓練,(2) 在精選的程式碼檢索資料集上以困難負樣本挖掘進行監督微調。32K 上下文長度透過調整基礎頻率的旋轉位置編碼實現。
效能
該模型在標準程式碼檢索基準上取得 78.41% 的總平均和 78.72% 的 MTEB Code 平均。值得注意的分數:HumanEval 96.77%、MBPP 89.01%、WikiSQL 98.31%、CodeChefXLang 99.70%、CodeTransOceanContest(程式碼到程式碼)90.37%、COIR-CodeSearchNet(NL2Code)85.73%、Doc2Code 95.98%、StackOverflowQA 91.04%。在程式碼特定任務上,它超過 Qwen3-Embedding-0.6B 以及更大的模型,包括 jina-embeddings-v4(74.11%)和 gemini-embedding-001(77.38%)。在 494M 參數下,它超過多個尺寸為其 3–5 倍的模型,證明自回歸骨幹方法每參數提供高語意品質。
最佳實踐
始終使用適當的任務特定指令前綴:自然語言到程式碼搜尋用 nl2code,程式碼到程式碼相似度用 code2code,程式碼到自然語言用 code2nl,技術問答用 techqa,程式碼補全用 code2completion。對於大型程式碼庫,在函式或類別邊界處實現分塊,以保持在 32K token 限制內。Matryoshka 截斷到 128 或 256 維適合高吞吐索引;重排序頂級候選時使用完整的 896 維。使用餘弦相似度比較向量。最佳批次大小為 512,序列長度 512 token。該模型針對 Python、JavaScript、Java、PHP、Go 和 Ruby 最佳化,但支援 30 多種語言。對於程式碼的 RAG 流水線,第二階段搭配 jina-reranker-v3.5,以最大化前 50 候選的精確度。