

 向量模型
 重排模型
jina-colbert-v2
 Jina API
 AWS SageMaker
 Microsoft Azure
 谷歌雲
 Hugging Face
 物理隔離
概述
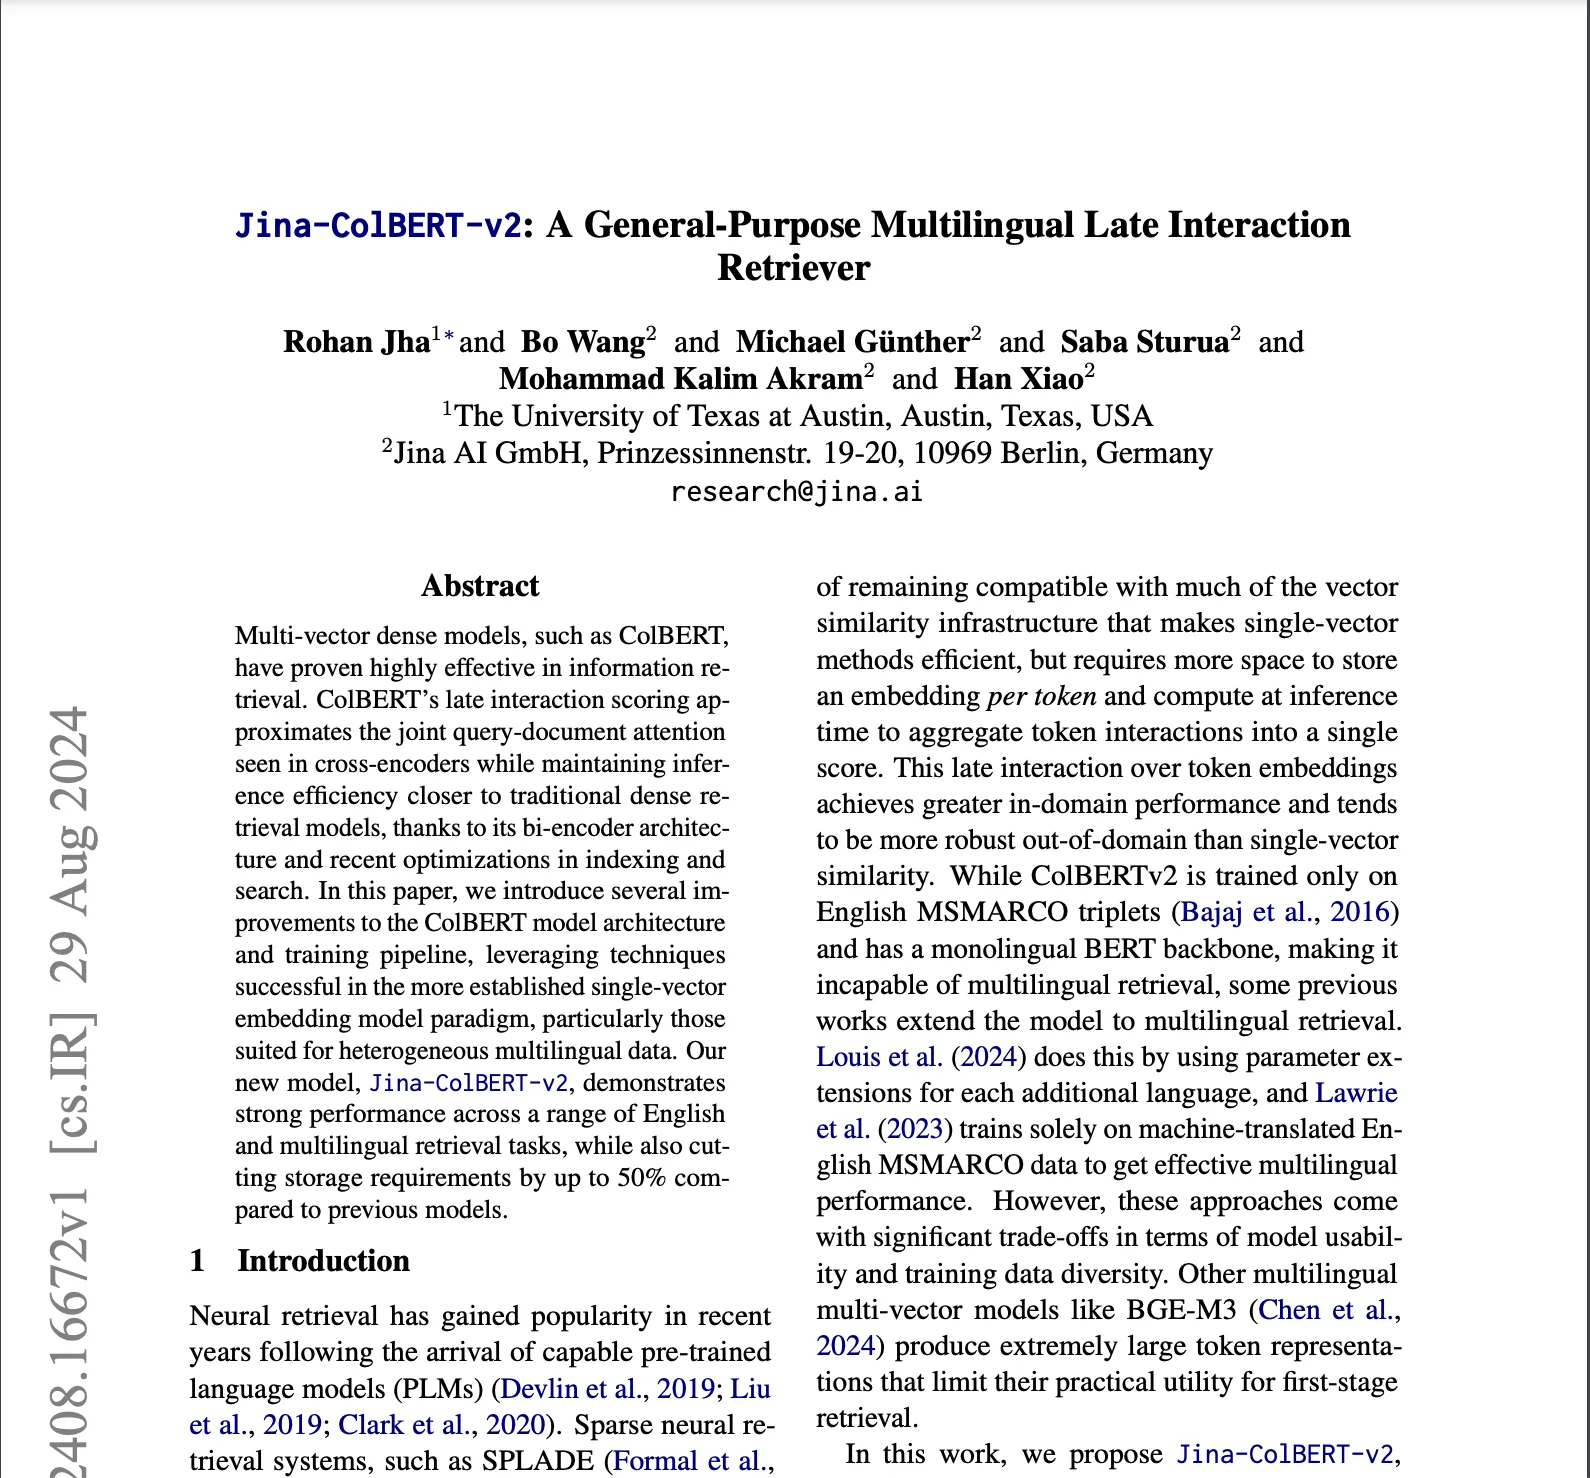
jina-colbert-v2 是一個 560M 參數的多語遲交互檢索模型,支援 89 種語言。它是首個產生緊湊 token 級向量(每 token 64–128 維)的多語 ColBERT 類模型,實現可擴展、經濟的多語搜尋。Matryoshka 表示學習允許將維度從 128 降至 64,性能僅下降 1.5%,儲存需求減半。
方法
該模型基於 ColBERT 遲交互架構,採用改進的 XLM-RoBERTa 骨幹(560M 參數),增強旋轉位置編碼並以 Flash Attention 最佳化。訓練涉及兩個關鍵階段:(1) 在來自各種語言的多樣弱監督資料上進行初始預訓練,(2) 使用標註三元組資料並藉助更大教師模型的監督蒸餾進行微調。關鍵創新是為多向量表示實現 Matryoshka 表示學習:模型從單一訓練過程產生 128、96 或 64 維的 token 級向量,無需重新訓練即可實現動態儲存最佳化。8,192 token 的文件上下文(可擴展至 12,288)和 32 token 的查詢限制透過 ALiBi 位置編碼管理。
效能
該模型在英語任務上較原始 ColBERT-v2 提升 6.5%,在 14 個 BEIR 基準上平均得分 0.521。它在 MIRACL 基準的所有測試語言上超過傳統 BM25 檢索方法,在跨語言場景中表現尤為突出。從 128 維降到 64 維僅導致 1.5% 的性能下降,同時儲存需求減半——例如,在 AWS 上用 64 維向量儲存 1 億個文件每月花費 659.62 美元,而 128 維需 1,319.24 美元。模型的多語覆蓋(89 種語言)和緊湊的 token 向量使其非常適合全球搜尋應用。
最佳實踐
該模型需要支援 CUDA 的硬體以獲得最佳性能。它支援最長 8,192 token 的文件(可擴展至 12,288),查詢限制為 32 token。生產部署可透過 Jina Search Foundation API、AWS 市場和 Azure 獲得,Hugging Face 上有非商業版本。實施時請指定是嵌入查詢還是文件——該模型使用非對稱編碼。該模型不適合在沒有適當索引的情況下即時處理超大規模文件集合;請使用 FAISS、Qdrant 或 Weaviate 進行 ANN 搜尋。對於領域特定任務,請在您的語料上微調。對於需要更高維度輸出的單向量檢索,請考慮 jina-embeddings-v4(多向量模式)或 jina-embeddings-v5-text-small。




