向量模型
jina-embeddings-v3
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Microsoft Azure
 谷歌雲
 Hugging Face
 物理隔離

概述
jina-embeddings-v3 是一個 570M 參數的多語言文本向量模型,支援 89 種語言和 8,192 token 的上下文視窗。其標誌性創新是使用任務特定的 LoRA 適配器:相同的 570M 骨幹透過切換輕量級適配器權重(每個 60M 參數以內)為檢索、分類、聚類和文本匹配生成優化的向量。發布時它取得了 SOTA 的 MTEB 性能,在英語任務上超過了 OpenAI 和 Cohere 的專有向量。
方法
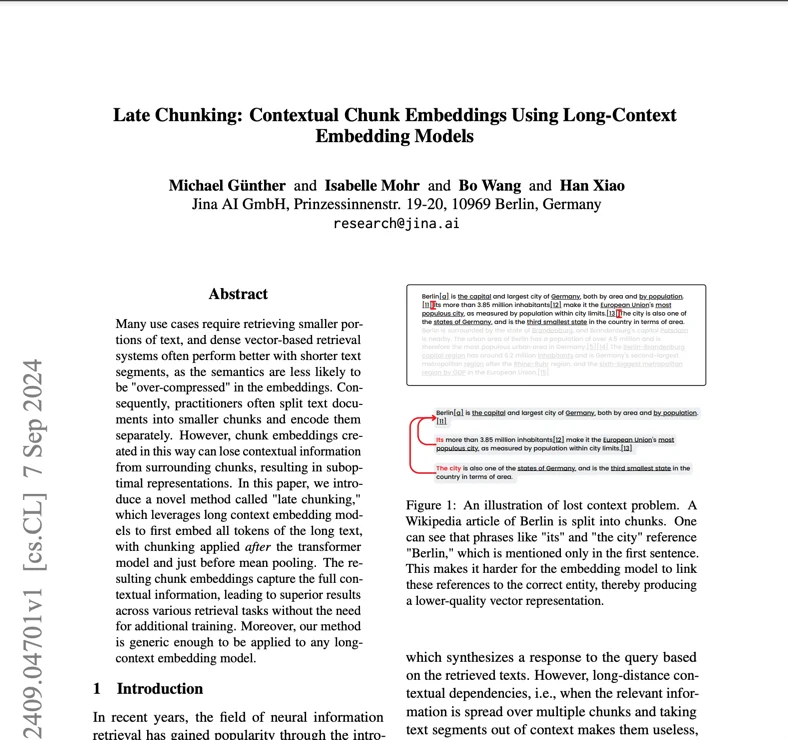
該模型基於具有 24 層 Transformer 的 jina-XLM-RoBERTa 骨幹建構,使用 RoPE(旋轉位置編碼)並針對長上下文外推調整了基礎頻率,最高支援 8,192 token。訓練遵循三階段課程:(1) 89 種語言的多語言預訓練,(2) 在配對文本資料集上進行對比微調以建立基礎向量品質,(3) 任務特定的 LoRA 適配器訓練。每個 LoRA 適配器僅增加不到 3% 的總參數量,同時讓模型專精於特定任務:非對稱搜尋的 retrieval.query 和 retrieval.passage、聚類的 separation、分類的 classification 以及語義相似度的 text-matching。Matryoshka 表示學習(MRL)允許將向量從 1024 截斷到 32 維,同時在 64 維下保留 90% 以上的檢索品質。支援 late chunking 處理超出上下文視窗的文件。
效能
在 MTEB 上,jina-embeddings-v3 在所有任務上的平均得分為 65.52,在分類(82.58)和句子相似度(85.80)上表現尤為突出。它在所有多語言任務上超過了 multilingual-e5-large-instruct,並在英語任務上擊敗了 e5-mistral-7b-instruct(參數量為 12 倍)。在多語言 MTEB 上,它得分 64.44,展現了跨 89 種語言的一致性表現。MRL 截斷在 64 維下保留了 92% 的檢索性能,而完整維度為 1024。2026 年,jina-embeddings-v5-text-small 在大多數工作負載上取代該模型,提供 32K 上下文和基於蒸餾的訓練,帶來每參數更高的精度。
最佳實踐
為您的任務選擇合適的 LoRA 適配器:retrieval.query/retrieval.passage 用於搜尋,separation 用於聚類,classification 用於分類,text-matching 用於語義相似度。對超過 8,192 token 的文件使用 `late_chunking 參數。Matryoshka 截斷到 256 或 512 維適合儲存受限的索引;重排序請使用完整的 1024 維。該模型需要支援 CUDA 的 GPU 才能達到生產吞吐量。對於新的多語言專案,優先選擇 jina-embeddings-v5-text-small`(32K 上下文、蒸餾訓練、更高精度)。該模型並非為文本生成或複雜推理設計——它產出的是向量,而非文本。