向量模型
 Qwen Research License
jina-embeddings-v4
Qwen Research License GGUF
 Jina API
 Hugging Face
 實體隔離
概述
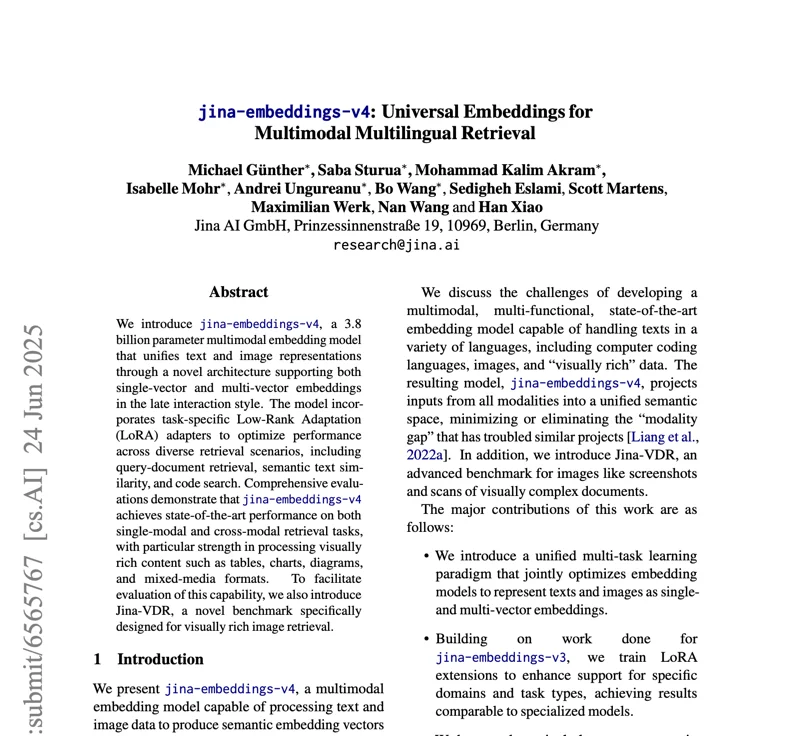
jina-embeddings-v4 是一個 3.8B 參數的多模態向量模型,把文字與圖片的表示統一在同一套架構裡。它獨有之處在於同時支援單向量(dense)與多向量(延遲互動/ColBERT 風格)兩種輸出模式,團隊不必換模型就能在索引效率與檢索精確度之間取捨。該模型在視覺內容豐富的文件檢索上取得 SOTA 效能,原生處理表格、圖表、示意圖與混合媒體格式。
方法
該架構把大型 Transformer 編碼器骨幹與以 Qwen2.5-VL 為基礎的視覺編碼器結合,透過共享注意力層處理文字(最多 32K 詞元)與圖片(768×28×28 圖塊)。三個任務特定的 LoRA 適配器(各 60M 參數)分別讓模型專精於:非對稱的查詢對文件檢索、語意文字相似度、程式碼搜尋。雙輸出設計是關鍵創新:模型可產生單一 2048 維 dense 向量(供快速 ANN 索引,並可經 Matryoshka 截斷到 128 維),或產生一組 128 維詞元級向量供延遲互動評分。訓練採兩階段課程:先在文字與圖片、文字與文字配對上做聯合對比預訓練,再進行任務特定的 LoRA 適配器訓練。文件超過 32K 詞元上下文視窗時支援 late chunking。適用 Qwen Research License。
效能
在 JinaVDR(視覺文件檢索)上,該模型平均得分 72.19,ColPali-v1.2 則為 64.50。在 ViDoRe 上,它平均達 84.11(多向量模式 90.17),ColPali 為 83.90。跨模態檢索在 CLIP 基準上達 84.11,勝過 jina-clip-v2(81.12)與 nllb-clip-large-siglip(83.19)。文字檢索得分:MTEB-en 55.97、MMTEB 66.49、LongEmbed 67.11(jina-embeddings-v3 為 55.66)。語意相似度在 English STS 上達 85.89,多語言 STS 上 72.70。程式碼檢索在 CoIR 上得分 71.59。跨模態對齊的餘弦相似度達 0.71(OpenAI CLIP 為 0.15)。多向量模式在視覺內容豐富的任務上穩定優於單向量模式;單向量模式則為標準文字檢索提供高效率。
最佳實務
依管線需求選擇輸出模式:大規模 ANN 索引用單向量(可經 Matryoshka 截斷到 128–512 維),視覺內容豐富文件的前 k 名候選重排序用多向量。透過 API 的 task 參數選擇 LoRA 適配器:查詢對文件搜尋用 'retrieval',語意相似度用 'text-matching',程式碼檢索用 'code'。文件超過 32K 詞元時,使用 `late_chunking。每個 LoRA 適配器只多出 60M 參數,開銷可忽略(記憶體增加 <2%),三個適配器還能同時載入。該模型採 Qwen Research License(僅限非商業用途,不提供商業授權)。生產部署請用支援 CUDA 的 GPU;模型可透過 Jina API、AWS、Azure 與 GCP 市集取得。純文字工作負載可改用 jina-embeddings-v5-text-small`,它以一小部分運算成本換到更高的每參數精確度。