向量模型
jina-embeddings-v5-omni-nano
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Hugging Face
 macOS
 實體隔離
概述
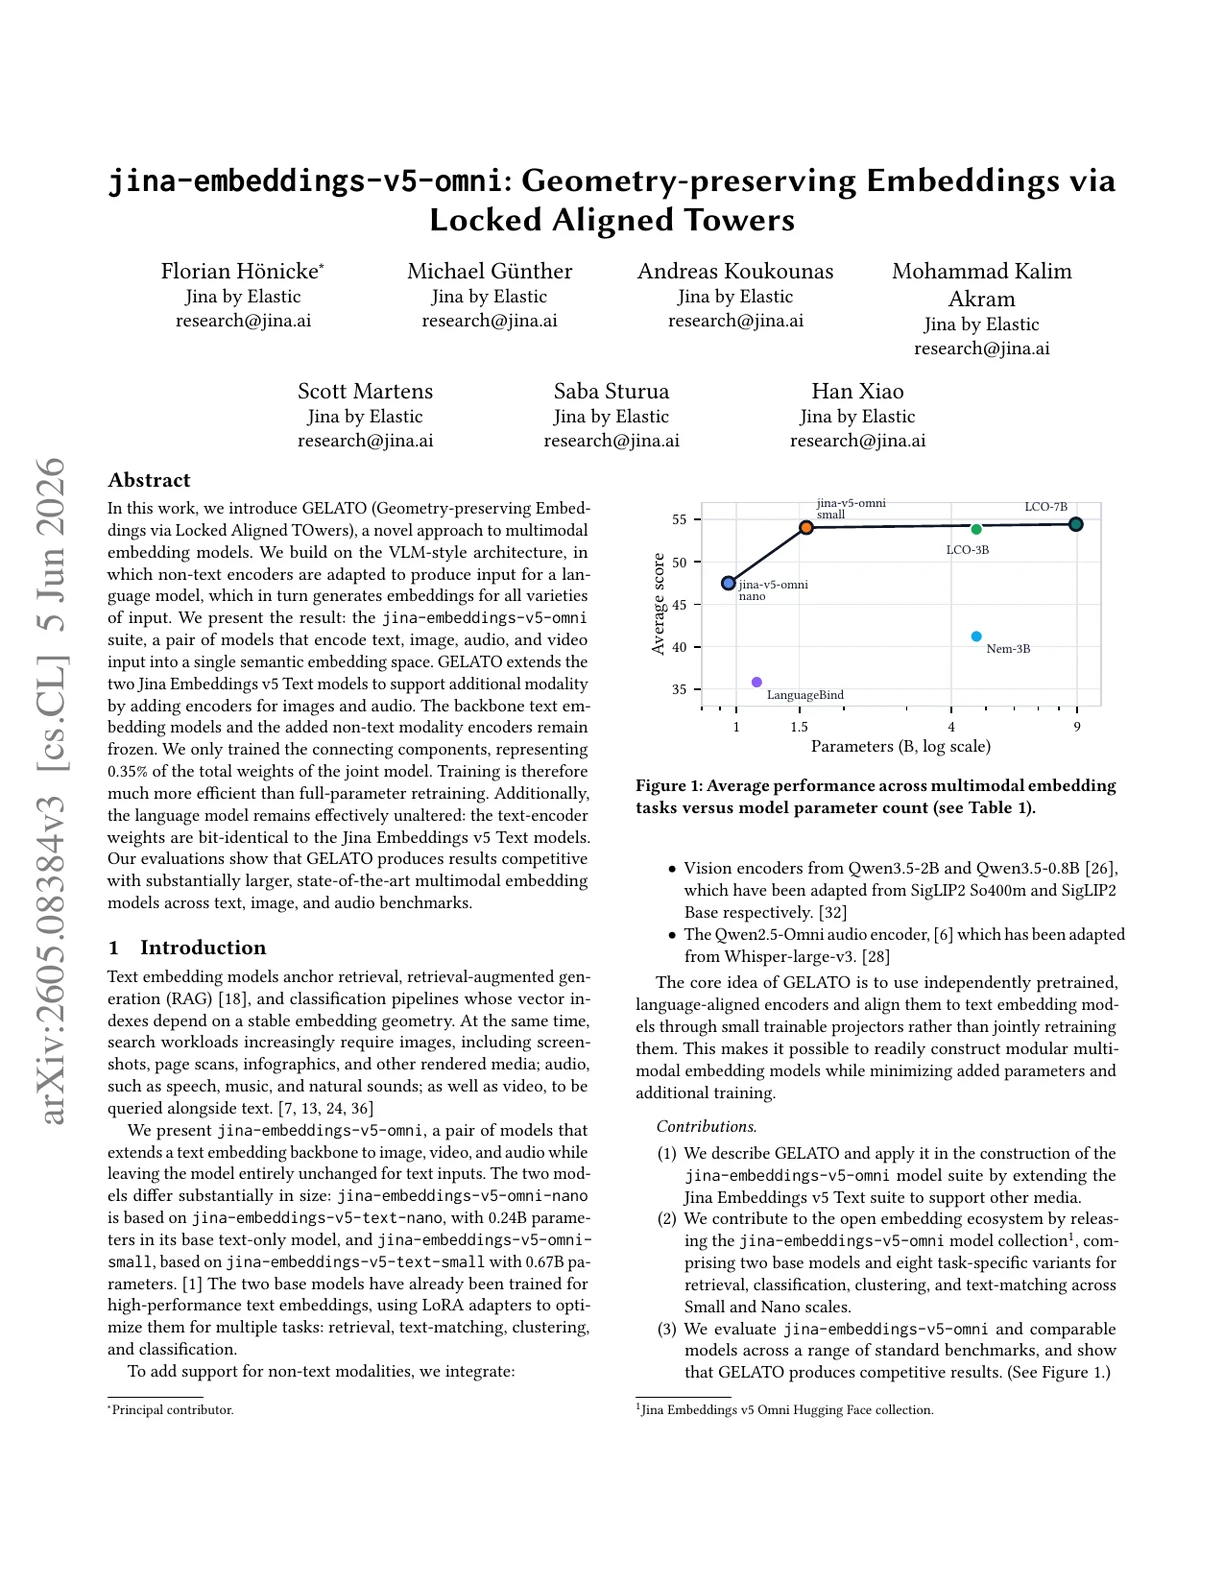
jina-embeddings-v5-omni-nano 是一個約 1.04B 參數的多模態向量模型,可接受文字、圖片、影片、音訊與 PDF,並在共享向量空間中產生向量。它是 v5-omni 系列的輕巧版本,專為沒有 GPU 可用的邊緣與一般硬體而設計。純文字輸出與 jina-embeddings-v5-text-nano 位元完全相同,因此從純文字升級到多模態是即插即用,不必重建索引。
方法
該模型透過第三階段訓練,把 jina-embeddings-v5-text-nano 擴充出多模態能力。EuroBERT-210M 文字骨幹與全部四個任務特定 LoRA 適配器都凍結,只有跨模態投影器是新訓練的。SigLIP2 Base 視覺編碼器處理圖片與影片(每段影片均勻取樣 32 幀)。Whisper-large-v3 音訊編碼器處理音訊輸入。PDF 頁面先渲染成圖片,再走視覺路徑處理。訓練使用搭配跨模態困難負樣本的對比損失,把視覺與音訊表示對齊到既有的文字向量空間。768 維輸出空間支援 Matryoshka 截斷至 32 維。8K 詞元上下文視窗涵蓋文字輸入,圖片與音訊輸入則由各自的編碼器處理。
效能
純文字表現與 jina-embeddings-v5-text-nano 位元完全相同(MMTEB 任務級平均 65.5、英文 MTEB 71.0)。由於 768 維向量空間較窄(對比 1024 維)、文字骨幹也較小,多模態表現略低於 jina-embeddings-v5-omni-small,但在文字對圖片、文字對音訊與文字對影片檢索上仍維持良好跨模態對齊。該模型針對 CPU 與邊緣硬體最佳化,在那些環境裡,更大的 omni-small 無法有效率地執行。跨模態檢索品質在同尺寸等級中具競爭力。
最佳實務
用法與 jina-embeddings-v5-omni-small 相同:選擇對應的 LoRA 適配器(retrieval、text-matching、clustering、classification),並經 API 直接傳入圖片 URL、音訊檔 URL、影片檔 URL 或 PDF URL——模型會把每種模態送進對應的編碼器。支援的音訊格式:WAV、MP3、FLAC、OGG、M4A、Opus。影片輸入以均勻取樣的 32 幀處理。同一個批次裡可以自由混搭模態;向量空間由所有模態共用。比較請用餘弦相似度。支援從 768 維到 32 維的 Matryoshka 截斷。純文字向量與 jina-embeddings-v5-text-nano 即插即用相容——升級時不必重建索引。需要更高精確度的伺服器部署,請改用 jina-embeddings-v5-omni-small(1024 維、更大的骨幹)。