向量模型
jina-embeddings-v5-text-nano
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Hugging Face
 物理隔離
概述
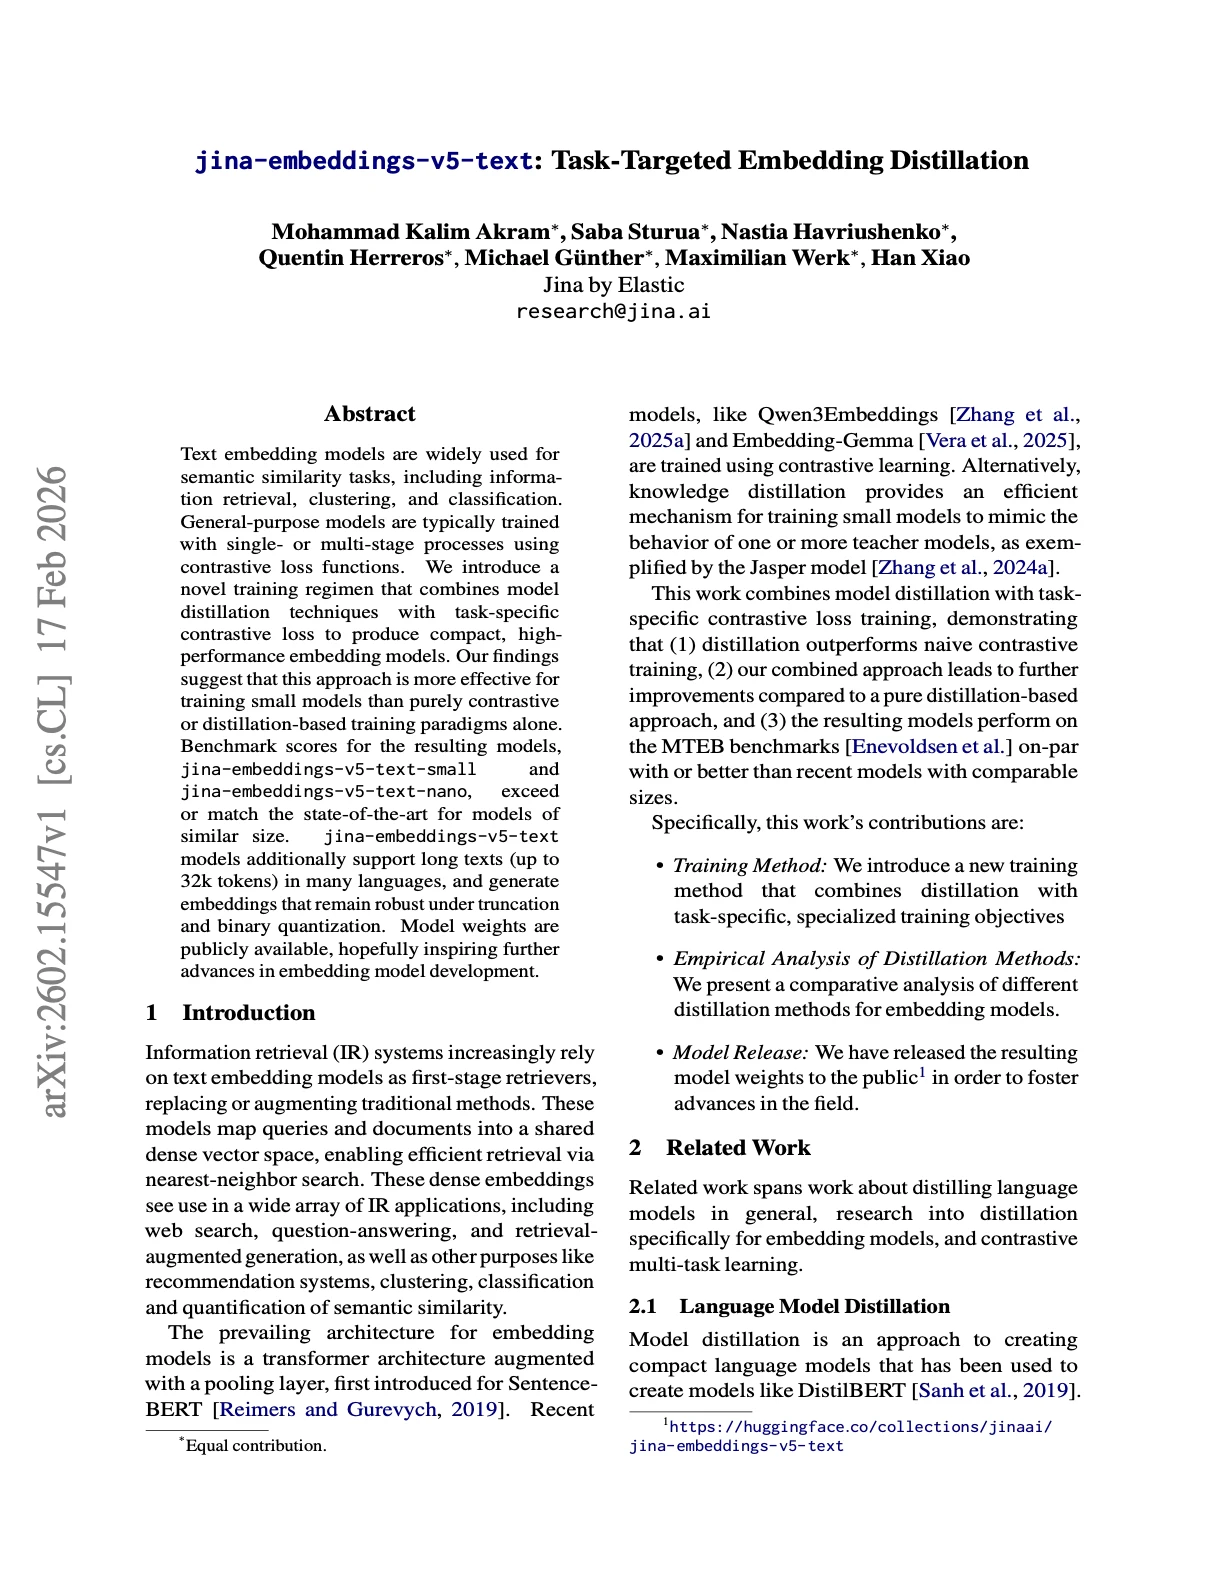
jina-embeddings-v5-text-nano 是構建在 EuroBERT-210M 骨幹上的 239M 參數多語言文本向量模型。它支援 8K token 上下文,生成可用 Matryoshka 截斷至 32 維的 768 維向量,並交付 Jina 的 500M 以下向量家族中每參數最高精度。專為無完整 GPU 可用的邊緣部署、延遲敏感應用和資源受限環境而設計。
方法
該模型基於 EuroBERT-210M——一個在覆蓋 15 種主要語言的多語言資料上預訓練的緊湊雙向編碼器。它採用 Last-Token-Pooling 從最終 token 表示生成向量。訓練遵循兩階段蒸餾方案:首先,從更大的教師模型進行知識蒸餾以轉移向量品質;其次,用任務特定的對比損失在檢索、文字匹配、群聚和分類任務上微調模型。Matryoshka Representation Learning 允許在任何受支援尺寸(32、64、128、256、512、768)截斷向量維度,同時保持強效能。Geometric Orthogonal Regularization(GOR)將二進位量化下的效能退化限制在 MTEB 檢索上不到 2 分。8K 上下文視窗實現無需分塊的長文件處理。
效能
在 MMTEB(多語言)上,該模型僅以 239M 參數取得任務級平均 65.5 和類型級平均 57.7,超越了 500M 以下的所有模型,包括 KaLM-mini-v2.5(60.1,494M)、voyage-4-nano(58.9,480M)和 Gemma-300M(61.1,308M)。任務級分數:分類 69.2、群聚 52.7、成對分類 81.9、重排序 64.6、檢索 63.3、STS 78.2。在英文 MTEB 上,它取得 71.0 平均,幾乎追平大得多的 jina-embeddings-v5-text-small(71.7)。檢索專項:MTEB-M 63.26、RTEB 64.08、BEIR 56.06、LongEmbed 63.65。得益於 GOR 正則化,向量在二進位量化下依然穩健。
最佳實踐
選擇適當的任務前綴:非對稱查詢-文件檢索用 'retrieval',對稱相似度用 'text-matching',群組用 'clustering',分類用 'classification'。Matryoshka 截斷到 256 維可保留 95% 以上的檢索品質,同時減少 67% 的儲存。支援二進位量化以進一步減少儲存。EuroBERT 骨幹為包括英文、法文、德文、西班牙文、中文、日文、阿拉伯文和印地文在內的 15 種主要語言提供強覆蓋。使用餘弦相似度比較向量。可透過 Jina AI API、Hugging Face(Sentence Transformers、vLLM)和 llama.cpp 的量化變體取得。對於需要 32K 上下文或更高精度的工作負載,請改用 jina-embeddings-v5-text-small。