重排模型
jina-reranker-v3.5
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Microsoft Azure
 谷歌雲
 Hugging Face
 物理隔離
概述
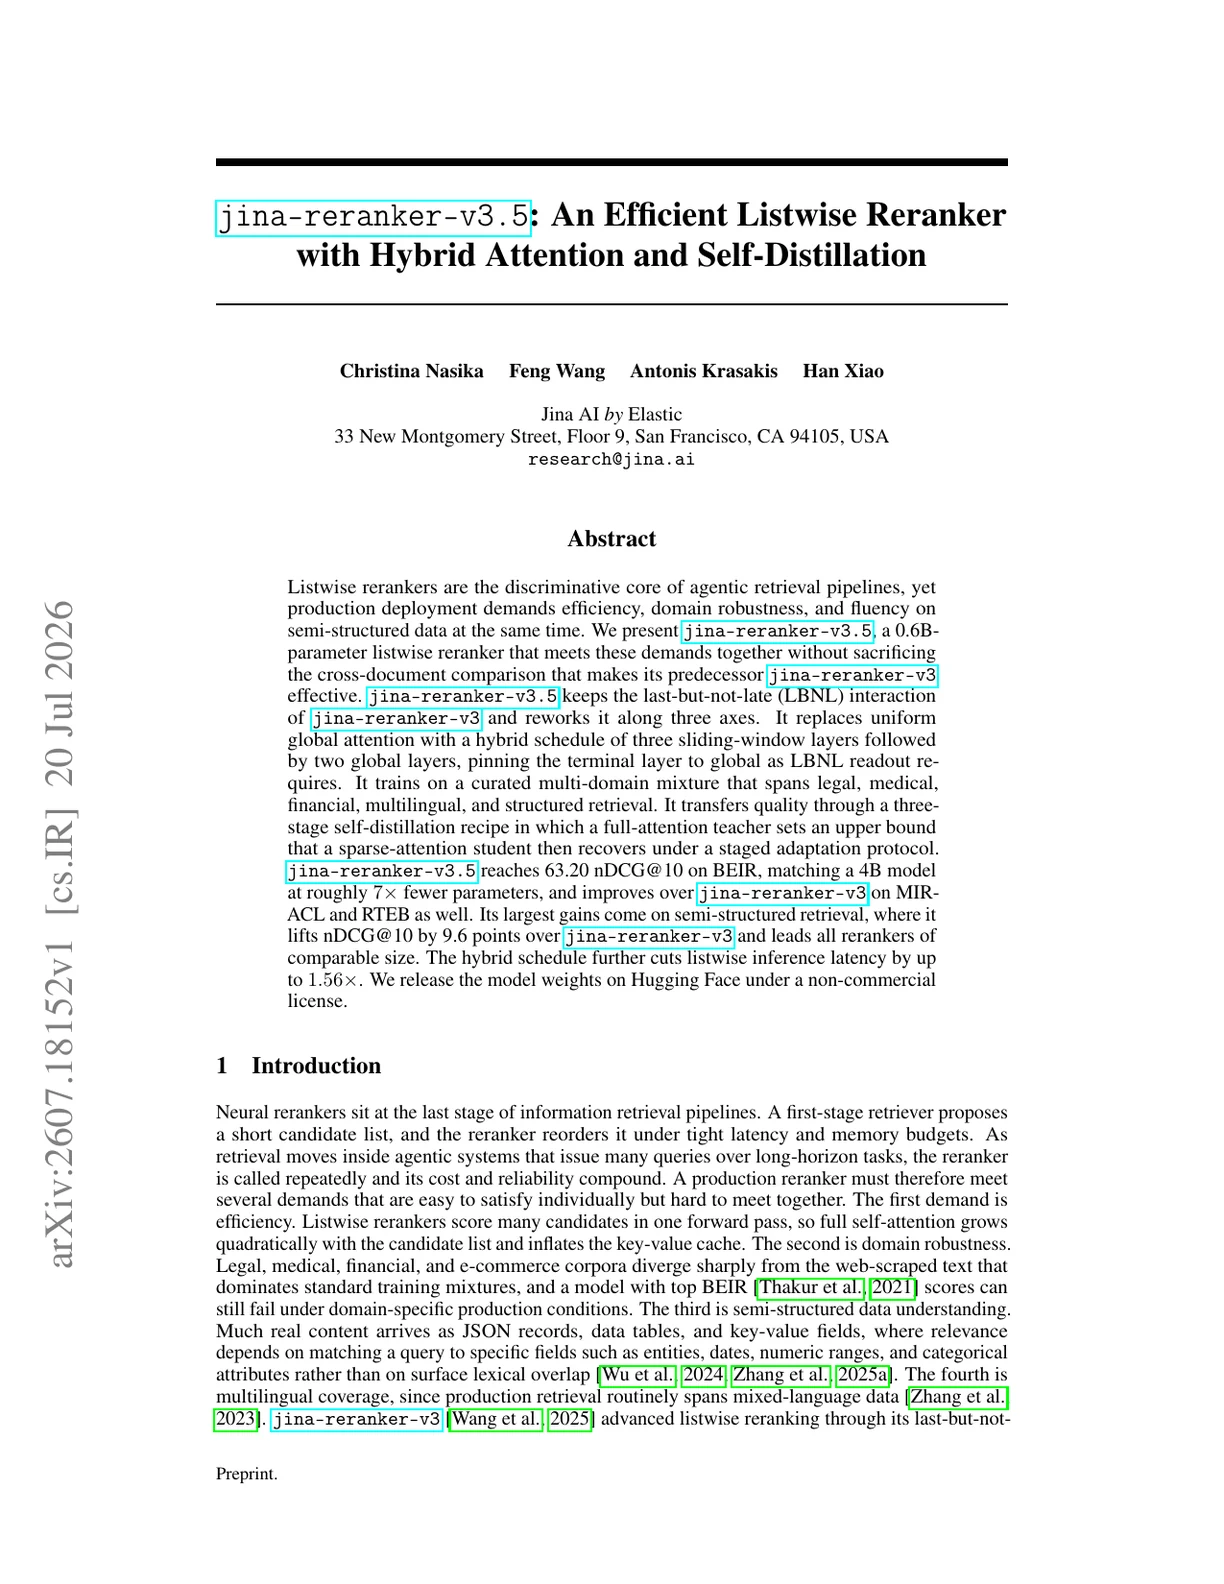
jina-reranker-v3.5 是一個 0.6B 參數的 listwise 重排序模型,參數量僅為 4B 參數模型的約 1/7,性能卻與之相當。它引入混合注意力計畫(三個滑窗層 + 兩個全局層)配合三階段自蒸餾配方,將品質從全注意力教師模型轉移到稀疏注意力學生模型。它是 jina-reranker-v3 的即插即用替代,保持相同的 API 模式,同時提升效率和領域覆蓋。
方法
架構保留了 jina-reranker-v3 的 LBNL listwise 設計:查詢和所有候選文件共享單個上下文視窗,向量從每個文件的最後一個 token 讀取。核心創新是混合注意力計畫。模型不使用每層均勻的全局注意力,而是用三個滑窗注意力層(將每個位置的注意力限制在局部視窗)後接兩個全局注意力層。由於 LBNL 讀出機制要求最後一個 token 關注完整上下文,最後一層固定為全局注意力。訓練分三階段進行:(1) 全注意力教師模型在涵蓋法律、醫療、金融、多語言和結構化檢索的精選多領域混合上訓練;(2) 稀疏注意力學生模型從教師初始化,透過分階段適應微調,逐步增加使用混合計畫的訓練步比例;(3) 最終蒸留遍,學生學習匹配教師的軟排名分佈,在運行更廉價的稀疏注意力推理路徑的同時恢復教師 97% 以上的排名品質。
效能
在以 jina-embeddings-v5-text-small 作為一級檢索器的統一 top-100 協議下,該模型在 BEIR 上得分 63.20 NDCG{'@'}10、MIRACL 74.11、RTEB 70.95、Struct-IR 48.3,在各項指標上均超過 jina-reranker-v3(62.10 / 72.20 / 68.01 / 38.7)。其 BEIR 分數以約為 4B Qwen3-Reranker 的 1/7 的參數量,略勝後者(62.28)。相對 v3 的提升包括 BEIR +1.10、MIRACL +2.6%、RTEB +4.3%(法律檢索大幅改善)以及結構化資料排序(Struct-IR)+24.8%。listwise 推理從短上下文到長上下文比 v3 快 1.22–1.56 倍(A100,FlashAttention-2)。多領域訓練混合在半結構化資料(表格、JSON、XML)和領域特定語料上帶來尤其顯著的改善。
最佳實踐
jina-reranker-v3.5 是 jina-reranker-v3 的即插即用替代:請求模式不變,因此切換模型字串無需代碼改動。它在單次呼叫中對查詢與完整候選列表進行排名——將文件透過標準 rerank 端點傳遞,使用 top_n 限制返回結果,或設定 return_embeddings 同時檢索文件向量。該模型在結構化資料排序、法律和其他領域特定檢索以及多語言集合上特別強。其混合注意力設計在長候選列表上保持低延遲。131K token 上下文視窗支援無需分塊的超長文件。在 Hugging Face 上以 CC-BY-NC-4.0 許可提供;商業用途請聯繫 Jina AI。面向隔離或本地部署提供量化權重。與 jina-embeddings-v5-text-small 或 jina-embeddings-v4 配合作為一級檢索器。