重排模型
jina-reranker-v3
 GGUF
 MLX
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 實體隔離
概述
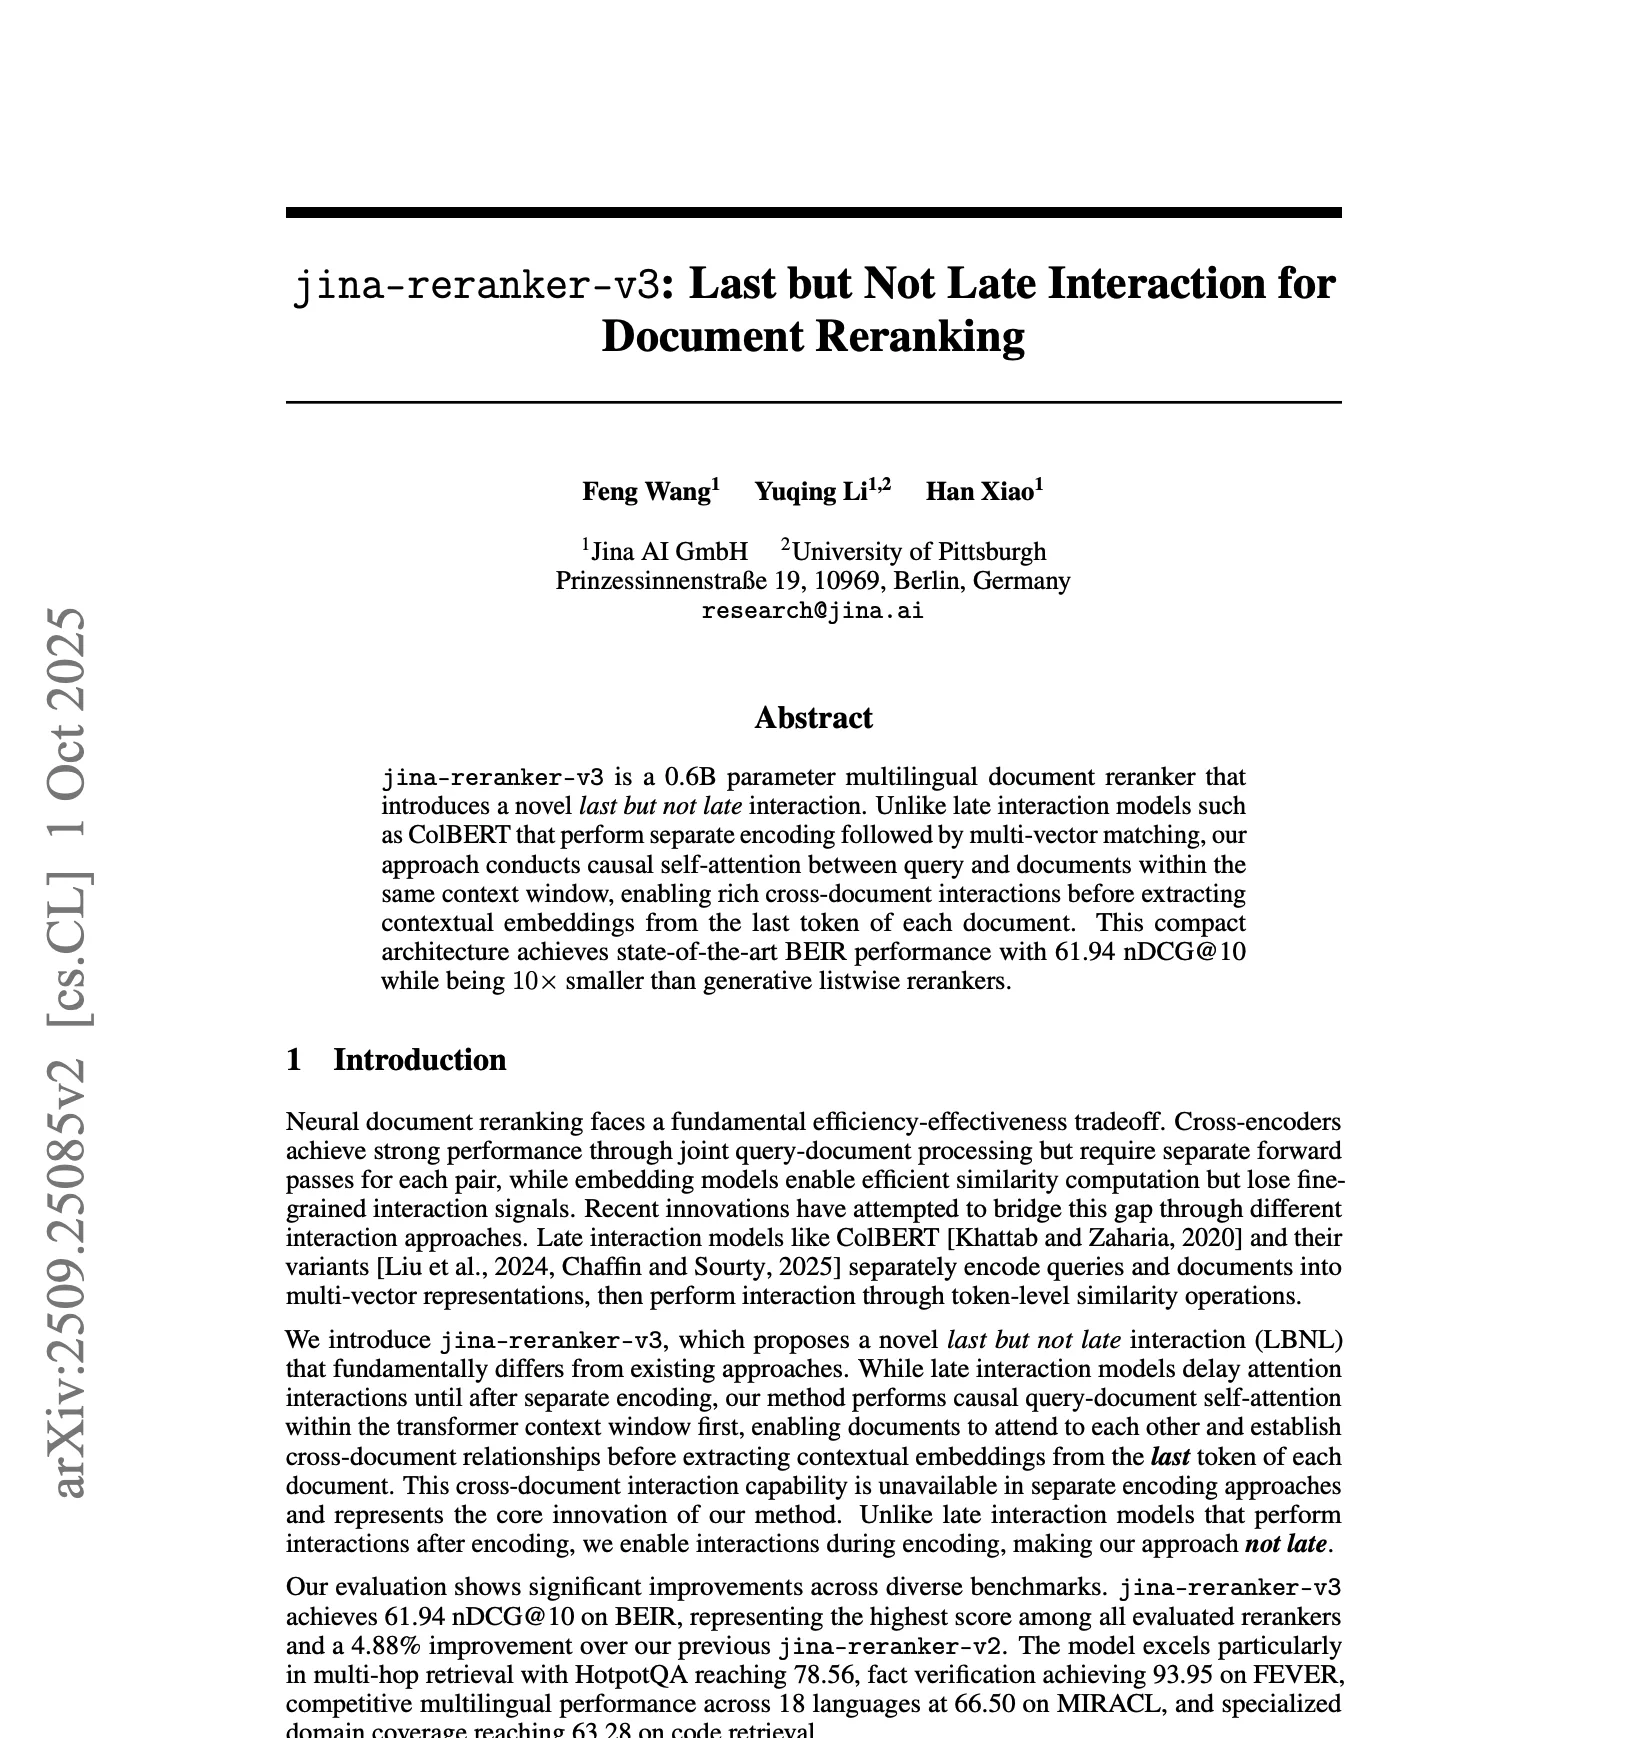
jina-reranker-v3 是一個 597M 參數的多語言 listwise 重排模型,導入「last but not late」(LBNL)互動,是相對於成對交叉編碼器評分的一次典範轉移。它不再孤立評估每個查詢與文件配對,而是在單一 131K 詞元上下文視窗內同時處理整份候選文件清單,用因果注意力捕捉文件之間的關係。參數量比最接近的競品少 60%,仍達到 SOTA 的 BEIR 效能(61.94 NDCG{'@'}10)。
方法
核心創新是 LBNL 架構。標準交叉編碼器對每個查詢與文件配對獨立評分;延遲互動模型(ColBERT)則分開編碼文件,再逐詞元比對。LBNL 結合兩者所長:查詢與所有候選文件共用同一個因果注意力上下文,模型因此能跨文件關注,捕捉成對評分漏掉的相對相關性訊號。模型每次前向傳播最多處理 16 份文件(訓練時為 1 個正例、15 個負例),每份文件截斷至固定長度。向量透過 Last-Token-Pooling 取自每份文件的最後一個詞元,藉因果注意力機制自然彙整前文的資訊。131K 詞元上下文視窗靠調整基底頻率的旋轉位置編碼達成。訓練採三階段漸進課程,多目標損失結合 InfoNCE、分散損失(權重 0.45)、雙重匹配損失(權重 0.85)與相似度損失。
效能
在 BEIR 上,該模型達到 61.94 NDCG{'@'}10,是所有受評重排模型中最高的,比 jina-reranker-v2 提升 4.88%。它在多跳檢索(HotpotQA 78.56)與事實驗證(FEVER 93.95)上表現突出。多語言表現在 18 種語言的 MIRACL 上達 66.50,其中阿拉伯語 78.69、泰語 81.06。程式碼檢索在 CoIR 上達 63.28。它的參數量比 1.5B 的 mxbai-rerank-large 少 2.5 倍,仍勝過後者(61.44),並比同規模的 bge-reranker-v2-m3 提升 5.43%。效能對文件順序相對不敏感:隨機(62.54)、降序(61.94)、升序(61.52)——顯示 listwise 評分穩健,不受候選順序影響。
最佳實務
使用帶 system/user/assistant 角色與特殊詞元的結構化提示範本進行向量提取。集合超過 131K 上下文時,每次前向傳播最多處理 64 份文件。文件隨機排序或依相關性降序排列時效果最佳(效能差異 <1%)。比較排序任務請善用跨文件互動能力——模型的 listwise 設計能捕捉成對評分漏掉的候選之間關係。多語言應用方面,模型在 18 種語言上提供強勁的零樣本遷移。文件集龐大時請分批處理,並在各批次間維持一致的查詢向量。256 維輸出向量支援高效率的相似度計算。適合多跳推理與事實驗證任務。生產環境請改用 jina-reranker-v3.5,透過混合注意力讓推理快 1.22–1.56 倍。