Embeddings
jina-clip-v2
 Elastic Inference Service
 Jina-API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 Air-Gapped
Überblick
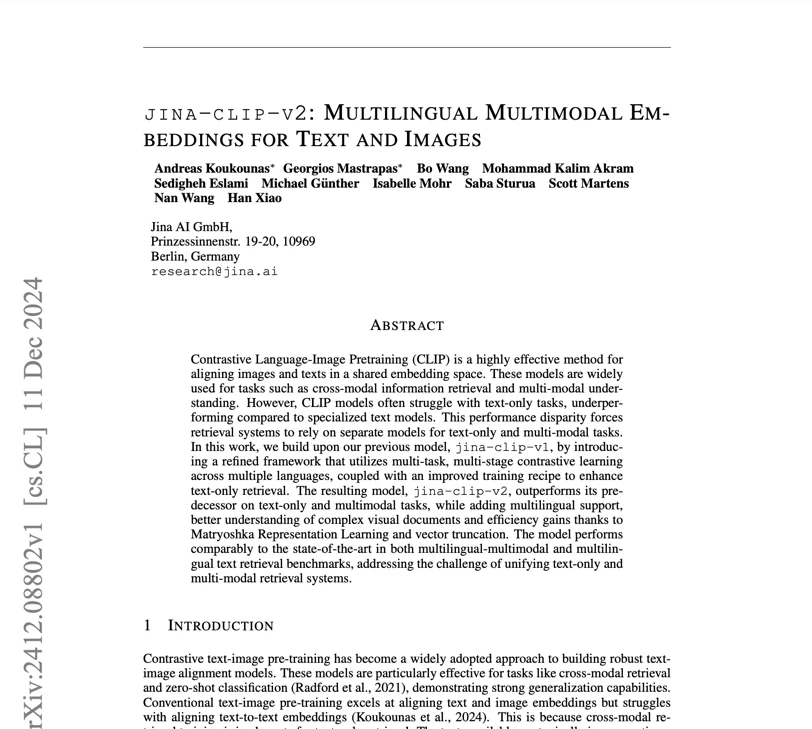
jina-clip-v2 ist ein mehrsprachiges multimodales Embedding-Modell mit 865M Parametern, das 89 Sprachen und 512×512-Bildeingaben unterstützt. Es erweitert jina-clip-v1 um sprachübergreifende Bild-Text-Ausrichtung, Matryoshka-Repräsentationslernen zur Dimensionsreduzierung (1024→64) und verbesserte Performance bei visuell reichen Dokumenten. Es erzielt State-of-the-Art-Werte beim sprachübergreifenden Bild-Retrieval und bleibt gleichzeitig stark im reinen Text-Retrieval und in unimodalen Aufgaben.
Methoden
Das Modell nutzt eine Dual-Encoder-Architektur, die einen Jina-XLM-RoBERTa-Text-Encoder (561M Parameter, 89 Sprachen, 696.320-Token-Kontext) mit einem EVA02-L14-Bild-Encoder (304M Parameter, 512×512-Pixeleingabe) kombiniert. Das Training verwendet ein mehrstufiges kontrastives Multi-Task-Lernparadigma: Das Modell wird gleichzeitig auf Text-Paaren, Text-Tripletts und Bild-Text-Paaren trainiert, um sowohl reine Text- als auch crossmodale Aufgaben zu unterstützen. Der Trainingsdatensatz wurde um mehrsprachige Texte aus 29 nichtenglischen Sprachen (u. a. Hindi, Chinesisch, Deutsch, Französisch) und Bilder visuell reicher Dokumente erweitert. Matryoshka-Repräsentationslernen ermöglicht die Dimensionsreduzierung von 1024 auf 64 Dimensionen unter Beibehaltung von über 99 % der Performance. Das Modell verwendet Last-Token-Pooling für das finale Embedding.
Leistung
Das Modell erreicht 98,0 % Genauigkeit im Flickr30k-Bild-zu-Text-Retrieval und übertrifft sowohl jina-clip-v1 als auch NLLB-CLIP-SigLIP. In mehrsprachigen Szenarien zeigt es bis zu 4 % Verbesserung gegenüber NLLB-CLIP-SigLIP beim sprachübergreifenden Bild-Retrieval. Embedding-Kompression ist bemerkenswert effektiv: Eine Reduktion der Dimensionen um 75 % (1024→256) erhält weiterhin über 99 % der Performance bei Text-, Bild- und crossmodalen Aufgaben. Auf Multilingual MTEB erreicht es 69,86 % bei Retrieval und 67,77 % bei semantischer Ähnlichkeit – wettbewerbsfähig mit spezialisierten Text-Embedding-Modellen. Die Unterstützung von 89 Sprachen und die Verarbeitung visuell reicher Dokumente machen es besonders geeignet für globalen E-Commerce und Content-Management.
Empfehlungen
Bilder vor der Verarbeitung auf 512×512 Pixel verkleinern – größere Bilder werden automatisch in Kacheln aufgeteilt, was den Token-Verbrauch und die Verarbeitungszeit erhöht. Das Modell glänzt beim Zuordnen von Bildern zu beschreibendem Text in 89 Sprachen – ideal für globale E-Commerce-Produktsuche, Content-Empfehlungen und mehrsprachige visuelle Suche. Es kann bei abstrakten Konzepten oder hochspezialisierten Domäneninhalten an Grenzen stoßen. Bei Matryoshka-Dimensionsreduktion liefern 64-dimensionale Embeddings beim Indexieren weiterhin eine starke Performance; für das Re-Ranking in kritischen Anwendungen verwenden Sie mindestens 512 Dimensionen. Das Modell erfordert CUDA-fähige Hardware. Für reine Text-Workloads bietet jina-embeddings-v5-text-small bessere Genauigkeit pro Parameter. Für Code-Retrieval jina-code-embeddings-1.5b verwenden. Verfügbar über Jina API, AWS, Azure und GCP-Marktplätze.