


 Embeddings
 Apache-2.0-Lizenz
jina-embeddings-v2-base-de
Apache-2.0 Jina-API
 AWS SageMaker
 Microsoft Azure
 Hugging Face
 Air-Gapped
 arXiv
Überblick
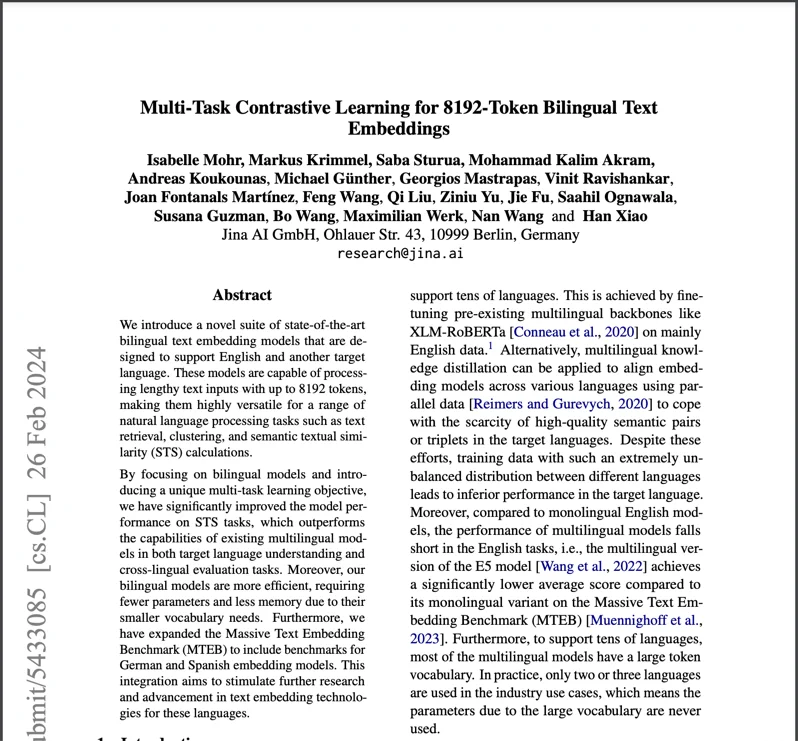
jina-embeddings-v2-base-de ist ein zweisprachiges Text-Embedding-Modell für Deutsch und Englisch mit 161M Parametern und einem 8.192-Token-Kontextfenster. Es bildet semantisch äquivalente Inhalte in beiden Sprachen in denselben 768-dimensionalen Embedding-Raum ab und ermöglicht so sprachübergreifendes Retrieval ohne Übersetzung. Das Modell war eines der ersten zweisprachigen Open-Source-Embedding-Modelle, die Langkontext-Unterstützung mit ausgeglichener Performance in beiden Sprachen verbanden.
Methoden
Auf einem BERT-basierten Backbone mit symmetrischen bidirektionalen ALiBi-Positionskodierungen gebaut, verarbeitet das Modell sowohl Deutsch als auch Englisch in einer einheitlichen Architektur mit 161M Parametern, die 768-dimensionale Embeddings erzeugt. Das Training umfasste drei Stufen: (1) mehrsprachiges Pretraining auf deutsch-englischen Parallelkorpora, (2) kontrastives Feintuning auf kuratierten Satzpaaren mit Hard-Negativen und (3) sprachübergreifendes Alignment-Training, um sicherzustellen, dass semantisch äquivalente Texte in Deutsch und Englisch auf nahe Regionen des Embedding-Raums abgebildet werden. Eine zentrale Designentscheidung war das Ziel der Bias-Minimierung, das die Tendenz mehrsprachiger Modelle zur Bevorzugung englischer grammatischer Strukturen kompensiert – ein dokumentiertes Fehlverhalten früherer mehrsprachiger Embeddings. Das 8.192-Token-Fenster über ALiBi ermöglicht die Verarbeitung ganzer Dokumente in beiden Sprachen ohne Trunkierung.
Leistung
Das Modell übertraf Microsofts E5-base bei vergleichbarer Größe und erreichte die Performance von E5-large, obwohl es etwa halb so groß war. Auf WikiCLIR (Englisch-zu-Deutsch-Retrieval), STS17/STS22 (bidirektionale semantische Ähnlichkeit) und BUCC (zweisprachiges Text-Alignment) übertraf es konsistent Modelle gleicher oder größerer Größe. Der 322MB-Fußabdruck ermöglichte das Deployment auf Standard-Hardware. Im Jahr 2026 ersetzt jina-embeddings-v5-text-small dieses Modell für die meisten Anwendungen und bietet 32K-Kontext, 89 Sprachen und aufgabenspezifische LoRA-Adapter. Das v2-base-de-Modell bleibt für zweisprachige Pipelines Deutsch-Englisch nützlich, bei denen der 8K-Kontext ausreicht.
Empfehlungen
Optimal für zweisprachiges Retrieval Deutsch-Englisch: Produktsuche, Support-Dokumentation und Content-Management, bei denen Anfragen und Dokumente in verschiedenen Sprachen vorliegen können. Für Dokumente über 8.192 Tokens semantisches Chunking oder den `late_chunking-Parameter über die Jina-API verwenden. Das Modell integriert sich mit Qdrant, Weaviate, MongoDB und Milvus. Für neue mehrsprachige Projekte, die mehr als zwei Sprachen umfassen, jina-embeddings-v5-text-small` bevorzugen (89 Sprachen, 32K-Kontext, LoRA-Adapter). CUDA-fähige GPU für den Produktionsdurchsatz empfohlen.


