


 Embeddings
 Apache-2.0-Lizenz
jina-embeddings-v2-base-es
Apache-2.0 Jina-API
 AWS SageMaker
 Microsoft Azure
 Hugging Face
 Air-Gapped
 arXiv
Überblick
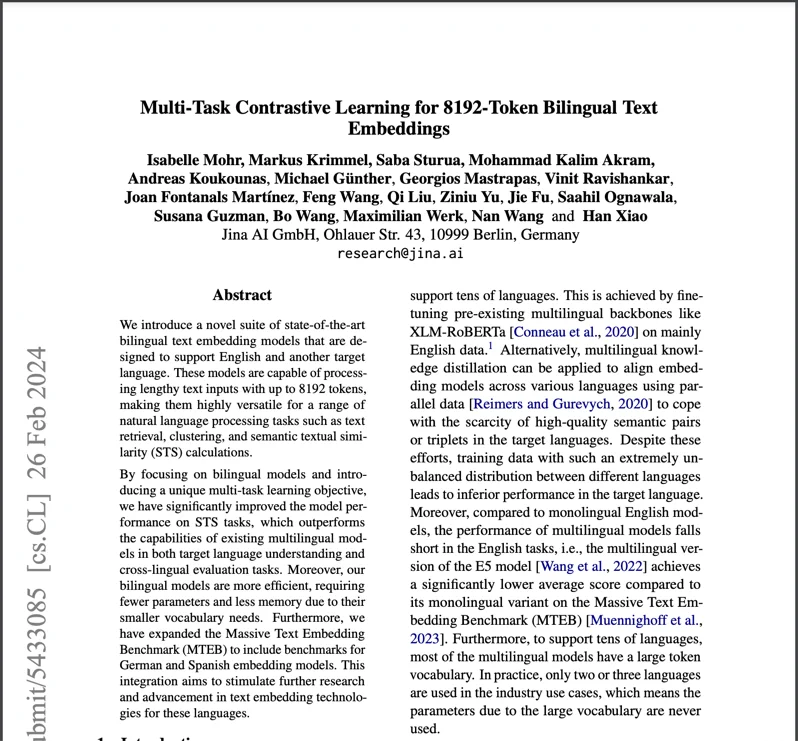
jina-embeddings-v2-base-es ist ein 161M-Parameter zweisprachiges Text-Embedding-Modell für Spanisch und Englisch mit einem 8.192-Token-Kontextfenster und 768-dimensionaler Ausgabe. Es wurde für sprachübergreifendes Retrieval auf spanischsprachigen Märkten entworfen und bildet semantisch äquivalente spanische und englische Inhalte in einen gemeinsamen Embedding-Raum ab. Das Modell adressiert eine kritische Lücke: die meisten Embedding-Modelle seiner Zeit waren englisch-zentriert, während die Leistung auf Spanisch deutlich schlechter war.
Methoden
Das Modell verwendet einen BERT-basierten Backbone mit symmetrischen bidirektionalen ALiBi-Positionskodierungen, 161M Parametern und einem 768-dimensionalen Ausgaberaum. Das Training folgte einem dreistufigen Prozess: (1) Pretraining auf spanisch-englischen Parallelkorpora, (2) kontrastives Feintuning mit Hard-Negative-Mining auf kuratierten Satzpaaren und (3) sprachübergreifendes Alignment, um sicherzustellen, dass Repräsentationen desselben Konzepts auf Spanisch und Englisch zusammenfallen. Der ALiBi-Mechanismus ermöglicht das 8.192-Token-Kontextfenster ohne erlernte Positions-Embeddings und erlaubt dem Modell, über seine 512-Token-Trainingslänge hinaus zu extrapolieren. Mean-Pooling erzeugt den finalen Embedding-Vektor.
Leistung
Das Modell übertraf signifikant größere mehrsprachige Modelle (E5, BGE-M3) in spanisch-englischen Retrieval-Aufgaben, obwohl es nur 15–30 % ihrer Größe erreichte. Es zeigte starke Performance bei den spanischen MTEB-Unteraufgaben, insbesondere bei Retrieval und Clustering. Das 8.192-Token-Kontextfenster lieferte konsistente Performance auf mehrseitigen Dokumenten, bei denen die meisten konkurrierenden Modelle Chunking erforderten. Im Jahr 2026 ersetzt jina-embeddings-v5-text-small dieses Modell und bietet 89 Sprachen, 32K-Kontext und aufgabenspezifische LoRA-Adapter. Das v2-base-es-Modell bleibt eine kostengünstige Option für dedizierte Pipelines Spanisch-Englisch.
Empfehlungen
Ideal für zweisprachige Suche Spanisch-Englisch, Inhaltsempfehlungen und sprachübergreifende Dokumentanalyse. Für Dokumente über 8.192 Tokens semantisches Chunking oder den `late_chunking-Parameter über die Jina-API verwenden. Das Modell integriert sich mit großen Vektor-Datenbanken und RAG-Frameworks. Für neue Projekte, die mehrsprachige Abdeckung jenseits von Spanisch-Englisch, 32K-Kontext oder aufgabenspezifische Optimierung erfordern, jina-embeddings-v5-text-small` bevorzugen. CUDA-fähige GPU für Produktion empfohlen. Die Eingabe sollte auf Spanisch oder Englisch sein; gemischtsprachige Eingabe wird unterstützt, die Performance ist aber für die zwei trainierten Sprachen optimiert.


