


 Embeddings
 Apache-2.0-Lizenz
jina-embeddings-v2-base-zh
Apache-2.0 Jina-API
 AWS SageMaker
 Microsoft Azure
 Hugging Face
 Air-Gapped
 arXiv
Überblick
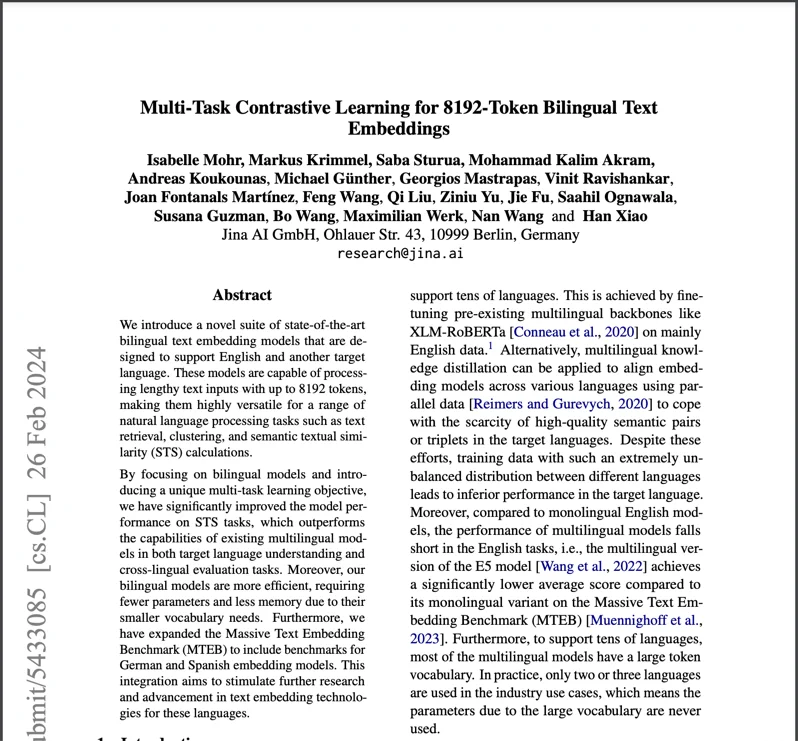
jina-embeddings-v2-base-zh ist ein 161M-Parameter zweisprachiges Text-Embedding-Modell für Chinesisch und Englisch mit einem 8.192-Token-Kontextfenster und 768-dimensionaler Ausgabe. Es war das erste Open-Source-Modell, das Chinesisch und Englisch nahtlos mit Langkontext-Unterstützung verarbeitete, und ging dabei auf die spezifischen Herausforderungen ein, die die Tokenisierung chinesischer, zeichenbasierter Texte in Transformer-Architekturen mit sich bringen.
Methoden
Das Modell verwendet einen BERT-basierten Backbone mit symmetrischen bidirektionalen ALiBi-Positionskodierungen, 161M Parametern und einem 768-dimensionalen Ausgaberaum. Das Training folgte einem dreiphasigen Ansatz: zunächst Pretraining auf hochwertigen chinesisch-englischen zweisprachigen Daten, gefolgt von primären und sekundären Feintuning-Stufen mit kontrastivem Loss und Hard-Negative-Mining. Der ALiBi-Mechanismus ermöglicht das 8.192-Token-Kontextfenster ohne erlernte Positions-Embeddings. Eine bemerkenswerte Verbesserung in der finalen Veröffentlichung war eine verfeinerte Similarity-Score-Verteilung, die Score-Inflation der Preview-Version behob und diskriminativere, besser kalibrierte Similarity-Scores lieferte.
Leistung
Im C-MTEB-Leaderboard (chinesisches MTEB) zeigte das Modell hervorragende Performance unter Modellen unter 0,5GB, insbesondere bei chinesischsprachigen Aufgaben. Es übertraf OpenAIs text-embedding-ada-002 signifikant bei chinesischspezifischen Retrieval- und Ähnlichkeitsaufgaben, während es bei englischen Aufgaben wettbewerbsfähig blieb. Die verfeinerte Similarity-Score-Verteilung verbesserte die Diskriminierung zwischen verwandtem und unverbundenem Inhalt in beiden Sprachen. Im Jahr 2026 ersetzt jina-embeddings-v5-text-small dieses Modell mit 89 Sprachen, 32K-Kontext und aufgabenspezifischen LoRA-Adaptern.
Empfehlungen
Optimal für zweisprachiges Retrieval Chinesisch-Englisch, sprachübergreifende Dokumentensuche und mehrsprachige Inhaltsanalyse. Für Dokumente über 8.192 Tokens semantisches Chunking oder den `late_chunking-Parameter über die Jina-API verwenden. Das Modell integriert sich mit großen Vektor-Datenbanken und RAG-Frameworks. Für neue mehrsprachige Projekte jina-embeddings-v5-text-small` bevorzugen (89 Sprachen, 32K-Kontext, LoRA-Adapter). CUDA-fähige GPU für den Produktionsdurchsatz empfohlen. Die Eingabe sollte auf Chinesisch oder Englisch sein; das Modell verarbeitet beide Sprachen nativ ohne Übersetzung.


