Ingestion de données
jina-ocr-v1
 API Jina
 Hugging Face
 arXiv
Aperçu
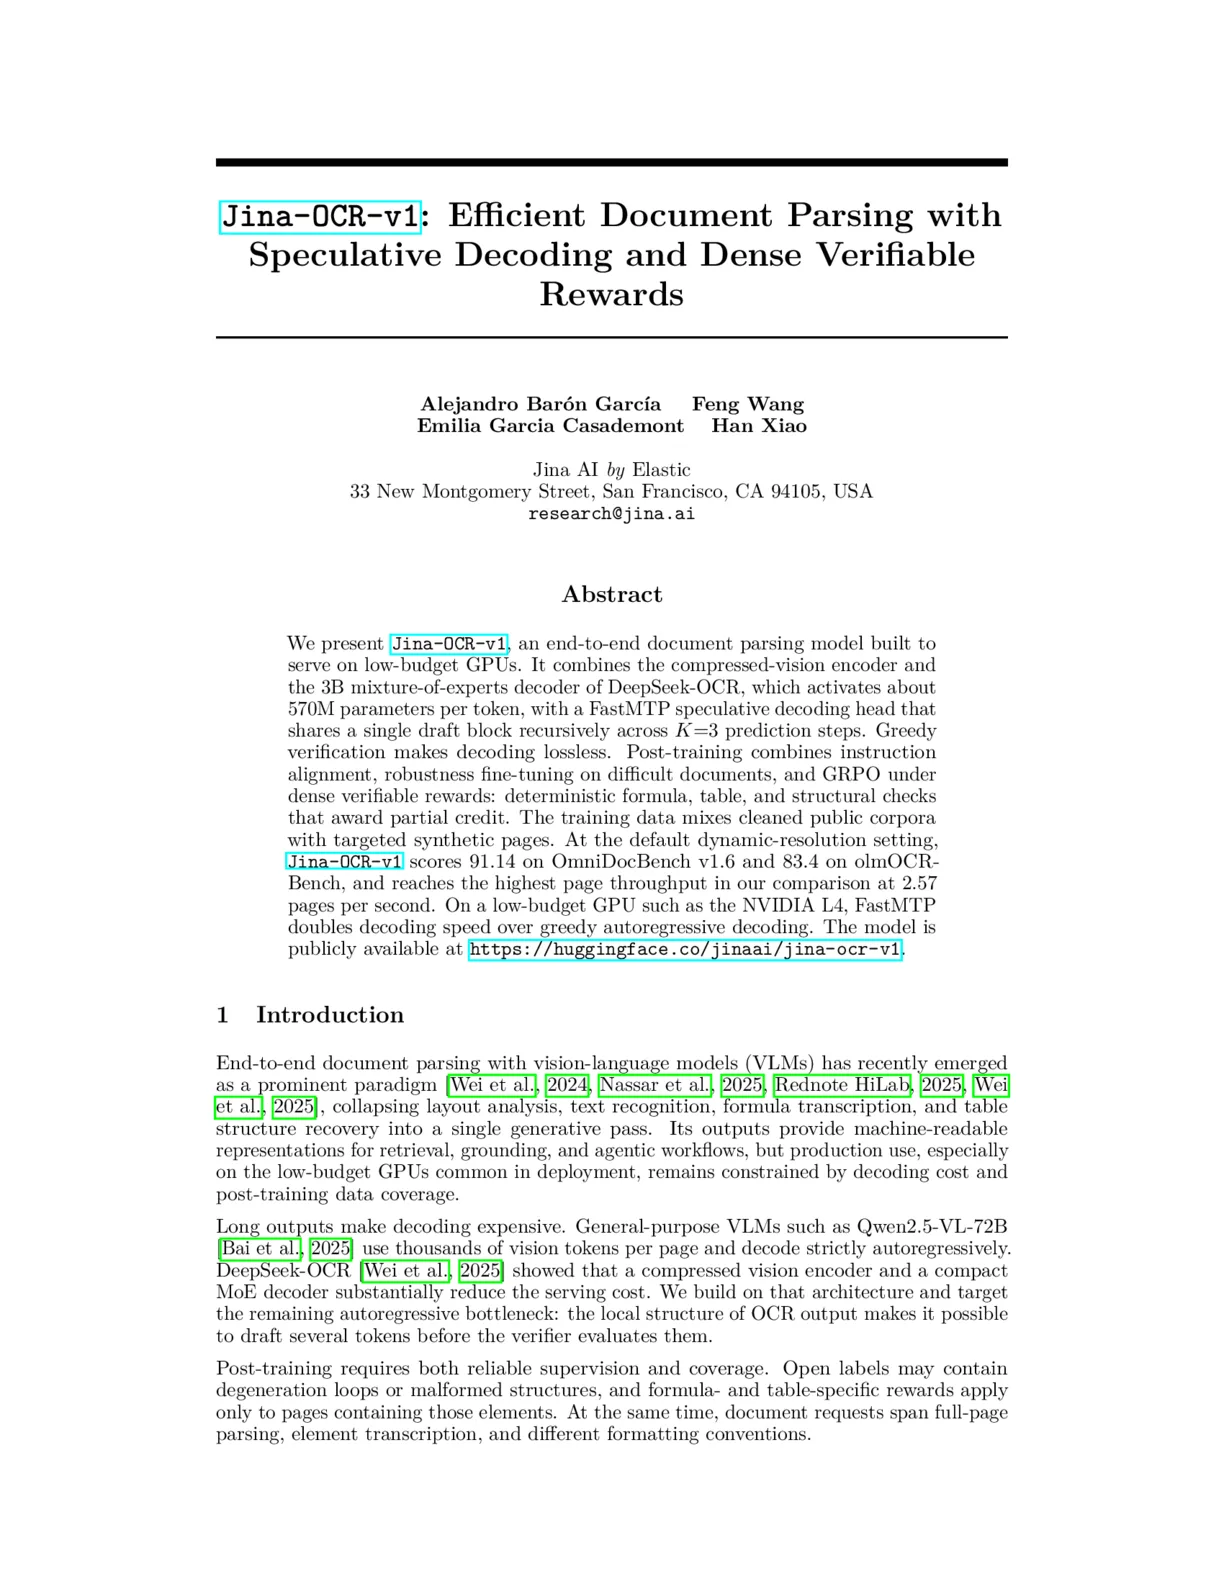
jina-ocr-v1 transforme une page en Markdown en un seul passage : texte, formules, tableaux et ordre de lecture ensemble. Ce qui le distingue, c'est là où l'effort d'ingénierie s'est porté. Le terrain de l'analyse est saturé, alors le modèle s'attaque à la partie qui coûte réellement de l'argent en production : le décodage. La sortie OCR est localement prévisible, le modèle rédige donc trois tokens en avance et laisse le vérificateur les contrôler de façon gloutonne. La vérification étant gloutonne, le résultat est sans perte, identique au bit près à un décodage autorrégressif simple, et le modèle valide jusqu'à 2,7 tokens par passage du vérificateur au lieu d'un.
Le reste découle du même objectif. C'est un mélange d'experts avec 3,4B paramètres au total mais seulement environ 570M actifs par token : le coût d'exécution est celui d'un petit modèle, la capacité ne l'est pas. Avec son réglage par défaut de résolution dynamique, il marque 91,14 sur OmniDocBench v1.6 et 83,4 sur olmOCR-Bench.
La couverture des langues est héritée du modèle de base. DeepSeek-OCR a été pré-entraîné sur 30M de pages PDF couvrant environ 100 langues, et jina-ocr-v1 conserve cet encodeur et ce décodeur, la même largeur s'applique donc à l'analyse de documents.
ReaderLM-v2 convertit le HTML déjà extrait en Markdown. jina-ocr-v1 commence une étape plus tôt et lit la page rendue elle-même.
Méthodes
L'architecture hérite du DeepEncoder et du décodeur à mélange d'experts de DeepSeek-OCR. DeepEncoder représente environ 380M paramètres et enchaîne une étape SAM de 80M, un compresseur convolutif 16x puis une étape CLIP-L de 300M, si bien qu'une page 1024x1024 ne coûte que 256 tokens visuels. Le mode de résolution dynamique Gundam ajoute 100 tokens par tuile supplémentaire, jusqu'à 1 156 tokens par page. Le décodeur est DeepSeek-3B-MoE avec 12 couches, taille cachée 1280, 64 experts routés plus 2 partagés sous routage top-6, un vocabulaire de 129 280 tokens et une limite de position de 32 768.
La vitesse de décodage vient de FastMTP, un bloc de brouillon dense unique appliqué récursivement pour K=3 étapes de prédiction au lieu de K têtes séparées. La vérification est gloutonne, ce qui rend la piste spéculative sans perte. Le texte émis est identique à ce que produirait un décodage autorrégressif simple.
Le post-entraînement comprend l'alignement d'instructions, un affinement de robustesse sur des documents difficiles et dégradés, et du GRPO à récompenses denses vérifiables, qui sont des contrôles déterministes de formules, de tableaux et de structure accordant un crédit partiel au lieu d'un simple signal de réussite/échec. Les données d'entraînement mêlent des corpus OCR publics nettoyés tels que olmOCR-mix, FinePDFs, DoclingMatrix, SynthChartNet et UniMER avec du matériau historique et dégradé tiré des journaux Europeana, des transcriptions de la Library of Congress et des dossiers de pension de la NARA, plus des pages synthétiques dédiées portant des tests unitaires de type olmOCR-Bench, pour que la récompense couvre ce qui compte.
Performance
Sur olmOCR-Bench, le modèle marque 83,4 au total. Par sous-ensemble : Base 99,9, ex æquo avec le meilleur de la comparaison, puis LongTiny 93,2, Tables 88,8, Hdr/Ftr 88,7, ArXiv 86,1, Multi-column 85,5, OldScans-Math 82,3 et OldScans 42,6. Sur OmniDocBench v1.6, il atteint 91,14 au total, avec distance d'édition du texte 0,046, CDM des formules 93,28, TEDS des tableaux 84,68, TEDS-S 89,01 et distance d'édition de l'ordre de lecture 0,142.
Le résultat d'efficacité est le point central du modèle. Mesuré sur une A100 SXM4 40GB à une concurrence de 32 sur 1 403 pages, il soutient 2,57 pages par seconde, le meilleur de la comparaison et à peu près deux fois les 1,22 d'olmOCR-2, tout en produisant 1 085 tokens de sortie par page et 2 792 tokens de sortie par seconde. Les modèles qui marquent plus haut sont bien plus lents. chandra-ocr-2 mène sur la qualité à 85,8 mais tourne à 0,38 page par seconde, et dots.mocr marque 83,9 à 0,55. Les chiffres en tokens sont compétitifs mais pas les meilleurs du lot. PaddleOCR-VL-1.6 est plus économe par page, à 1 048, et Surya OCR 2 émet plus de tokens par seconde, à 3 760.
Le décodage spéculatif est ce qui rend un GPU économique viable. Sur un NVIDIA L4 à la taille de lot 1, FastMTP relève le décodage en mode eager de 42,7 à 83,1 tokens de sortie par seconde à K=3, un gain de 1,95× à un taux d'acceptation de 57,6 %. Avec des graphes CUDA, la base est déjà de 158,3 tokens par seconde, et K=1 est le point de fonctionnement optimal, à 185,6, pour un gain de 1,17×. Ces chiffres de L4 sont mesurés à la taille de lot 1 sur un matériel différent et ne sont pas comparables aux chiffres de débit de l'A100 ci-dessus.
Conseils
Utilisez le réglage par défaut de résolution dynamique pour les documents généraux. Les scores rapportés reposent sur cette configuration. La sortie est en Markdown, si bien que les tableaux et les formules arrivent déjà structurés et n'ont pas besoin d'une étape de post-traitement séparée. Le modèle vise les GPU à petit budget. Un L4 ou équivalent suffit pour l'analyse interactive d'un seul document, et le décodage spéculatif donne le plus grand gain en mode eager : activez K=3 dans ce mode et K=1 lors de l'exécution avec des graphes CUDA. La vérification étant gloutonne, activer ou désactiver la spéculation change le débit, mais jamais le texte.
Le mieux adapté à l'ingestion massive de documents, aux pipelines PDF vers Markdown, aux archives numérisées et historiques, et à toute charge de travail où les pages par seconde par dollar comptent plus que le dernier point du score de benchmark. Les en-têtes et pieds de page sont transcrits plutôt que supprimés, ce qui est le comportement voulu pour la fidélité d'archives mais qui marque mal aux tests d'absence de texte. OldScans reste le sous-ensemble le plus faible, à 42,6, si bien que les scannés fortement dégradés méritent encore un contrôle humain.
Si votre entrée est du HTML déjà récupéré, ReaderLM-v2 est l'outil le plus économique pour la même cible Markdown. Pour la réponse aux questions visuelles sur une page plutôt que la transcription, utilisez jina-vlm. Pour la récupération sur la sortie analysée, associez-le à jina-embeddings-v4.