Embeddings
 Qwen Research License
jina-embeddings-v4
Qwen Research License GGUF
 API di Jina
 Hugging Face
 Air-gapped
Panoramica
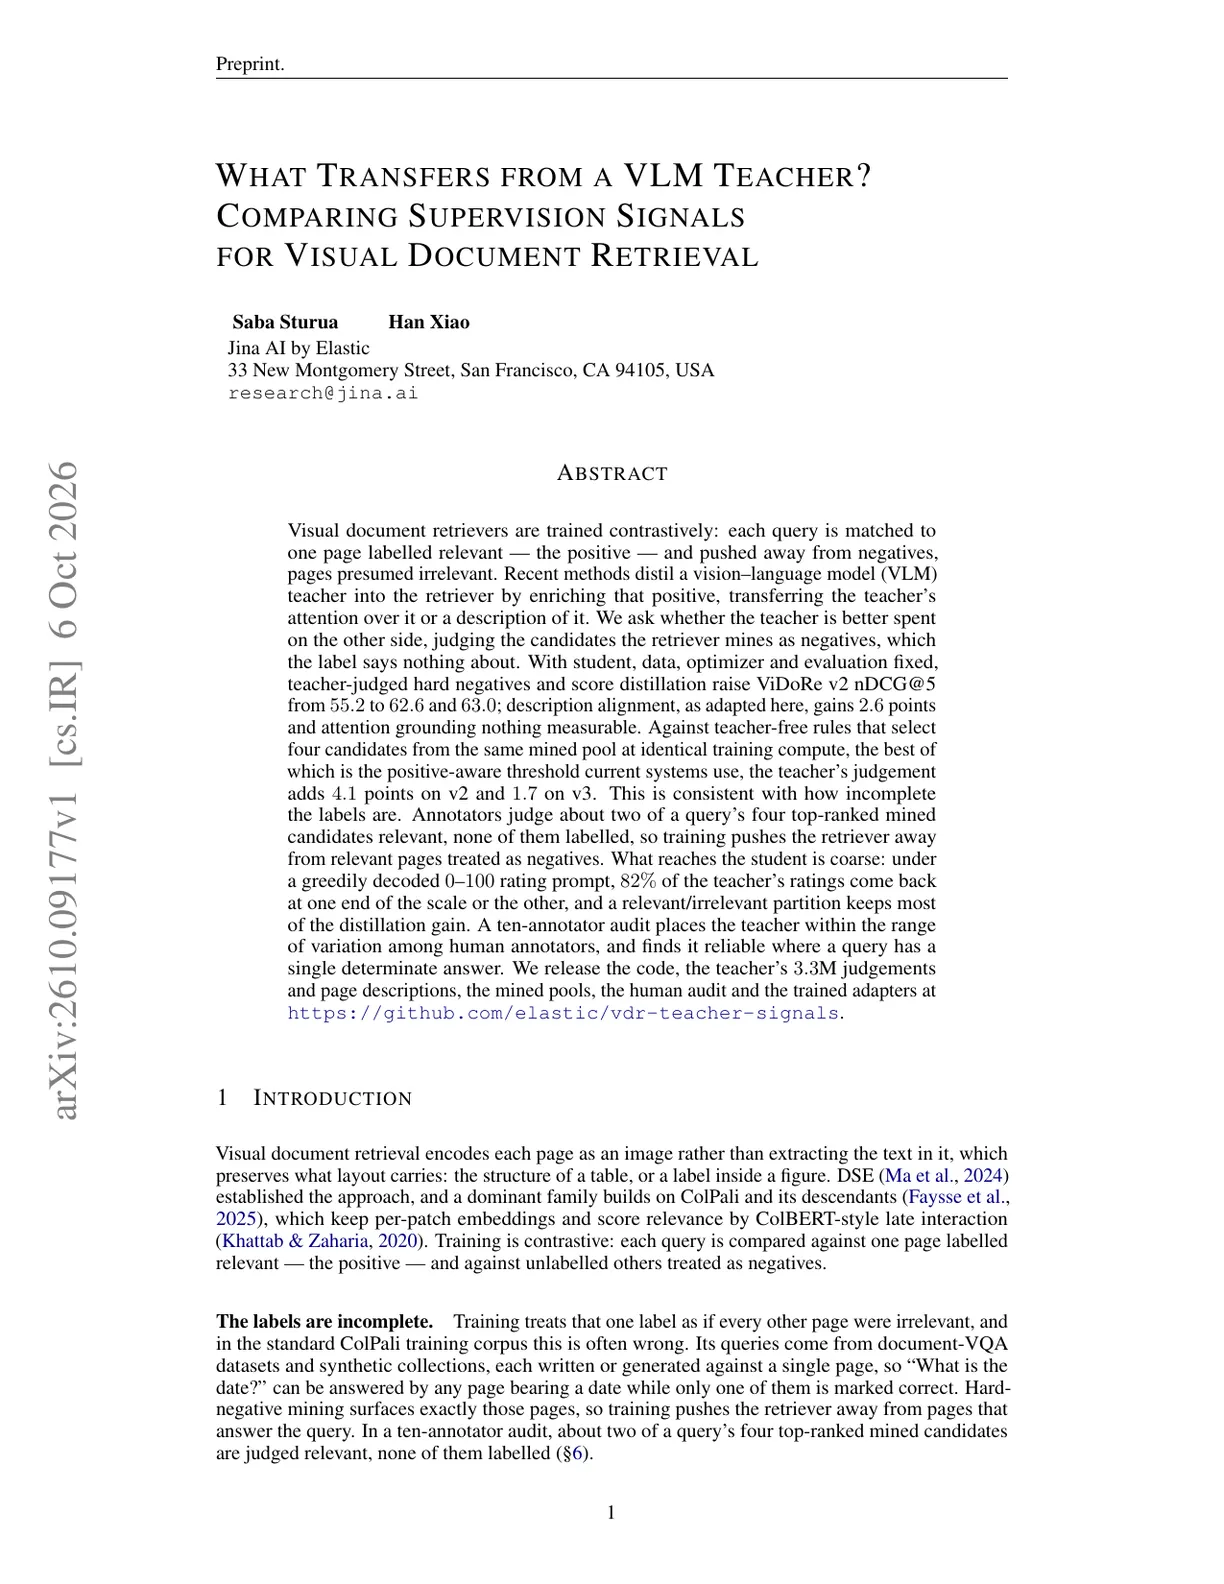
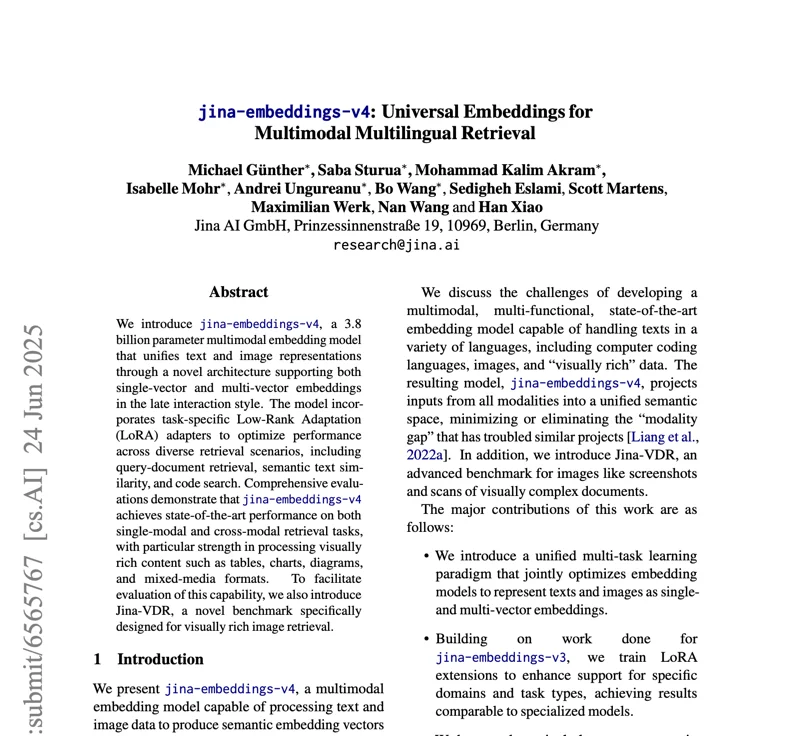
jina-embeddings-v4 è un modello di embedding multimodale da 3,8B parametri che unisce le rappresentazioni di testo e immagine in un'unica architettura. Supporta in modo unico sia la modalità di output single-vector (densa) sia quella multi-vector (interazione tardiva/stile ColBERT), permettendo ai team di mediare tra efficienza di indicizzazione e precisione di retrieval senza cambiare modello. Il modello raggiunge performance state-of-the-art sul retrieval di documenti visivamente ricchi, elaborando nativamente tabelle, grafici, diagrammi e formati multimediali misti.
Metodi
L'architettura combina un grande backbone di encoder transformer con un vision encoder basato su Qwen2.5-VL, elaborando testo (fino a 32K token) e immagini (768×28×28 patch) attraverso layer di attenzione condivisi. Tre adattatori LoRA specifici per il task (60M parametri ciascuno) specializzano il modello per: retrieval asimmetrico query-documento, similarità semantica del testo e ricerca di codice. La progettazione a doppio output è l'innovazione chiave: il modello può produrre un singolo vettore denso di 2048 dimensioni (per indicizzazione ANN rapida con troncamento Matryoshka a 128 dimensioni) o un insieme di vettori a livello di token di 128 dimensioni per lo scoring di interazione tardiva. L'addestramento ha usato un percorso di addestramento in due fasi: pre-addestramento contrastivo congiunto su coppie testo-immagine e testo-testo, seguito dall'addestramento degli adattatori LoRA specifici per il task. È supportato il late chunking per i documenti che superano la finestra di contesto di 32K token. Si applica la Qwen Research License.
Prestazioni
Su JinaVDR (Visual Document Retrieval), il modello segna 72,19 di media, contro 64,50 per ColPali-v1.2. Su ViDoRe, raggiunge 84,11 di media (90,17 in modalità multi-vector) contro 83,90 per ColPali. Il retrieval cross-modale raggiunge 84,11 sul benchmark CLIP, superando jina-clip-v2 (81,12) e nllb-clip-large-siglip (83,19). Punteggi di retrieval testuale: 55,97 su MTEB-en, 66,49 su MMTEB, 67,11 su LongEmbed (contro 55,66 per jina-embeddings-v3). La similarità semantica raggiunge 85,89 su English STS e 72,70 su STS multilingua. Il retrieval di codice segna 71,59 su CoIR. L'allineamento cross-modale raggiunge 0,71 di similarità coseno (contro 0,15 per OpenAI CLIP). La modalità multi-vector supera costantemente la modalità single-vector sui task visivamente ricchi; la modalità single-vector offre prestazioni efficienti per il retrieval testuale standard.
Buone pratiche
Scegli la modalità di output in base alla tua pipeline: single-vector per indicizzazione ANN su larga scala (troncamento Matryoshka a 128–512 dimensioni disponibile), multi-vector per il reranking dei candidati top-k su documenti visivamente ricchi. Seleziona l'adattatore LoRA tramite il parametro task dell'API: 'retrieval' per la ricerca query-documento, 'text-matching' per similarità semantica, 'code' per il retrieval del codice. Per documenti che superano 32K token, usa `late_chunking. L'overhead di 60M parametri per adattatore LoRA è trascurabile (<2% di aumento di memoria) e tutti e tre gli adattatori possono essere caricati simultaneamente. Il modello è concesso in licenza sotto Qwen Research License (solo uso non commerciale; nessuna licenza commerciale disponibile). Per i deploy di produzione, usa GPU con supporto CUDA; il modello è disponibile tramite l'API Jina e i marketplace di AWS, Azure e GCP. Per i workload solo testo, jina-embeddings-v5-text-small` offre una migliore accuratezza per parametro a una frazione del costo computazionale.