Acquisizione dati
jina-ocr-v1
 API di Jina
 Hugging Face
 arXiv
Panoramica
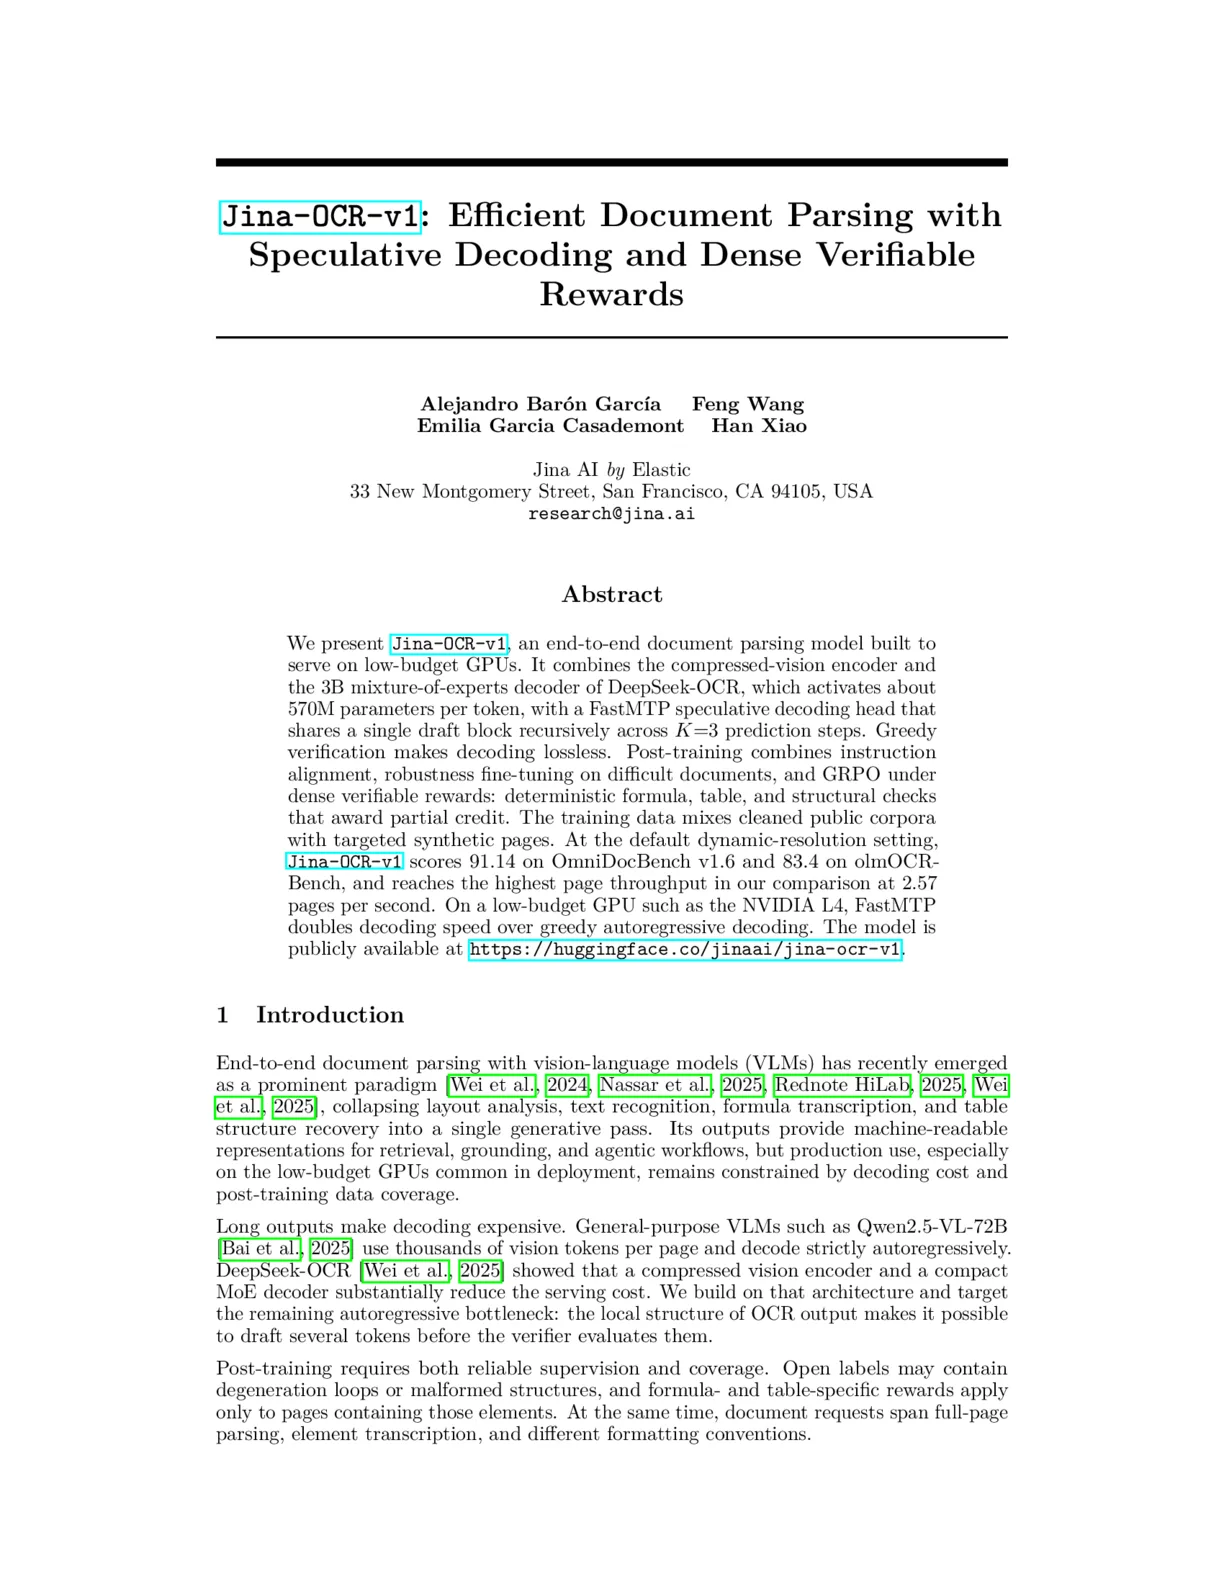
jina-ocr-v1 trasforma una pagina in Markdown in un solo passaggio: testo, formule, tabelle e ordine di lettura insieme. Ciò che lo differenzia è dove è finita l'ingegneria. La qualità di parsing è un terreno saturo, quindi il modello attacca la parte che in produzione costa davvero, cioè la decodifica. L'output OCR è localmente prevedibile, così il modello stende tre token in anticipo e lascia che il verificatore li controlli in modo glotone. Poiché la verifica è glotona, il risultato è senza perdite, identico byte per byte alla decodifica autoregressiva semplice, e il modello conferma fino a 2,7 token per passata del verificatore anziché uno.
Il resto segue dallo stesso obiettivo. È una miscela di esperti con 3,4B parametri totali ma solo circa 570M attivi per token: il costo di esecuzione è quello di un modello piccolo, la capacità non lo è. Con l'impostazione predefinita di risoluzione dinamica ottiene 91,14 su OmniDocBench v1.6 e 83,4 su olmOCR-Bench.
La copertura linguistica è ereditata dal modello base. DeepSeek-OCR è stato pre-addestrato su 30M di pagine PDF che coprono circa 100 lingue, e jina-ocr-v1 mantiene quel codificatore e quel decodificatore, quindi la stessa ampiezza vale per il parsing dei documenti.
ReaderLM-v2 converte l'HTML già estratto in Markdown. jina-ocr-v1 inizia un passo prima e legge direttamente la pagina renderizzata.
Metodi
L'architettura eredita il DeepEncoder e il decodificatore a miscela di esperti di DeepSeek-OCR. DeepEncoder ha circa 380M parametri e concatena una fase SAM da 80M, un compressore convoluzionale 16x e poi una fase CLIP-L da 300M, in modo che una pagina 1024x1024 costi solo 256 token visivi. La modalità Gundam a risoluzione dinamica aggiunge 100 token per ogni tile in più, fino a 1.156 token per pagina. Il decodificatore è DeepSeek-3B-MoE con 12 layer, hidden size 1280, 64 esperti instradati più 2 condivisi con instradamento top-6, un vocabolario di 129.280 token e un limite di posizione di 32.768.
La velocità di decodifica viene da FastMTP, un singolo blocco di bozza denso applicato ricorsivamente per K=3 passi di predizione anziché K teste separate. La verifica è glotona, il che rende il percorso speculativo senza perdite. Il testo emesso è identico a quello che produrrebbe la decodifica autoregressiva semplice.
Il post-addestramento esegue l'allineamento delle istruzioni, il fine-tuning di robustezza su documenti difficili e degradati e GRPO con ricompense dense verificabili, cioè controlli deterministici di formule, tabelle e struttura che assegnano credito parziale anziché un singolo segnale pass/fail. I dati di addestramento mescolano corpus OCR pubblici ripuliti come olmOCR-mix, FinePDFs, DoclingMatrix, SynthChartNet, UniMER con materiale storico e degradato dai giornali Europeana, dalle trascrizioni della Library of Congress e dai file di pensione della NARA, più pagine sintetiche specifiche con test unitari stile olmOCR-Bench, in modo che la ricompensa abbia copertura dove conta.
Prestazione
Sull'olmOCR-Bench il modello ottiene 83,4 complessivo. Per sottoinsieme: Base 99,9, in parità con il più alto del confronto, poi LongTiny 93,2, Tables 88,8, Hdr/Ftr 88,7, ArXiv 86,1, Multi-column 85,5, OldScans-Math 82,3 e OldScans 42,6. Su OmniDocBench v1.6 raggiunge 91,14 complessivo, con distanza di modifica del testo 0,046, CDM delle formule 93,28, TEDS delle tabelle 84,68, TEDS-S 89,01 e distanza di modifica dell'ordine di lettura 0,142.
Il risultato di efficienza è il punto centrale del modello. Misurato su una A100 SXM4 40GB con un livello di concorrenza di 32 su 1.403 pagine, mantiene 2,57 pagine al secondo, il migliore del confronto e all'incirca il doppio degli 1,22 di olmOCR-2, per 1.085 token di output per pagina e 2.792 token di output al secondo. I modelli con punteggi più alti sono molto più lenti. chandra-ocr-2 guida in qualità a 85,8 ma gira a 0,38 pagine al secondo, e dots.mocr ottiene 83,9 a 0,55. Le cifre sui token sono competitive ma non le migliori nel gruppo. PaddleOCR-VL-1.6 è più leggero per pagina a 1.048, e Surya OCR 2 emette più token al secondo a 3.760.
La decodifica speculativa è ciò che rende una GPU economica praticabile. Su un NVIDIA L4 a batch size 1, FastMTP porta la decodifica in eager mode da 42,7 a 83,1 token di output al secondo a K=3, un'accelerazione di 1,95× con un tasso di accettazione del 57,6%. Con i grafi CUDA la baseline è già a 158,3 token al secondo, e K=1 è il punto di funzionamento migliore a 185,6 per un guadagno di 1,17×. Questi numeri di L4 sono misurati a batch size 1 su hardware diverso e non sono confrontabili con le cifre di throughput A100 sopra.
Orientamento
Usa l'impostazione predefinita di risoluzione dinamica per i documenti generici. È la configurazione sulla quale si basano i punteggi riportati. L'output è Markdown, quindi tabelle e formule arrivano già strutturate e non richiedono un passo di post-elaborazione separato. Il modello punta a GPU a basso budget. Una L4 o simile basta per il parsing interattivo di un singolo documento, e la decodifica speculativa dà il guadagno maggiore in eager mode, quindi abilita K=3 in quella modalità e K=1 quando esegui con i grafi CUDA. Poiché la verifica è glotona, attivare o disattivare la speculazione cambia il throughput ma mai il testo.
Più adatto all'ingestione massiva di documenti, alle pipeline da PDF a Markdown, agli archivi scansionati e storici e a qualsiasi carico di lavoro in cui le pagine al secondo per dollaro contano più dell'ultimo punto di punteggio del benchmark. Header e footer sono trascritti piuttosto che rimossi, il che è il comportamento desiderato per la fedeltà d'archivio ma ottiene un punteggio basso nei test di assenza di testo. OldScans resta il sottoinsieme più debole a 42,6, quindi le scansioni molto degradate richiedono ancora un controllo umano.
Se il tuo input è HTML già scaricato, ReaderLM-v2 è lo strumento più economico per lo stesso obiettivo Markdown. Per la risposta visiva alle domande su una pagina anziché la trascrizione, usa jina-vlm. Per il recupero sull'output analizzato, abbinalo a jina-embeddings-v4.