I/O 図 1

テキスト

jina-clip-v2

ベクトル

I/O 図 2

画像

jina-clip-v2

ベクトル

パレートフロント
100M300M1B3.0B707580859095CLIP-convnext_base_w-la…CLIP-ViT-B-16-laion2BCLIP-ViT-bigG-14-laion2BCLIP-ViT-g-14-laion2BCLIPA-v2 ViT-bigG/14-336DataComp-1B CLIP ViT-B/…DFN2B-CLIP-ViT-B-16DFN5B-CLIP-ViT-H-14-378EVA-CLIP ViT-B/16EVA01-CLIP-g-14-plusEVA02-CLIP-E-14EVA02-CLIP-E-14-plusEVA02-CLIP-L-14jina-clip-v1LongCLIP ViT-B/16NLLB-CLIP-baseNLLB-CLIP-largenllb-siglip-basenllb-siglip-largeOpenAI CLIP RN101OpenAI CLIP RN50OpenAI CLIP RN50x64OpenAI CLIP ViT-B/16OpenAI CLIP ViT-L/14-336siglip-base-patch16-224siglip-base-patch16-512siglip-large-patch16-256siglip-large-patch16-384siglip-so400m-patch14-3…XLM-Roberta-Base-ViT-B-…jina-clip-v2パラメータ数(対数)i2t-recall@5
このモデル
フロント上
Jina AI
その他
CLIP Benchmark
89.73
パラメータ
865M
スコア順位
34 / 56
パレートフロント
フロント外
値の分布
AUC 0.8383
コーパス
翻訳ペア
ドキュメント検索
画像 / バナー
画像 / ロゴ
タスク
default
retrieval.query
0.6040.000.200.400.60
関連20.2%
ハードネガティブ3.6%
無関係0.8%
推奨しきい値
FPR 0.1 · 0.508
FPR 0.01 · 0.604
FPR 0.001 · 0.668
FPR 0.0001 · 0.714
バランス · 0.403
AUC
0.8383
ノイズ上限
0.666
再現率の急落点
0.224
測定ペア数
119 / 11k
ベクトル成分
-0.43-0.070.29
σ 0.0313 · 244k 個の値
埋め込みの幾何
01024
次元ごとの平均。カーソルを合わせると範囲を表示
ノイズ下限
0.420
実効次元数
52 / 1024
言語ペア
de-rude-zhen-deen-jaen-koen-ruen-zhja-ko
ペア間のしきい値のばらつき:0.064
比較するモデルを選択
論文 (2)

概要

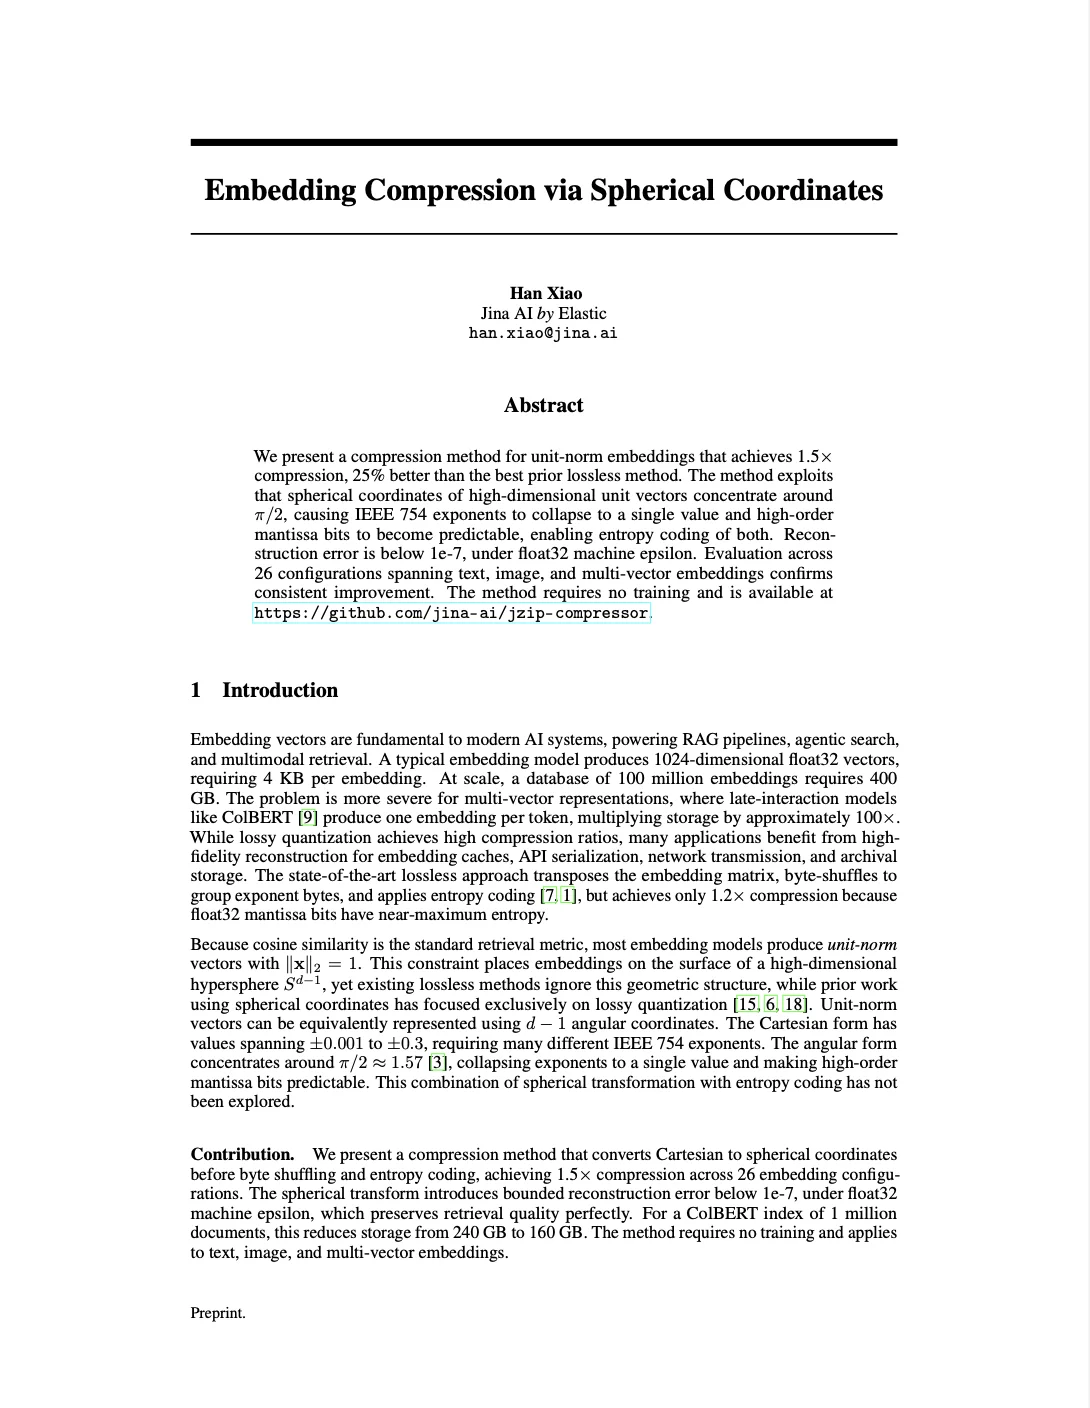
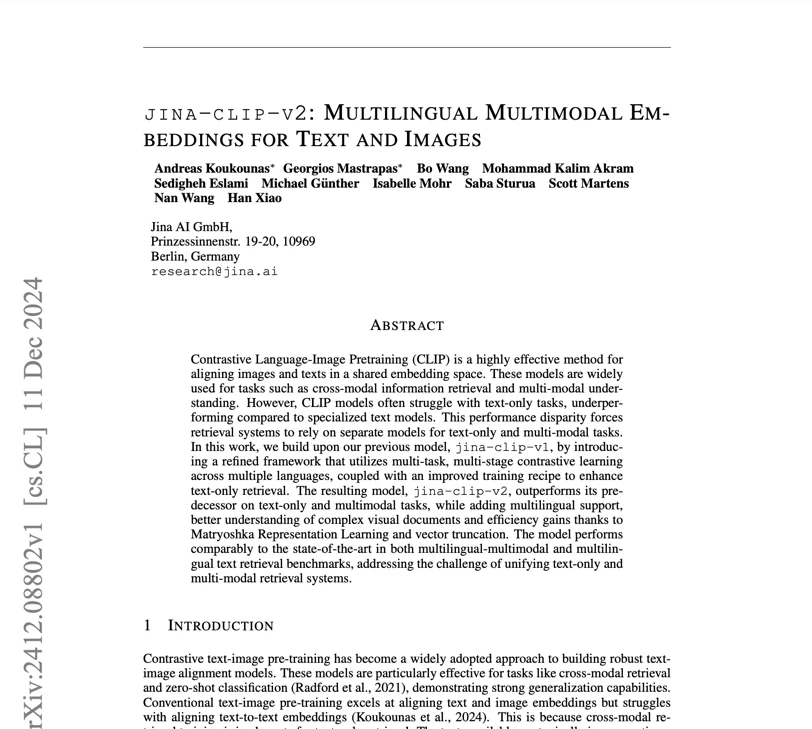
jina-clip-v2 は 865M パラメータの多言語マルチモーダル埋め込みモデルで、89 言語と 512×512 画像入力をサポートします。jina-clip-v1 を画像とテキストのクロスリンガルアラインメント、次元削減のための Matryoshka 表現学習(1024→64)、視覚情報の多い文書での性能向上で拡張しています。テキスト単独および単一モダリティの性能を高く保ちながら、クロスリンガル画像検索で SOTA を達成します。

手法

モデルはデュアルエンコーダアーキテクチャを採用し、Jina XLM-RoBERTa テキストエンコーダ(561M パラメータ、89 言語、696,320 トークンコンテキスト)と EVA02-L14 ビジョンエンコーダ(304M パラメータ、512×512 ピクセル入力)を組み合わせます。学習はマルチタスク・マルチステージの対照学習パラダイムを使用します:モデルはテキストペア、テキストトリプレット、画像-テキストペアで同時に学習され、テキスト単独タスクとクロスモーダルタスクの両方をサポートします。学習データセットは、英語以外の 29 言語(ヒンディー語、中国語、ドイツ語、フランス語を含む)の多言語テキストと、視覚情報の多い文書の画像を含めるよう拡張されました。Matryoshka 表現学習により、性能の 99% 以上を維持しながら埋め込み次元を 1024 から 64 次元まで削減できます。モデルは最終埋め込みに Last-Token-Pooling を使用します。

パフォーマンス

モデルは Flickr30k の画像からテキスト検索で 98.0% の正解率を達成し、jina-clip-v1 と NLLB-CLIP-SigLIP の両方を上回っています。多言語シナリオでは、クロスリンガル画像検索で NLLB-CLIP-SigLIP に対して最大 4% の改善を示します。埋め込み圧縮は非常に効果的で、次元を 75% 削減(1024→256)しても、テキスト・画像・クロスモーダルの各タスクで性能の 99% 以上を維持します。Multilingual MTEB では、検索で 69.86%、意味的類似度で 67.77% を達成し、特化したテキスト埋め込みモデルと競争力のある性能です。89 言語サポートと視覚情報の多い文書処理により、グローバルな Eコマースやコンテンツ管理に特に適しています。

ベストプラクティス

処理前に画像を 512×512 ピクセルにリサイズしてください — 大きな画像は自動的にタイル化され、トークン使用量と処理時間が増えます。モデルは 89 言語で画像を説明文とマッチさせることに長けており、グローバルな Eコマースの商品検索、コンテンツレコメンド、多言語ビジュアル検索に最適です。抽象的な概念や極めて専門的なドメインコンテンツは不得意な場合があります。Matryoshka 次元削減を使用する場合、64 次元の埋め込みでもインデックス用に強い性能を維持します。重要なアプリケーションのリランキングには 512 次元以上の次元を使用してください。モデルは CUDA 対応ハードウェアが必要です。テキスト専用ワークロードでは、jina-embeddings-v5-text-small の方がパラメータあたりの精度が高いです。コード検索には jina-code-embeddings-1.5b を使用してください。Jina API、AWS、Azure、GCP マーケットプレイスで利用可能です。

このモデルについて言及しているブログ
7月 31, 2025 • 12 分で読めます
画像解像度がビジュアルドキュメント検索に与える影響
画像の解像度は、視覚的に豊富なドキュメントの 向量模型 を作成する上で非常に重要です。解像度が小さすぎると、モデルは重要な詳細を見逃し、大きすぎると、パーツを関連付けることができません。
7月 25, 2025 • 8 分で読めます
JinaVDR:20言語で95のタスクを網羅した新しいVisual Document Retrievalベンチマーク
JinaVDRは、視覚的なドキュメント検索のための新しいベンチマークであり、20言語にわたる95のタスクを網羅しています。近日中にMTEBで公開予定です。
6月 25, 2025 • 12 分で読めます
Jina Embeddings v4:マルチモーダル多言語検索のためのユニバーサルなベクトルモデル (Embeddings)
Jina 向量模型 (Embeddings) v4 は、38 億のパラメータを持つユニバーサルな 向量模型 (Embedding) モデルであり、マルチモーダルおよび多言語の検索に対応し、シングルベクトルとマルチベクトルの 向量模型 (Embedding) 出力をサポートします。
5月 28, 2025 • 4 分で読めます
相関関係:GUI でのベクトルモデル (Embeddings) のバイブテスト
MTEBを真剣に考えているのと同じくらい、雰囲気テストも大好きです。Correlationsは、DeepSearchでの引用の検証、遅延チャンクのデバッグ、および埋め込み (Embeddings) の雰囲気テストに使用するシンプルなGUIです。今回、オープンソース化されました。
5月 25, 2025 • 21 分で読めます
ICLR2025で学んだこと
ICLR 2025で最も興味深い論文をいくつか集めました。TIPS、FlexPrefill、ゼロショット重排器 (Zero-Shot Rerankers)、SVD-LLM、Hymbaなどが含まれています。