Reader
jina-ocr-v1
 Jina API
 Hugging Face
 macOS
개요
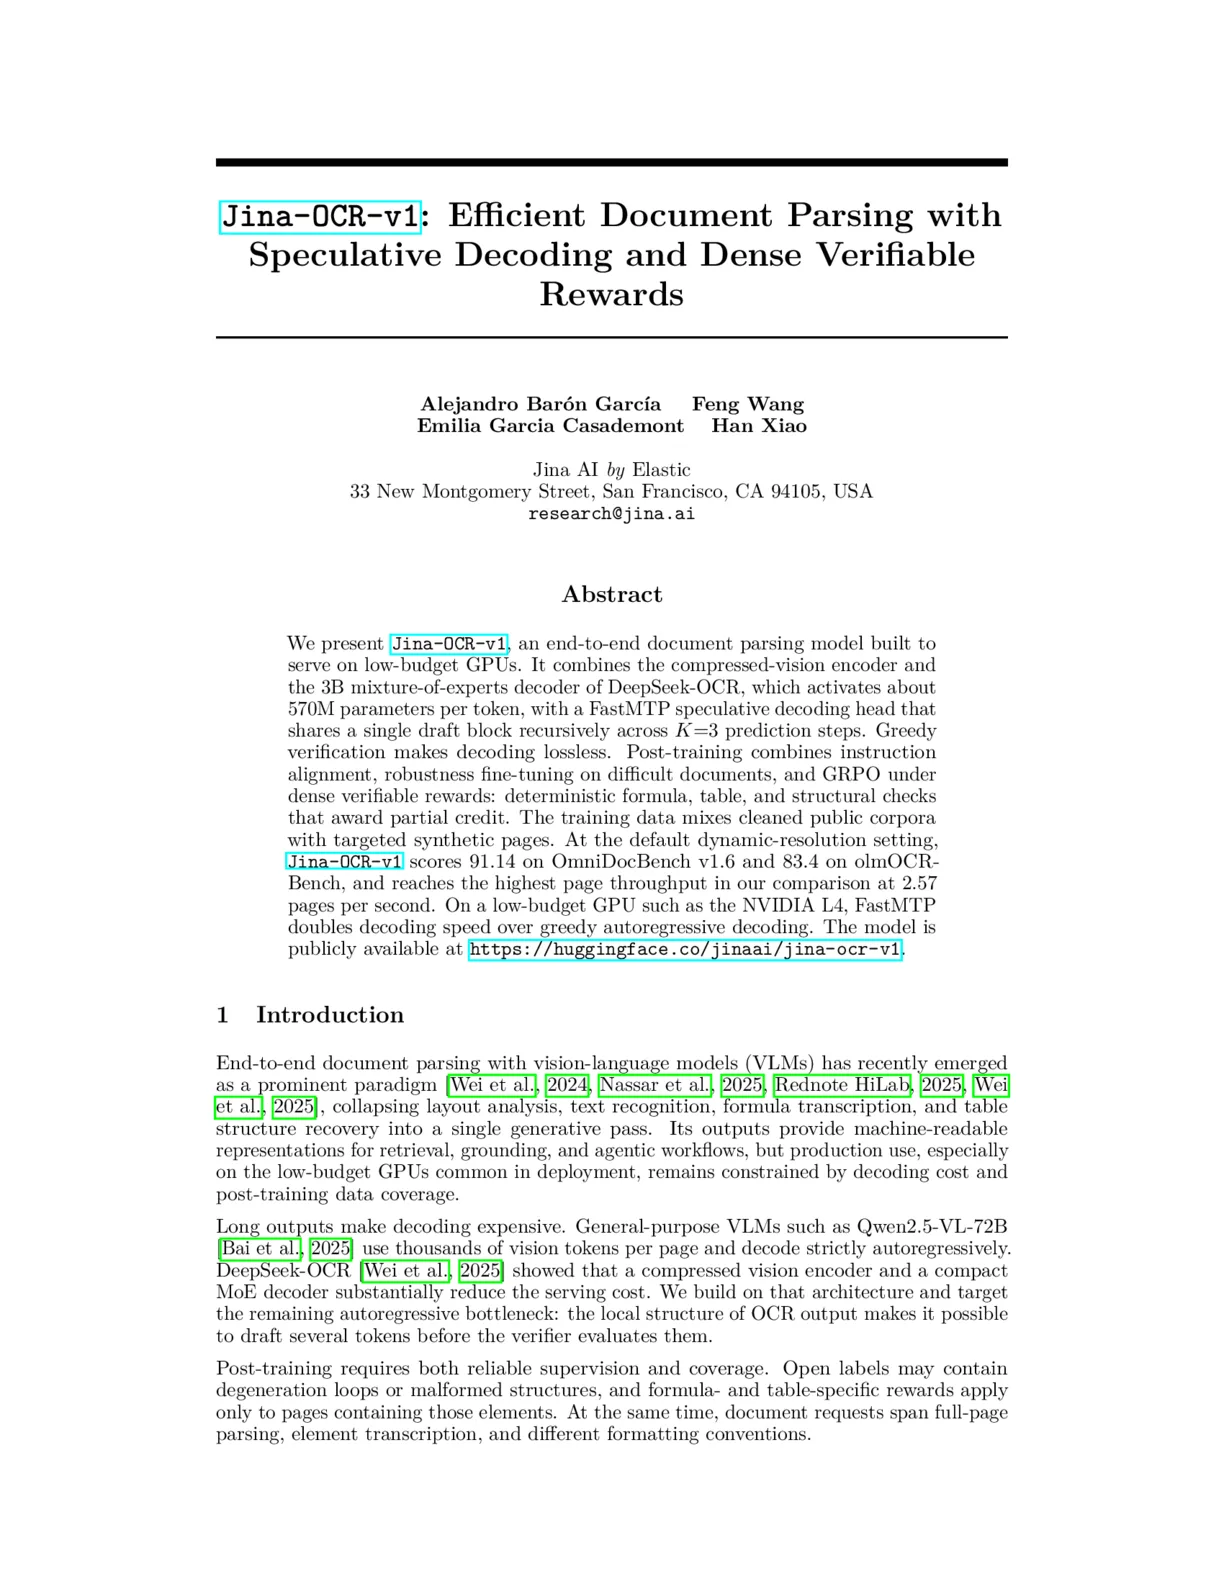
jina-ocr-v1은 단일 패스로 페이지를 Markdown으로 변환합니다: 텍스트, 수식, 표, 읽기 순서를 한 번에. 차이를 만드는 것은 엔지니어링이 어디에 쓰였느냐입니다. 파싱 품질은 경쟁이 치열한 영역이므로, 모델은 프로덕션에서 실제로 비용이 발생하는 부분, 즉 디코딩을 공략합니다. OCR 출력은 국소적으로 예측 가능하므로 모델은 3개 토큰 앞을 미리 초안으로 제시하고, 검증기가 이를 탐욕적으로 확인하도록 둡니다. 검증이 탐욕적이므로 결과는 무손실이며 일반 자기 회귀 디코딩과 바이트 단위로 동일합니다. 모델은 검증 패스당 1개가 아니라 평균 2.7개 토큰을 확정합니다.
나머지는 같은 목표에서 나옵니다. 총 파라미터 3.4B의 전문가 혼합 모델이지만 토큰당 활성 파라미터는 약 570M뿐이므로, 실행 비용은 작은 모델 수준이면서 용량은 그렇지 않습니다. 기본 동적 해상도 설정에서 OmniDocBench v1.6은 91.14, olmOCR-Bench는 83.4를 기록합니다.
언어 커버리지는 베이스 모델에서 상속됩니다. DeepSeek-OCR은 약 100개 언어에 걸친 30M PDF 페이지로 사전학습되었고, jina-ocr-v1은 그 인코더와 디코더를 그대로 유지하므로 문서 파싱에도 같은 폭의 언어 지원이 적용됩니다.
ReaderLM-v2는 이미 추출된 HTML을 Markdown으로 변환합니다. jina-ocr-v1은 한 단계 먼저 시작해 렌더링된 페이지 자체를 읽습니다.
방법
아키텍처는 DeepSeek-OCR의 DeepEncoder와 전문가 혼합 디코더를 물려받습니다. DeepEncoder는 약 380M 파라미터로, 80M SAM 단계에 16배 컨볼루션 압축기와 300M CLIP-L 단계를 이어 붙이므로 1024×1024 페이지가 256개의 시각 토큰만 소모합니다. Gundam 동적 해상도 모드는 타일이 하나 늘 때마다 100개 토큰을 더해 페이지당 최대 1,156개 토큰까지 늘어납니다. 디코더는 레이어 12개, 은닉 크기 1280, 라우팅된 전문가 64개 + 공유 전문가 2개(top-6 라우팅), 129,280토큰 어휘, 32,768 위치 한도를 가진 DeepSeek-3B-MoE입니다.
디코딩 속도는 FastMTP에서 나옵니다. K개의 별도 헤드 대신 단일 밀집 드래프트 블록을 K=3 예측 스텝에 재귀적으로 적용합니다. 검증이 탐욕적이므로 투기적 경로는 무손실입니다. 출력되는 텍스트는 일반 자기 회귀 디코딩이 만드는 것과 동일합니다.
후학습에서는 지시 정렬, 어렵고 열화된 문서에 대한 강건성 미세 조정, GRPO를 수행합니다. GRPO는 조밀한 검증 가능 보상을 쓰는데, 이는 패스/페일 단일 신호 대신 부분 점수를 주는 결정론적 수식·표·구조 검사입니다. 학습 데이터는 olmOCR-mix, FinePDFs, DoclingMatrix, SynthChartNet, UniMER 같은 정제된 공개 OCR 코퍼스에 Europeana 신문, Library of Congress 전사, NARA 연금 문서 같은 역사적·열화 자료를 더하고, 중요한 지점에서 보상이 커버리지를 갖도록 olmOCR-Bench 스타일 단위 테스트를 담은 표적 합성 페이지를 섞습니다.
성능
olmOCR-Bench에서 모델은 전체 83.4를 기록합니다. 서브셋별로는 Base 99.9(비교군 내 공동 1위), 이어 LongTiny 93.2, Tables 88.8, Hdr/Ftr 88.7, ArXiv 86.1, Multi-column 85.5, OldScans-Math 82.3, OldScans 42.6입니다. OmniDocBench v1.6에서는 전체 91.14로, 텍스트 편집 거리 0.046, 수식 CDM 93.28, 표 TEDS 84.68, TEDS-S 89.01, 읽기 순서 편집 거리 0.142입니다.
효율 결과가 이 모델의 핵심입니다. A100 SXM4 40GB 1대에서 동시성 32, 1,403개 페이지로 측정했을 때 2.57페이지/초를 유지하며, 비교군에서 최고이고 olmOCR-2의 1.22 대비 약 2배입니다. 이때 페이지당 출력 토큰 1,085개, 초당 2,792개를 씁니다. 더 높은 점수를 내는 모델은 훨씬 느립니다. Infinity-Parser2-Pro는 87.6으로 품질에서 앞서지만, 자체 배치 H100 구성(TP=2, C=8, doc2json)에서 페이지당 2.13초가 걸리고, Infinity-Parser2-Flash는 86.0으로 페이지당 0.95초입니다. 이 모델 자체의 비교표 내에서는 chandra-ocr-2가 85.8로 품질에서 앞서지만 0.38페이지/초이며, dots.mocr은 0.55페이지/초로 83.9입니다. 토큰 수치는 경쟁력이 있지만 풀에서 최고는 아닙니다. PaddleOCR-VL-1.6은 페이지당 1,048으로 더 경량이고, Surya OCR 2는 초당 3,760으로 더 많은 토큰을 냅니다.
투기적 디코딩이 저렴한 GPU를 실행 가능하게 만듭니다. NVIDIA L4에서 배치 크기 1일 때, FastMTP는 K=3에서 eager 모드 디코딩을 42.7에서 83.1 출력 토큰/초로 끌어올려, 수용률 57.6%에서 1.95배 속도 향상입니다. CUDA 그래프를 쓰면 베이스라인이 이미 158.3 토큰/초이며, 최적 동작점은 185.6의 K=1로 1.17배 향상입니다. 이 L4 수치는 다른 하드웨어에서 배치 크기 1로 측정된 것이므로, 위의 A100 처리량 수치와 비교할 수 없습니다.
모범 사례
일반 문서에는 기본 동적 해상도 설정을 사용하세요. 이 설정이 보고된 점수를 낸 구성입니다. 출력은 Markdown이므로 표와 수식이 이미 구조화된 상태로 나오며, 별도 후처리가 필요 없습니다. 모델은 저예산 GPU를 겨냥합니다. 단일 문서를 대화형으로 파싱하는 데는 L4나 동급이면 충분하고, 투기적 디코딩은 eager 모드에서 가장 큰 이득을 주므로 eager 모드에서는 K=3을, CUDA 그래프와 함께 실행할 때는 K=1을 켜세요. 검증이 탐욕적이므로 투기적 디코딩을 켜든 끄든 처리량만 달라지고 텍스트는 변하지 않습니다.
대량 문서 수집, PDF를 Markdown으로 바꾸는 파이프라인, 스캔본과 역사 아카이브, 그리고 초당 페이지 수를 달러로 나눈 효율이 벤치마크 마지막 1점보다 중요한 모든 워크로드에 가장 적합합니다. 헤더와 푸터는 전사하지 않고 버립니다. Hdr/Ftr 서브셋은 텍스트 부재를 확인하는 테스트로 생략에 점수를 주며, 모델은 여기서 88.7점을 얻습니다. 따라서 러닝 헤더와 페이지 번호는 출력에 나타나지 않습니다. OldScans는 여전히 가장 약한 서브셋(42.6)이므로 심하게 열화된 스캔본은 사람이 확인하는 것이 좋습니다.
입력이 이미 가져온 HTML이라면 같은 Markdown을 얻는 데 ReaderLM-v2가 더 저렴한 도구입니다. 전사가 아니라 페이지에 대한 시각 질의응답에는 jina-vlm을, 파싱 결과에 대한 검색에는 jina-embeddings-v4를 함께 쓰세요.