Эмбеддинги
jina-clip-v2
 Elastic Inference Service
 Jina API
 AWS SageMaker
 Microsoft Azure
 Google Cloud
 Hugging Face
 Air-gapped
Обзор
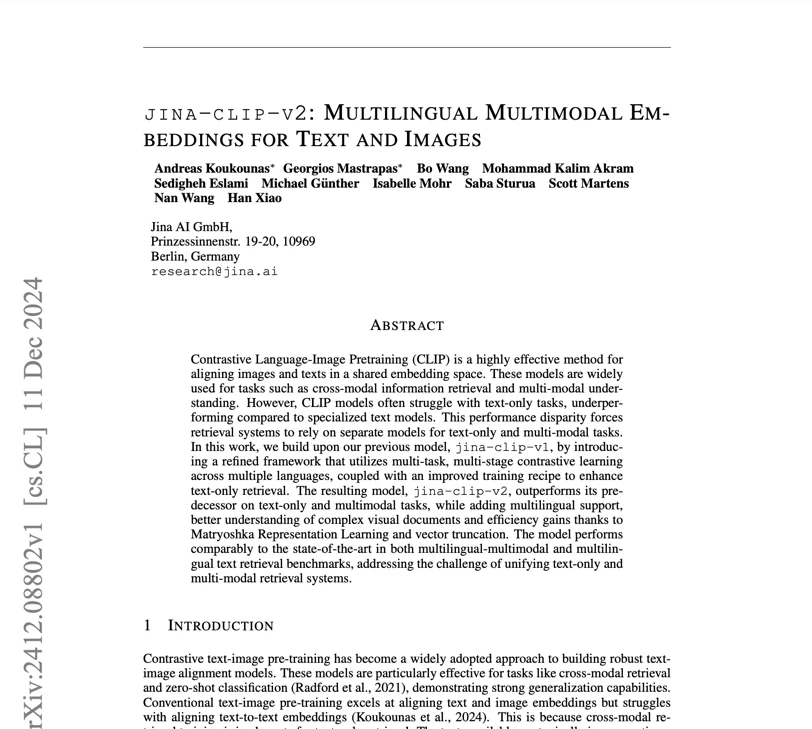
jina-clip-v2 — мультиязычная мультимодальная эмбеддинг-модель на 865M параметров с поддержкой 89 языков и входных изображений 512×512. Она расширяет jina-clip-v1 за счёт кросс-язычного согласования «изображение-текст», обучения представлений Matryoshka для сокращения размерности (1024→64) и улучшенных результатов на визуально насыщенных документах. Достигает передовых результатов в кросс-язычном поиске изображений, сохраняя сильные показатели в поиске только по тексту и на одномодальных задачах.
Методы
Модель использует архитектуру с двойным энкодером, сочетающую текстовый энкодер Jina XLM-RoBERTa (561M параметров, 89 языков, контекст 696 320 токенов) и визуальный энкодер EVA02-L14 (304M параметров, вход 512×512 пикселей). Обучение использует мультизадачный многостадийный контрастивный подход: модель обучается одновременно на парах текста, тройках текста и парах «изображение-текст», поддерживая задачи как только по тексту, так и кросс-модальные. Набор данных обучения был расширен, включая мультиязычные тексты на 29 неанглийских языках (в том числе хинди, китайский, немецкий, французский) и изображения визуально насыщенных документов. Обучение представлений Matryoshka позволяет сократить размерность эмбеддингов с 1024 до 64 измерений, сохраняя более 99% качества. Модель использует Last-Token-Pooling для финального эмбеддинга.
Производительность
Модель достигает точности 98,0% в поиске «изображение в текст» на Flickr30k, превосходя и jina-clip-v1, и NLLB-CLIP-SigLIP. В мультиязычных сценариях она показывает улучшение до 4% по сравнению с NLLB-CLIP-SigLIP в кросс-язычном поиске изображений. Сжатие эмбеддингов необычайно эффективно: сокращение размерности на 75% (1024→256) всё ещё сохраняет более 99% качества во всех задачах — тексте, изображениях и кросс-модальных. На Multilingual MTEB модель достигает 69,86% в поиске и 67,77% в семантическом сходстве, показывая результаты, конкурентоспособные со специализированными текстовыми эмбеддинг-моделями. Поддержка 89 языков и работа с визуально насыщенными документами делают её особенно подходящей для глобального e-commerce и управления контентом.
Рекомендации
Перед обработкой уменьшайте изображения до 512×512 пикселей — более крупные изображения автоматически разбиваются на тайлы, что увеличивает расход токенов и время обработки. Модель отлично сопоставляет изображения с описательным текстом на 89 языках, что делает её идеальной для глобального поиска товаров в e-commerce, рекомендации контента и мультиязычного визуального поиска. Она может испытывать трудности с абстрактными концепциями или высокоспециализированным контентом. При использовании сокращения размерности Matryoshka 64-мерные эмбеддинги сохраняют сильное качество для индексации; для реранжирования критически важных приложений используйте 512+ измерений. Модели требуется CUDA-совместимое оборудование. Для задач только по тексту jina-embeddings-v5-text-small даёт лучшее качество на параметр. Для поиска кода используйте jina-code-embeddings-1.5b. Доступна через Jina API и маркетплейсы AWS, Azure и GCP.