


 Эмбеддинги
 Лицензия Apache 2.0
jina-embeddings-v2-base-de
Apache-2.0 Jina API
 AWS SageMaker
 Microsoft Azure
 Hugging Face
 Air-gapped
 arXiv
Обзор
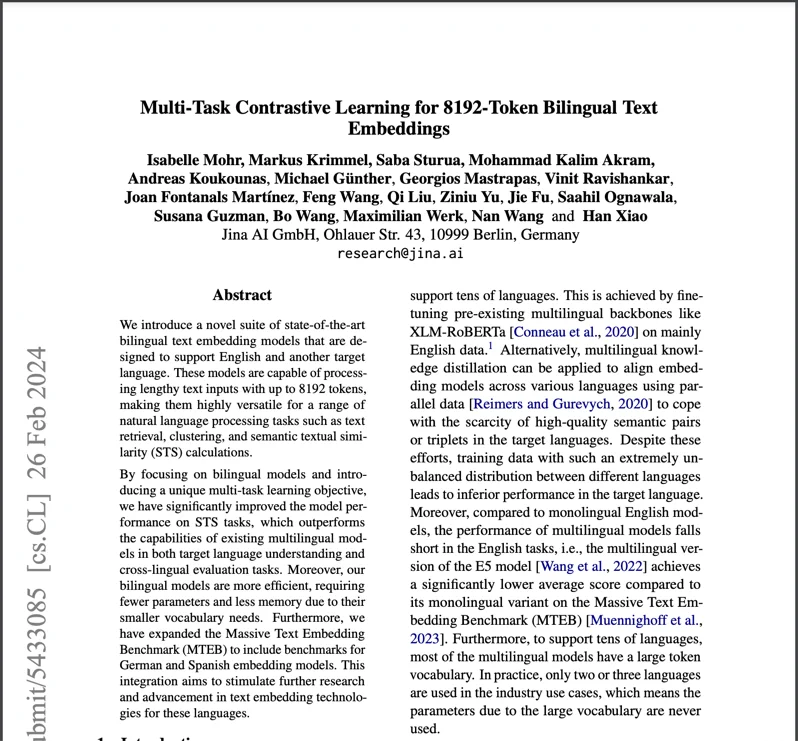
jina-embeddings-v2-base-de — двуязычная эмбеддинг-модель текста на 161M параметров, покрывающая немецкий и английский, с окном контекста в 8 192 токенов. Она отображает семантически эквивалентный контент на обоих языках в то же самое 768-мерное пространство эмбеддингов, обеспечивая межъязыковый поиск без перевода. Модель была одной из первых open-source двуязычных эмбеддинг-моделей, объединивших поддержку длинного контекста со сбалансированным качеством на обоих языках.
Методы
Модель построена на backbone BERT с симметричным двунаправленным позиционным кодированием ALiBi и обрабатывает и немецкий, и английский через единую архитектуру на 161M параметров, которая формирует 768-мерные эмбеддинги. Обучение включало три этапа: (1) мультиязычное предобучение на параллельных корпусах немецко-английских текстов, (2) контрастивное дообучение на курированных парах предложений с трудными негативами и (3) межъязыковое обучение выравниванию, чтобы гарантировать, что семантически эквивалентные тексты на немецком и английском отображаются в соседние области пространства эмбеддингов. Ключевым решением при разработке была целевая функция минимизации смещения, которая противодействует склонности мультиязычных моделей отдавать предпочтение английским грамматическим структурам — задокументированная проблема ранних мультиязычных эмбеддингов. Окно в 8 192 токенов обеспечивается ALiBi, что позволяет обрабатывать целые документы на обоих языках без усечения.
Производительность
Модель превзошла E5-base от Microsoft при сопоставимом размере и достигла уровня E5-large, несмотря на то что была примерно вдвое меньше. На WikiCLIR (поиск с английского на немецкий), STS17/STS22 (двунаправленная семантическая близость) и BUCC (двуязычное выравнивание текста) она стабильно превосходила модели того же или большего размера. Размер 322 МБ позволял развёртывание на стандартном оборудовании. В 2026 году jina-embeddings-v5-text-small вытесняет эту модель для большинства применений, предлагая контекст 32K, 89 языков и task-специфичные LoRA-адаптеры. Модель v2-base-de остаётся полезной для немецко-английских двуязычных конвейеров, где контекста в 8K достаточно.
Рекомендации
Оптимальна для немецко-английского двуязычного поиска: поиск товаров, справочная документация и управление контентом, где запросы и документы могут быть на разных языках. Для документов свыше 8 192 токенов используйте семантический чанкинг или параметр `late_chunking через API Jina. Модель интегрируется с Qdrant, Weaviate, MongoDB и Milvus. Для новых мультиязычных проектов, охватывающих более двух языков, предпочитайте jina-embeddings-v5-text-small` (89 языков, контекст 32K, LoRA-адаптеры). Для продакшена рекомендуется GPU с поддержкой CUDA.


