


 Эмбеддинги
 Лицензия Apache 2.0
jina-embeddings-v2-base-en
Apache-2.0 Jina API
 AWS SageMaker
 Microsoft Azure
 Hugging Face
 Air-gapped
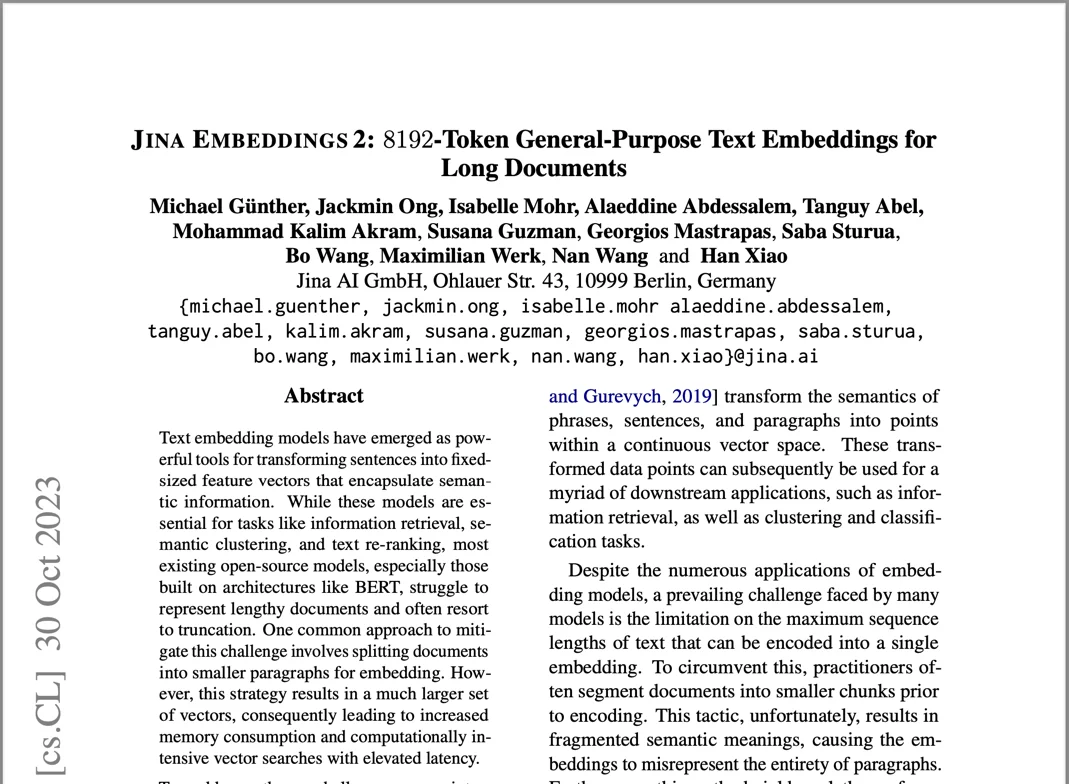
 arXiv
Обзор
jina-embeddings-v2-base-en — английская эмбеддинг-модель текста на 137M параметров с окном контекста в 8 192 токенов — в 16 раз больше стандартного лимита в 512 токенов её эпохи. Построенная на backbone BERT-small с симметричным двунаправленным ALiBi (Attention with Linear Biases), она стала первой open-source эмбеддинг-моделью Jina, нативно обрабатывавшей длинные документы без усечения и чанкинга. Она производит 768-мерные векторы и остаётся надёжным выбором для поиска только на английском, когда мультиязычные или длинноконтекстные возможности v3/v5 не нужны.
Методы
Архитектура сочетает трансформер BERT-small (12 слоёв, 12 головок внимания, 768 скрытых измерений) с симметричным двунаправленным ALiBi позиционным кодированием. ALiBi заменяет выученные позиционные эмбеддинги линейно убывающим смещением внимания, позволяя модели экстраполировать далеко за её длину обучения в 512 токенов — до 8 192 токенов — без потери качества. Обучение следовало двухэтапному конвейеру: предобучение на C4, затем дообучение на отобранной коллекции Jina из 40+ специализированных датасетов пар предложений с отбором трудных негативов. Симметричное двунаправленное внимание гарантирует, что каждый токен учитывает и предшествующий, и последующий контекст, порождая представления, улавливающие глобальный смысл предложения. Средний пулинг по всем токеновым представлениям даёт финальный 768-мерный эмбеддинг.
Производительность
На момент релиза модель превзошла text-embedding-ada-002 от OpenAI на нескольких английских подзадачах MTEB: классификация (73,45 % против 70,93 %), ранжирование (85,38 % против 84,89 %), поиск (56,98 % против 56,32 %) и суммаризация (31,6 % против 30,8 %). Её контекст в 8 192 токенов стал значимым преимуществом перед конкурирующими моделями, ограниченными 512–2 048 токенами, и позволил искать на уровне документов без чанкинга. Компактный размер 307 МБ делал её разворачиваемой на потребительских GPU. В 2026 году jina-embeddings-v5-text-small (677M параметров, контекст 32K, task-специфичные LoRA-адаптеры) превосходит её для большинства продакшен-нагрузок, но она остаётся релевантной для лёгких англоязычных конвейеров.
Рекомендации
Используйте эту модель для поиска только на английском, когда контекстное окно в 8K достаточно и не нужны мультиязычные или task-специфичные адаптеры. Для документов свыше 8 192 токенов применяйте семантический чанкинг перед эмбеддингом. Модель интегрируется с основными векторными базами данных (Qdrant, Weaviate, MongoDB Atlas, Milvus) и RAG-фреймворками (LangChain, LlamaIndex, Haystack). Для новых проектов, требующих мультиязычности, контекста 32K или task-специфичной оптимизации, предпочитайте jina-embeddings-v5-text-small. Для продакшена рекомендуется GPU с поддержкой CUDA; инференс на CPU возможен, но заметно медленнее.


