Эмбеддинги
 Исследовательская лицензия Qwen
jina-embeddings-v4
Qwen Research License GGUF
 API Jina AI
 Hugging Face
 Air-gapped
Обзор
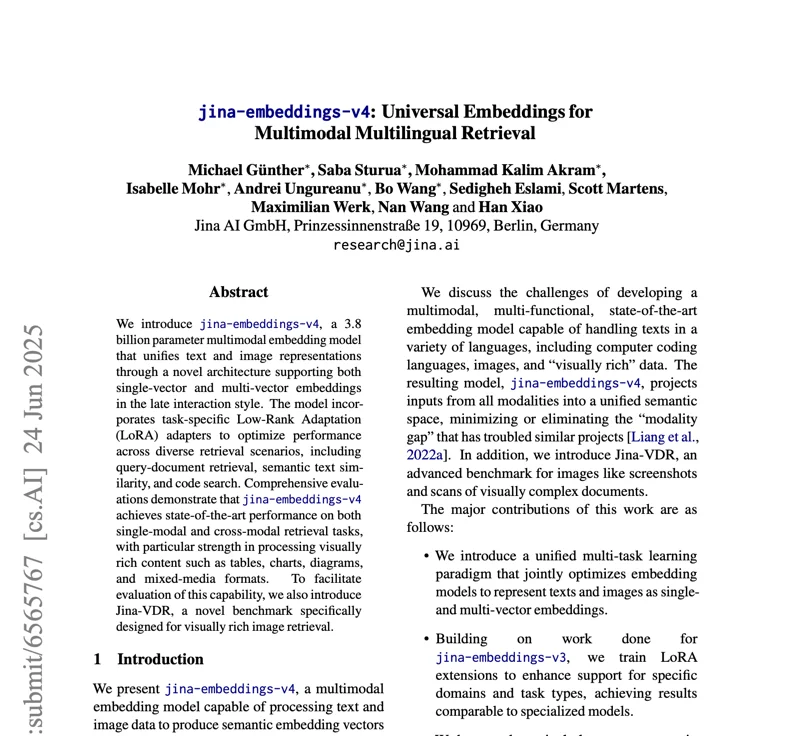
jina-embeddings-v4 — мультимодальная embedding-модель на 3,8B параметров, объединяющая представления текста и изображений в одной архитектуре. Она уникально поддерживает как режим одно-векторного (dense), так и режим мульти-векторного (late-interaction/в стиле ColBERT) вывода, позволяя командам балансировать эффективность индексации и точность поиска без смены модели. Модель достигает state-of-the-art качества на retrieval визуально насыщенных документов, нативно обрабатывая таблицы, диаграммы, схемы и мультимедийные форматы.
Методы
Архитектура объединяет крупный трансформерный энкодер-бэкбон с vision-энкодером на базе Qwen2.5-VL, обрабатывая текст (до 32K токенов) и изображения (768×28×28 патчи) через общие слои внимания. Три task-специфичных LoRA-адаптера (по 60M параметров каждый) специализируют модель на: асимметричном query-document поиске, семантической текстовой схожести и поиске кода. Двойной дизайн вывода — ключевая инновация: модель может формировать единый 2048-мерный dense-вектор (для быстрого ANN-индексирования с обрезкой Matryoshka до 128 измерений) или набор 128-мерных токен-векторов для late-interaction scoring. Обучение использовало двухстадийную программу: совместный контрастный pretraining на парах текст-изображение и текст-текст, затем обучение task-специфичных LoRA-адаптеров. Поддерживается late chunking для документов, превышающих 32K-токенное контекстное окно. Действует Qwen Research License.
Производительность
На JinaVDR (Visual Document Retrieval) модель набирает в среднем 72,19, против 64,50 у ColPali-v1.2. На ViDoRe она достигает в среднем 84,11 (90,17 в режиме мульти-вектора), против 83,90 у ColPali. Cross-modal retrieval достигает 84,11 на бенчмарке CLIP, превосходя jina-clip-v2 (81,12) и nllb-clip-large-siglip (83,19). Показатели text retrieval: 55,97 на MTEB-en, 66,49 на MMTEB, 67,11 на LongEmbed (против 55,66 у jina-embeddings-v3). Семантическая схожесть достигает 85,89 на English STS и 72,70 на мультиязычном STS. Поиск кода набирает 71,59 на CoIR. Cross-modal alignment достигает 0,71 косинусной схожести (против 0,15 у OpenAI CLIP). Режим мульти-вектора последовательно превосходит режим одно-вектора на визуально насыщенных задачах; режим одно-вектора обеспечивает эффективные результаты для стандартного text retrieval.
Руководство
Выбирайте режим вывода в зависимости от конвейера: одновекторный режим для масштабного ANN-индексирования (доступна обрезка Matryoshka до 128–512 измерений), мультивекторный режим для пере-ранжирования top-k кандидатов на визуально насыщенных документах. Выбирайте LoRA-адаптер через параметр task API: 'retrieval' для query-document поиска, 'text-matching' для семантической схожести, 'code' для поиска кода. Для документов, превышающих 32K токенов, используйте `late_chunking. Оверхед 60M параметров на LoRA-адаптер незначителен (<2 % увеличения памяти), и все три адаптера можно загрузить одновременно. Модель лицензирована под Qwen Research License (коммерческое использование без коммерческой лицензии не допускается). Для продакшн-развёртываний используйте CUDA-GPU; модель доступна через Jina API, AWS, Azure и маркетплейсы GCP. Для чисто текстовых задач jina-embeddings-v5-text-small` предлагает лучшую точность на параметр за долю вычислительных затрат.