

 向量模型
 Apache 2.0 许可证
jina-embeddings-v2-base-es
Apache-2.0 Jina API
 AWS SageMaker
 微软云
 Hugging Face
 物理隔离
 arXiv
概述
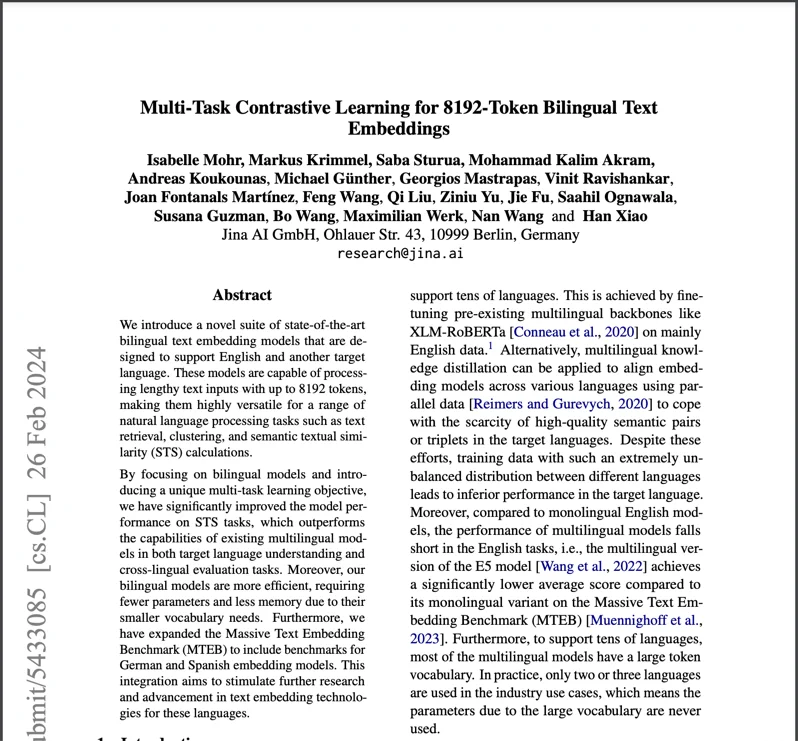
jina-embeddings-v2-base-es 是一个 161M 参数的西英双语文本向量模型,具有 8,192 token 的上下文窗口和 768 维输出。它面向西班牙语市场的跨语言检索而设计,将语义等价的西语英语内容映射到共享的向量空间。该模型解决了一个关键缺口:当时大多数向量模型以英语为中心,西语性能显著下降。
方法
该模型使用带有对称双向 ALiBi 位置编码的 BERT 骨干、161M 参数和 768 维输出空间。训练遵循三阶段流程:(1) 西英平行语料库上的预训练,(2) 精选句对上的含困难负样本挖掘的对比微调,(3) 确保同一概念的西语英语表示聚集在一起的跨语言对齐。ALiBi 机制在不使用学习位置编码的情况下实现了 8,192 token 的上下文,使模型能外推超过其 512 token 训练长度。平均池化产生最终的向量。
性能
该模型在西班牙英语检索任务上显著超过更大的多语言模型(E5、BGE-M3),而仅为其大小的 15–30%。它在 MTEB 西语子任务上表现出色,尤其在检索和聚类方面。8,192 token 的上下文窗口在多页文档上提供了稳定的性能,而大多数竞争模型需要分块。2026 年,jina-embeddings-v5-text-small 取代该模型,提供 89 种语言、32K 上下文和任务特定 LoRA 适配器。v2-base-es 模型仍是专用西英流水线的经济实惠选择。
最佳实践
非常适合西英双语搜索、内容推荐和跨语言文档分析。对于超过 8,192 token 的文档,使用语义分块或通过 Jina API 的 `late_chunking 参数。该模型可与主要向量数据库和 RAG 框架集成。对于需要西英之外多语言覆盖、32K 上下文或任务特定优化的新项目,请优先使用 jina-embeddings-v5-text-small`。生产环境建议使用支持 CUDA 的 GPU。输入文本应为西班牙语或英语;支持混合语言输入,但性能针对两种训练语言优化。


